
Serverless DeepDive #04:LambdaとFargateを同じjobで比較してみる
#03の商品登録jobを、Lambda、Fargateの常駐worker、1job1taskで動かしました。処理開始までの時間、処理中にtaskを止めたときのjobの状態、待機中の課金時間を実測し、jobを動かす実行基盤を選ぶ条件を整理します。
Series: Serverless DeepDive (13 articles)
- …
- 5Serverless DeepDive #04:LambdaとFargateを同じjobで比較してみる This article
#03 では、完了を待たずに受付を返してよいjobを考えました。今回は、そのjobをどこで動かすかを考えます。
候補は、Lambdaの関数と、Amazon ECS on AWS Fargateです。Fargateは、動かし続けるworkerと、jobごとに起動するtask(1job1task)の2通りを試しました。#00 では、常駐するprocessや、複数の処理にまたがる接続が要件ならFargateを考える、と書きました。その境目を、同じjobで確かめます。
Fargateでも、containerを動かすサーバーの管理はAWSに任せられます。ただし、taskをいつ起動して止めるか、jobをどう受け渡して再試行するかは、利用者が決めます。Lambdaでは、ここまでAWSが行います。
jobを1件ずつ続けて送ったときは、処理開始の速さにほぼ差がありませんでした。差が出たのは、処理中に止めたときのjobの扱いと、jobがない時間の課金です。料金表からの推計では、2.5秒のjobなら、1時間に約680件(public IPv4込みで約950件)までLambdaのほうが安くなります。
検証構成
jobの中身は#03と同じです。数量を検査し、指定した時間だけ待ち、S3へ状態と結果を書きます。jobのコード(job.cjs)は1つで、LambdaのcodeもFargateのimageも、CDKが同じdirectoryから作りました。
jobの届け方は3通りです。
- Lambda: PCから非同期Invoke(Event)で呼びます。
- 常駐worker: PCからSQSへ送ります。RunTaskで起動しておいたFargateのworkerが、long polling(今回は5秒待ち)で受け取ります。ECS Serviceは使っていません。
- 1job1task: PCからRunTaskでtaskを起動し、環境変数でjobを渡します。taskは1件処理して終わります。
| 条件 | 設定 |
|---|---|
| Region | ap-northeast-1(Tokyo) |
| Lambda | nodejs26.x(public Preview)、512 MB、arm64、timeout 30秒、非同期の再試行0回 |
| Fargate | ARM64、0.25 vCPU、512 MiB、stopTimeout 20秒、public subnet(NATなし、public IPあり)、image約145 MB(圧縮) |
| SQS | Standard queue、可視性timeout 60秒 |
| 通常のjob | quantity 2、workMs 2500(約2.5秒) |
| 状態の確認 | PCからS3を0.25秒間隔で読む |
stopTimeoutは、taskを止めるときにSIGTERMを送ってから、強制終了のSIGKILLまで待つ時間です。可視性timeoutは、受け取られたmessageを、他の受信者から隠しておく時間です。
Node.js 26は、検証時点でLambdaの最新のNode.js runtimeで、runtime一覧 ではpublic Previewです。SLAとTechnical Supportの対象外なので、本番では正式提供のruntimeで確かめ直す必要があります。
測定は2026-10-09に行いました。停止したECSのtaskはDescribeTasks で参照できる期間が限られ、撮影の前に消えていました。そのため図4と図5は、翌日に同じ手順を撮影用に1回ずつ実行した画面です。本文の数値は、2026-10-09の測定の値です。

図1:検証した構成です。jobのコードは共通で、jobの届け方と、taskとjobの止め方を変えました。
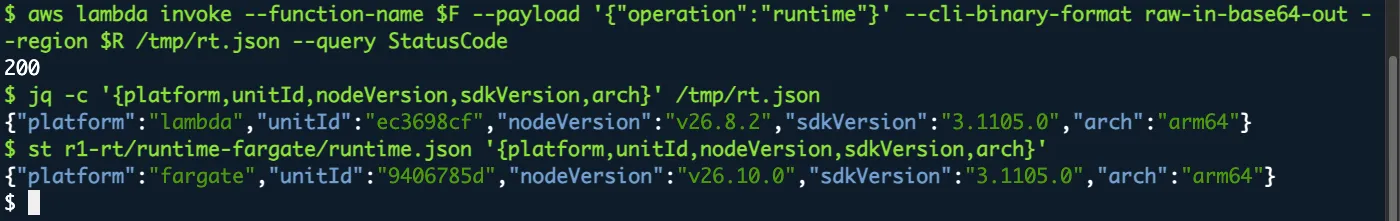
図2:撮影時にLambdaを1回呼んだ結果と、2026-10-09にFargateのtaskが書いた記録です。実行時のNode.jsは、Lambdaがv26.8.2、Fargateがv26.10.0でした(minor versionが違います)。stは、S3の記録をjqで抜き出す撮影用の関数です。
同じjobを18回ずつ処理する
通常のjobを、Lambdaと常駐workerへ18回ずつ送りました。前のjobの完了を確かめてから次を送る、1件ずつ続けて届く条件です。workerはいつも空いていて、jobが重なる場合は測っていません。
| 経路 | 処理中を確認するまで | 完了を確認するまで |
|---|---|---|
| Lambda(Event) | 中央値0.439秒(0.391〜0.715秒) | 中央値2.902秒 |
| 常駐worker(SQS) | 中央値0.374秒(0.357〜0.465秒) | 中央値2.841秒 |
時間は、PCで送信を始めてから、S3でその状態を読むまでです。差は中央値で約0.07秒で、確認の間隔の0.25秒より小さい値でした。1件ずつ続けて届く間は、処理開始の速さで選ぶ理由はありません。
新しい実行環境で始まると、Lambdaには初期化が加わります。比較の約11分後に送ったjobは、新しい実行環境で始まりました。初期化(Init Duration)に887.50 msかかり、処理中の確認まで1.691秒でした。常駐workerは、約6分空けた後も0.471秒でした。どちらも1回の観測です。
jobをまたいでmemory上の値を保つ点は、両方とも同じでした(図3)。違うのは、保つ期間を誰が決めるかです。workerのprocessは、taskを止めるまで動き続けます。Lambdaの実行環境は、呼ばれ続けていても、数時間ごとにAWSが終了します(実行環境のlifecycle )。

図3:比較の最初と最後のjobの記録です。Lambdaは18件とも同じ実行環境(d23f5f08)、workerも同じprocess(54e76659)で、件数を数え続けています。Lambdaの件数が2から始まるのは、比較の前にversionを確かめた呼び出しが1件あるためです。
1job1taskで起動してみる
jobごとにtaskを起動する方法を、6回試しました。RunTaskから処理中を確認するまで、中央値で約23秒かかりました。
| 区間 | 中央値 | 範囲 |
|---|---|---|
| RunTaskから処理中を確認するまで(PC) | 22.98秒 | 20.69〜28.76秒 |
| taskの作成からimageの取得開始まで(ECS) | 13.29秒 | 11.48〜15.67秒 |
| imageの取得(ECS) | 5.88秒 | 5.67〜11.02秒 |
| taskの作成からcontainerの開始まで(ECS) | 19.99秒 | 17.85〜25.91秒 |
2.5秒のjobに、約20秒の起動が加わります。imageの取得は約6秒で、取得を始めるまでの時間のほうが長くかかりました。
1件ごとに数十秒待てる長いjobなら、候補になります。Lambdaの1回の実行は最大15分 です。Decision Guide によると、Fargateのtaskには実行時間の厳密な上限がありません。15分を超えるjobは、今回は試していません。
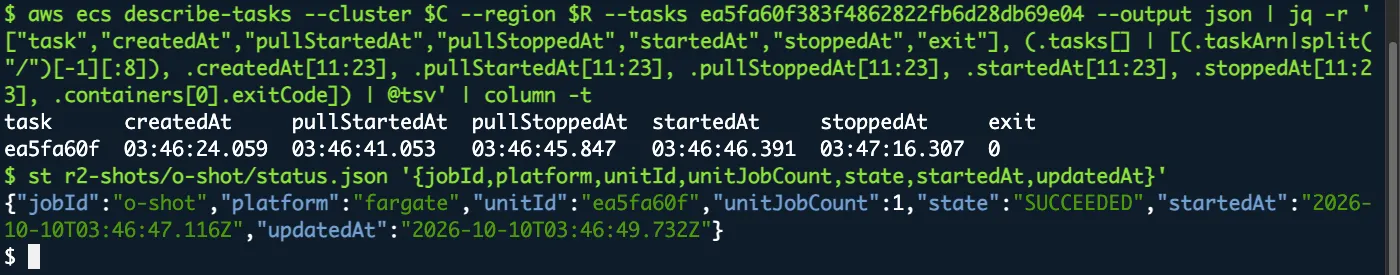
図4:翌日に撮影用に1回起動したtaskの記録です。表の6件とは別のtaskで、作成からimageの取得開始まで約17秒、取得に約5秒でした。exit codeは0です。時刻はUTCです。
処理中のworkerを止めてみる
常駐workerのtaskは、deployでの入れ替えや台数を減らすときのほか、AWSの保守でも止まります(Fargateのtask retirement )。今回は、StopTaskで、SIGTERMから強制終了までの手順を試しました。ECSはcontainerへSIGTERMを送り、stopTimeoutを過ぎても終わらなければ、SIGKILLで強制終了します(StopTask )。
workerはSIGTERMを受けると、新しいjobを受け取りません。処理中のjobは、続けるか手放すかを、jobごとに指定できるようにしました。手放すときは可視性timeoutを0にして、他のworkerがすぐ受け取れるようにします(SQSの可視性timeout )。
PCで処理中を確認してから約2秒後に、そのworkerを止めました。40秒のjobでは、もう1台のworkerを先に起動して待たせています。3つの条件を、各1回試しました。
| job | workerの扱い | 結果 | exit code | 停止の要求から2回目の試行の確認まで |
|---|---|---|---|---|
| 12秒 | 続ける | 猶予の20秒内に完了 | 0 | なし |
| 40秒 | 続ける | 強制終了。S3にRUNNINGが残る | 137 | 57.8秒 |
| 40秒 | 手放す | INTERRUPTEDを書いて終了 | 0 | 1.4秒 |
強制終了したjobのmessageは消されずに残り、可視性timeoutが切れてから別のworkerが受け取りました。PCで1回目と2回目の処理中を確認した間は59.8秒で、57.8秒の大部分は可視性timeoutの残りだと考えられます。手放した場合は、1.4秒で次のworkerに移りました(確認の間隔は0.5秒)。翌日の撮影用の実行でも、58.2秒と0.7秒でした。
この速さは、待たせていたworkerがあってのことです。worker 1台だけなら、代わりのworkerの起動を待ちます。今回、RunTaskからjobを受け取れるまでは25〜29秒でした。2台で待たせると、workerの費用は2倍になります。
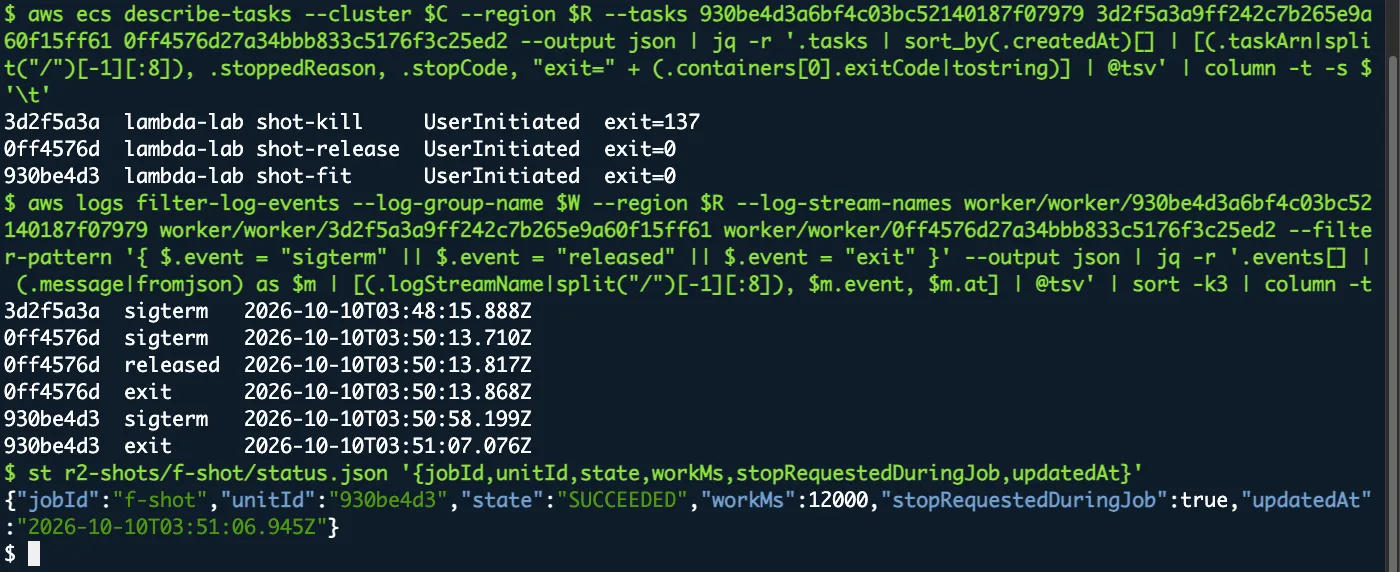
図5:翌日に撮影用に3条件を1回ずつ実行した記録です。上はECSの停止理由(shot-kill・shot-release・shot-fit)とexit code、中はworkerのログ、下はstopTimeout内に終わったjob(f-shot)の記録です。
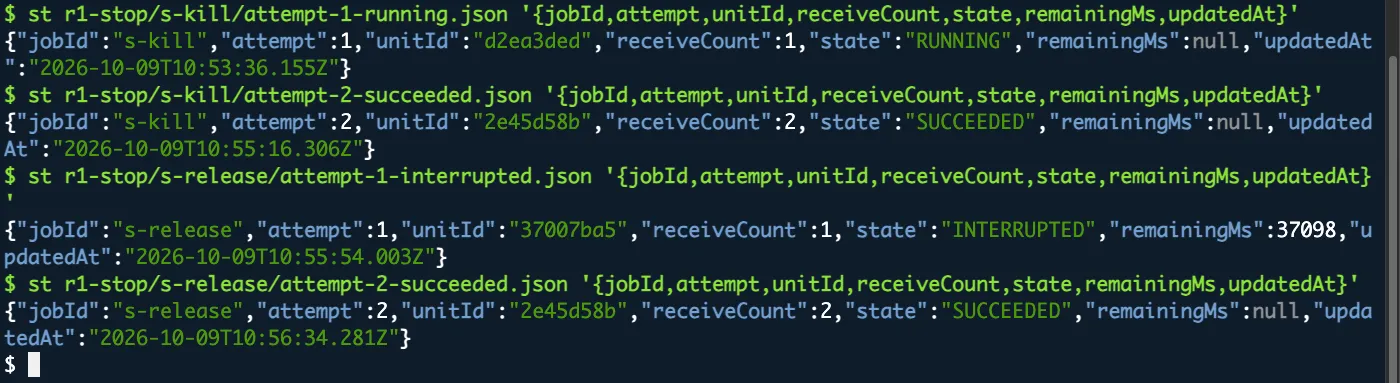
図6:2026-10-09の試行履歴です。強制終了された場合も、手放した場合も、2回目は別のworkerが受け取って成功しました。
手放すと再試行は早くなりますが、jobは最初からやり直しです。今回の2回目も、40秒すべてを処理しました。同じjobが2回動いても、結果が重ならない作りが要ります。SQSのStandard queueも、同じmessageを2回以上届けることがあります。
AWSが行うのは、SIGTERMを送り、猶予の後に止めるところまでです。続けるか、手放すか、RUNNINGのまま残ったjobをどう見つけるかは、利用者が決めます。#03でLambdaの同期Invokeがtimeoutしたときも、S3にRUNNINGが残りました。
処理中にLambdaの設定を変えてみる
Lambdaでは、deployにあたる関数の更新を、処理中に行いました。AWSの説明では、更新の間も関数はActiveのままで、呼び出しは更新が終わるまで以前のcodeと設定を使います(関数の状態 )。
20秒のjob(u-1)の処理中に、環境変数を1つ足しました。更新は1.6秒で終わり、u-1は同じ実行環境のまま続いて成功しました。停止の処理を書かなくても、処理中のjobは最後まで動きました(1回の観測)。
u-1の処理中に送ったu-2は、新しい実行環境で動きました。1つの実行環境は、同時に1件しか処理しないためです(Lambdaのscaling )。続くu-3は、u-2と同じ実行環境を使いました。設定の変更で実行環境が入れ替わるかは、分けて測れていません。

図7:設定を変えた前後の3件です。u-1は同じ実行環境で成功しました。u-2とu-3は、u-1とは別の、同じ実行環境で動きました。
コストを比べてみる
課金の仕組みが違います。Decision Guideによると、Lambdaはrequestの数と実行時間に課金され、使われていない待機の時間には課金されません。新しい実行環境の初期化の時間も、課金に入ります(INITの課金 )。Fargateは、imageの取得を始めてからtaskが終わるまでを秒単位で課金し、最低1分です(Fargateの料金 )。
測定でも、この違いが出ました。比較の18件のLambdaのBilled Durationは、合計48.9秒でした。常駐workerは、imageの取得開始から停止まで約520秒で、そのうちjobの処理は19件で59秒でした。残りのほとんどは、測定の合間のjob待ちです。
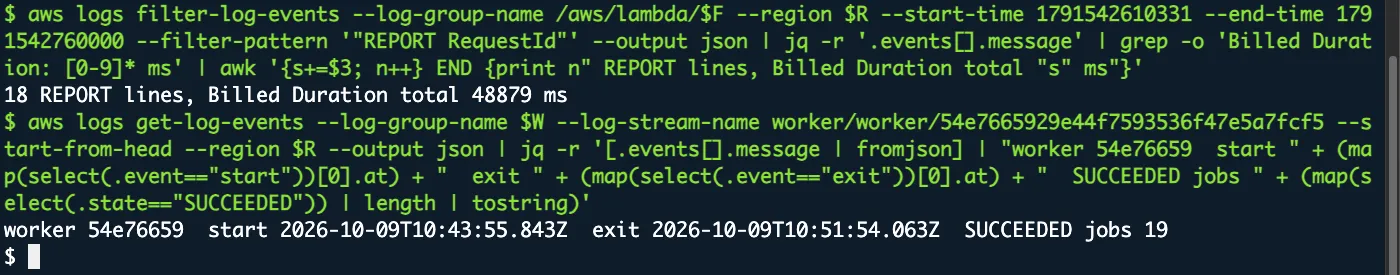
図8:Lambdaの比較18件のBilled Durationの合計と、常駐workerのログの最初と最後の時刻、処理したjobの件数です。workerの約520秒は、2026-10-09に保存したDescribeTasksの記録から求めました。
同じ条件で、月額に直しました。jobは今回の2.5秒(Billed Durationの中央値2.701秒)、Lambdaは512 MB、workerは0.25 vCPU・512 MiBの1台です。
| 1時間の件数 | Lambda | worker 1台 | worker 1台(public IPv4込み) |
|---|---|---|---|
| 10件 | 約0.13ドル | 約9.0ドル | 約12.6ドル |
| 100件 | 約1.3ドル | 約9.0ドル | 約12.6ドル |
| 680件 | 約9.0ドル | 約9.0ドル | 約12.6ドル |
| 950件 | 約12.6ドル | 約9.0ドル | 約12.6ドル |
| 約1,380件(1件ずつ処理するworker 1台の上限) | 約18.4ドル | 約9.0ドル | 約12.6ドル |
workerは、件数に関係なく月約9ドルです。Lambdaは件数に比例し、1時間に約680件(public IPv4込みで約950件)を超えると高くなります。これは、1台のworkerが時間の約半分(public IPv4込みなら約7割)を、jobの処理に使う量です。
月額は730時間で計算しました。単価は、2026-10-09にPrice List APIで取得したTokyoの値です。Lambda(arm64)は1 GB秒0.0000133334 USDと100万request 0.20 USD、Fargate(ARM)は1 vCPU時0.04045 USDと1 GB時0.00442 USD、public IPv4は1時間0.005 USDです。料金表からの推計で、実際の請求額ではありません。無料利用枠、新しい実行環境の初期化(今回は0.4〜0.9秒)、SQS・ログ・NAT Gatewayの料金は入れていません。jobが重なったときの待ちと、workerを増やす費用も入れていません。
まとめ
Lambdaが合うのは、jobが間を空けて届く場合です。待っている時間に課金されず、台数の管理もAWSに任せられます。今回は、処理中に関数を更新してもjobは止まりませんでした(1回の観測)。新しい実行環境で始まるjobには、初期化が加わります。
Fargateの常駐workerが合うのは、jobが絶えず届き、1台のworkerの時間の約半分以上(public IPv4を付けるなら約7割以上)を処理に使う場合です。jobごとの初期化の待ちもありません。稼働中の同じprocessで、jobをまたいで接続やcacheを使いたい場合も候補です。15分を超えるjobは、絶えず届くなら常駐worker、間を空けて届くなら1job1taskが候補になります。jobが重なったときの待ちは、今回は測っていません。
Fargateを選ぶと、Lambdaで任せていた仕事が利用者に戻ります。taskの起動と台数、jobの受け渡し、止まるときの処理、再試行までの時間です。どちらを選んでも、jobの状態はS3のような外部に置き、同じjobが2回動いても結果が重ならない作りにします。
Series: Serverless DeepDive (13 articles)
- …
- 5Serverless DeepDive #04:LambdaとFargateを同じjobで比較してみる This article
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article