
Serverless DeepDive #03:非同期Invokeのユースケースを探る
Lambdaの同期Invokeと非同期Invokeを同じworkerで比較しました。非同期で速くなるのは202が返るまでで、完了までの時間は同じでした。再試行とtimeoutの実測もあわせて、完了を待たずに受付を返していい処理を考えます。
Series: Serverless DeepDive (13 articles)
- …
- 4Serverless DeepDive #03:非同期Invokeのユースケースを探る This article
商品登録の依頼を受け、2秒以内に返答する場面を考えます。登録に2.5秒かかるなら、完了を待つ返答は間に合いません。先に受付を返し、後から結果を伝える方法が候補になります。
今回の検証では、Lambdaへの同期呼び出しと非同期呼び出しを比べました。非同期の返答は中央値0.049秒でした。一方、登録の完了確認は中央値約2.85秒後です。初回の処理を失敗させた1回の観測では、再試行後の完了確認に約55秒かかりました。
この記事で確かめるのは、どの業務なら、完了を待たずに受け付けを返せるかです。短い返答と、その後の失敗を扱う責任を一緒に考えます。
#02 では、SQSへ送る前に必要な検査を比べました。今回は受け付けた仕事の完了までを追います。Serverlessでは、実行基盤の管理をAWSへ任せます。Lambdaの関数 は、その基盤でイベントを受けてプログラムを動かします。基盤を任せた後に、受付の返答が何を約束するかを決めるのが今回のテーマです。
検証構成
架空の商品登録jobを使います。jobは、一つの処理依頼を表します。数量を検査し、指定した時間だけ待ち、S3へ登録結果を書き込みます。実際の在庫や決済には触れません。待機で所要時間を固定し、呼び出し方の違いを見ます。
Invoke API は、Lambdaを呼ぶためのAPIです。同期の
RequestResponseでは、関数の返答まで待ちます。非同期のEventでは、AWSがイベントを受け付けた段階で返答します。両経路は同じworker関数を使います。| 条件 | 設定 |
|---|---|
| Region | ap-northeast-1(Tokyo) |
| Runtime | nodejs26.x、実行時のNode.js v26.8.2、public Preview |
| worker | 256 MB、arm64、timeout 5秒、reserved concurrency 1 |
| 非同期の設定 | 再試行1回、最大event age 180秒 |
| 同期のログ取得 | LogType Tailで、応答に実行ログの末尾を含める |
| 通常の入力 | quantity 2、workMs 2500、failOnce false |
| 数量の許可範囲 | 整数1〜3 |
| 完了の条件 | result.jsonの保存後、status.jsonがSUCCEEDEDになる |
| 状態の確認 | PCからS3を0.4秒間隔で確認 |
reserved concurrency 1は、関数の同時実行を1件に制限する設定です。最大event ageは、非同期イベントを保持する最長時間です。
Node.js 26は、検証開始時にNode.jsで利用できる最新のmanaged runtimeでした。Tokyoで関数を作成し、実行できました。ただし、runtime一覧 ではPreviewです。SLAとTechnical Supportの対象外です。本番では正式提供のruntimeを選び、同じ条件を確かめ直す必要があります。
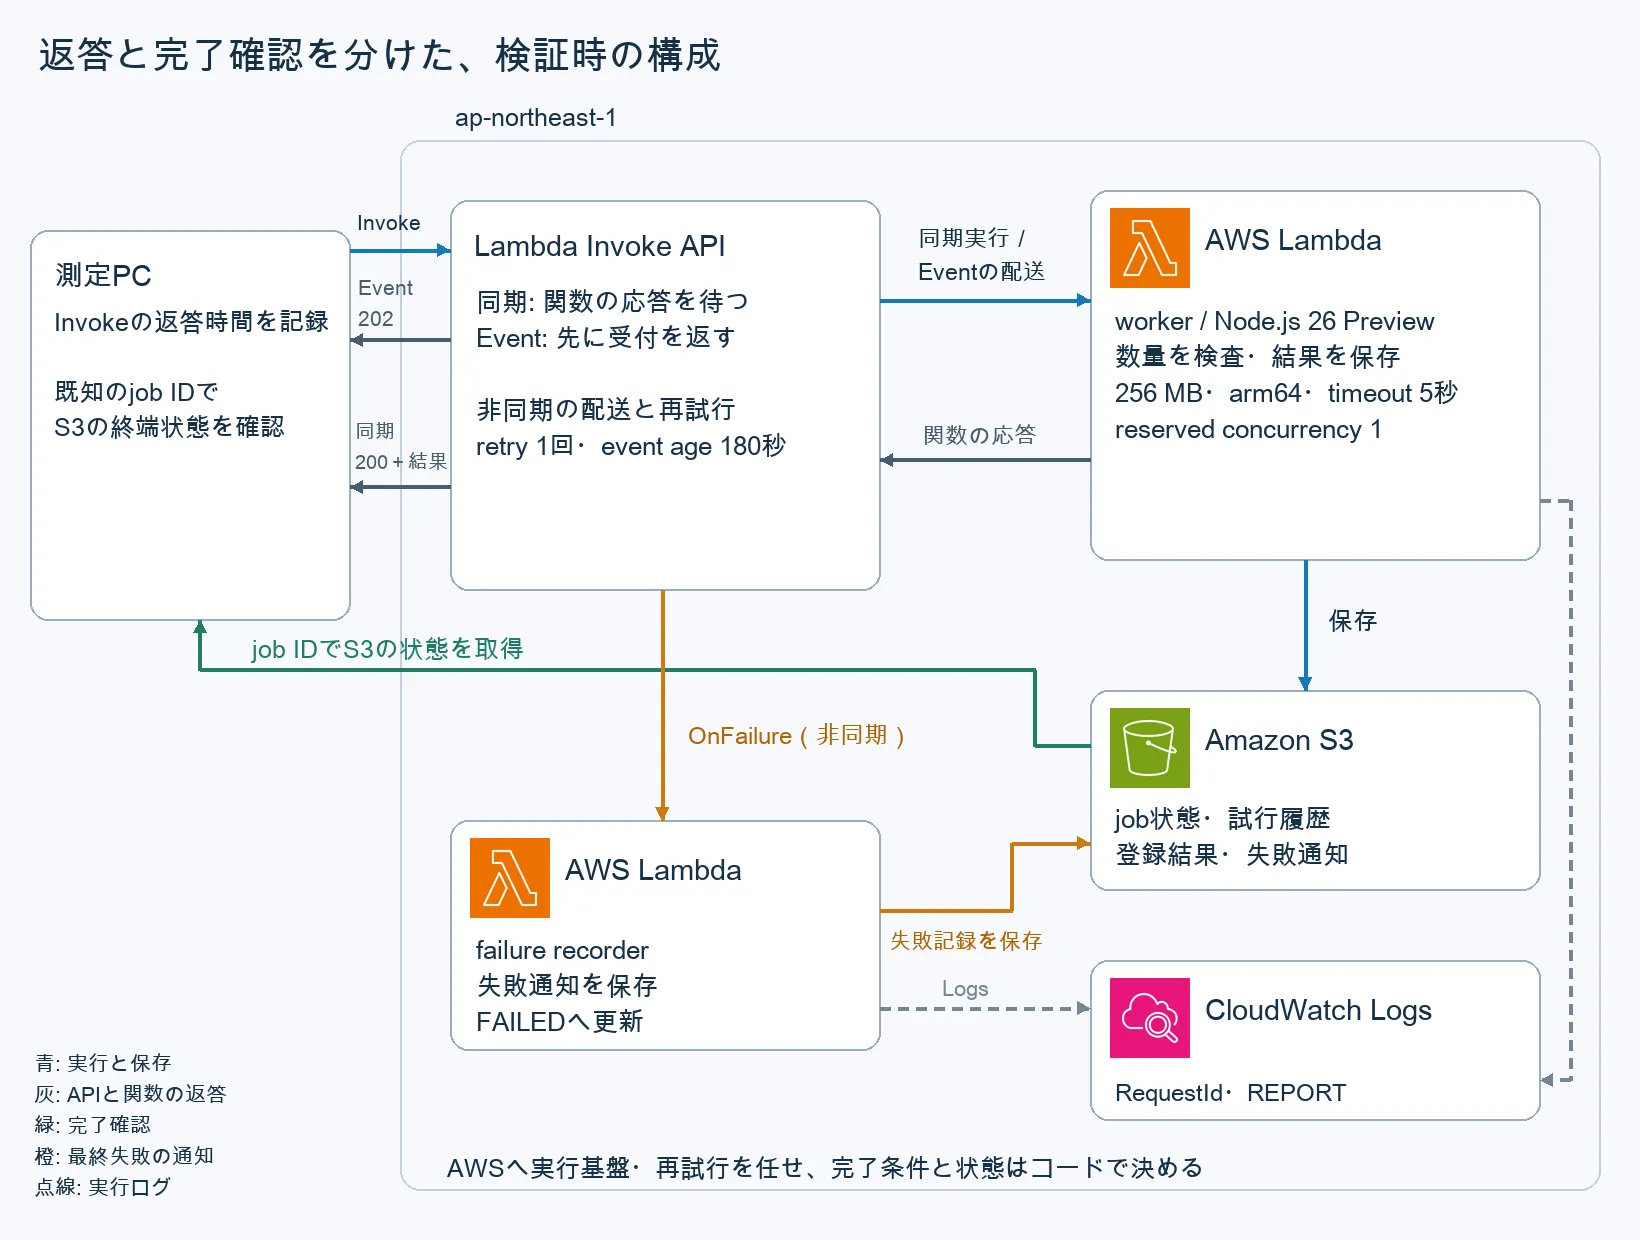
図1:検証した構成です。workerの実行基盤と非同期の配送をAWSへ任せ、完了条件と状態保存をコードで決めます。OnFailureは、非同期の最終失敗を別の関数へ渡す設定です。
job IDは呼び出し前にPCで決め、イベントへ入れます。202の応答本文は空です。PCが保持したjob IDを使い、S3の状態を探します。今回はPCで結果を読む方式です。利用者が後から結果を読む仕組みは、業務に合わせて用意します。
workerは、許可範囲の数量ならRUNNINGを書き、処理を始めます。成功時はSUCCEEDEDです。範囲外の数量は、RUNNINGを経ずにFAILEDを保存します。初回だけ例外を起こす試験では、例外の前にRETRYINGを残します。各状態にはjob ID、試行番号、時刻、RequestIdを付けます。RequestIdは、Lambdaの実行ログを追うための識別子です。
同期と非同期を18回ずつ比べる
通常の入力を、各経路へ18回ずつ送信しました。6回ずつの比較を3組行い、経路の順序も入れ替えました。jobごとに別IDを付け、前のjobの完了を確認してから次を送っています。
| 経路 | 返答までの中央値 | 返答までの最小〜最大 | 完了確認までの中央値 | 完了確認までの最小〜最大 |
|---|---|---|---|---|
| 同期 RequestResponse | 2.751秒 | 2.724〜3.367秒 | 2.845秒 | 2.814〜3.534秒 |
| 非同期 Event | 0.049秒 | 0.036〜0.089秒 | 2.847秒 | 2.798〜3.318秒 |
返答時間は、PCでInvokeを始めた時点から測ります。時刻が逆行しないmonotonic clockを使いました。応答bodyの読み取りと解析、PCへの保存も含みます。同期だけは、返されたログのデコードと保存も含みます。この処理の影響を分けて測ってはいません。
完了確認時間も、同じ開始点から測ります。S3の終端状態を読み、観測記録をPCへ保存するまでです。先の応答処理、通信、pollingの待ち時間も含みます。どちらも関数内の処理時間とは区別します。
同期は18回とも、返答直後の状態取得でSUCCEEDEDを読めました。Eventは18回とも、その時点ではstatus.jsonがまだありませんでした。両経路の完了確認は、中央値で約2.85秒でした。
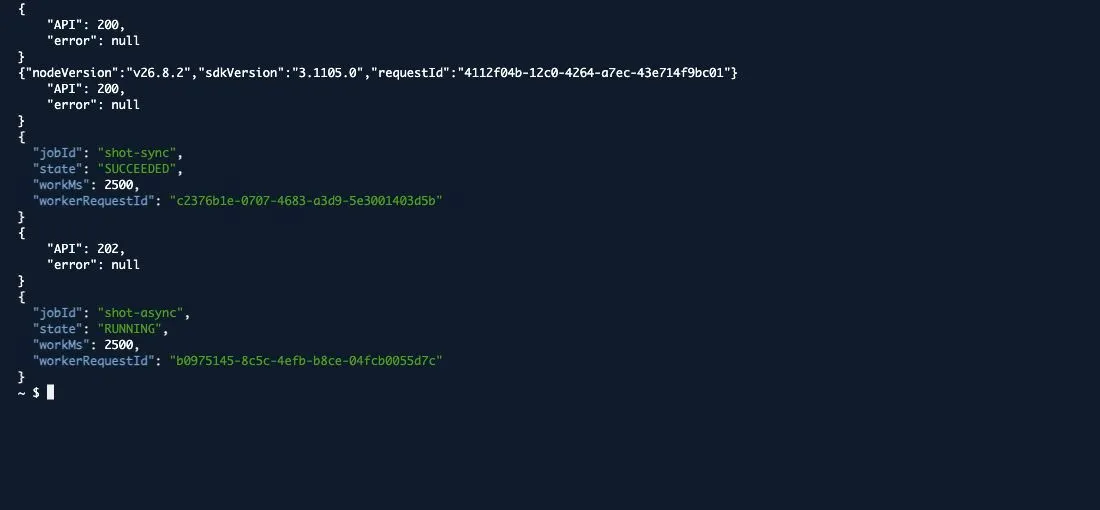
図2:撮影用に同じ入力を各経路へ1回ずつ送った結果です。通常の36回の集計とは別のjobです。先頭はNode.jsのversionを確認した別の呼び出しです。API 200とnodeVersionを表示しています。これも通常36回の集計に含めません。Eventの返答直後には、処理中のRUNNINGが読めました。状態が未作成か処理中かも、取得する時点で変わります。
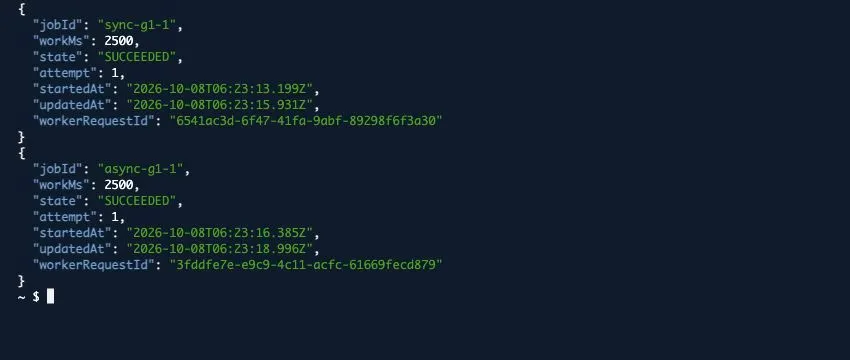
図3:通常比較の両jobの終端状態です。job IDとRequestIdで、入力と実行ログを対応させています。
この条件では、Eventの返答を2秒以内に受け取れました。登録の完了確認は同期と近い値です。受付を早める設計なら使えますが、2秒以内の登録完了を約束する根拠にはできません。
通常36回のREPORTには、Init Durationの記載がありませんでした。同期の最大3.367秒は、先頭のjobの値です。そのDurationは3325.64msで、固定待機2500msの外側に約826msかかっています。残り17回の返答は、2.724〜2.823秒に収まりました。この記録では、最大値をcold startと分類する根拠は得られません。
待機時間を短くしてみる
待機時間を短くして、同じworkerを動かしました。1.0秒、1.7秒、1.9秒の待機を、両経路へ各1回ずつ送っています。
| workMs | 同期の返答まで | Eventの返答まで |
|---|---|---|
| 1000 | 1.598秒 | 0.052秒 |
| 1700 | 1.974秒 | 0.048秒 |
| 1900 | 2.174秒 | 0.041秒 |
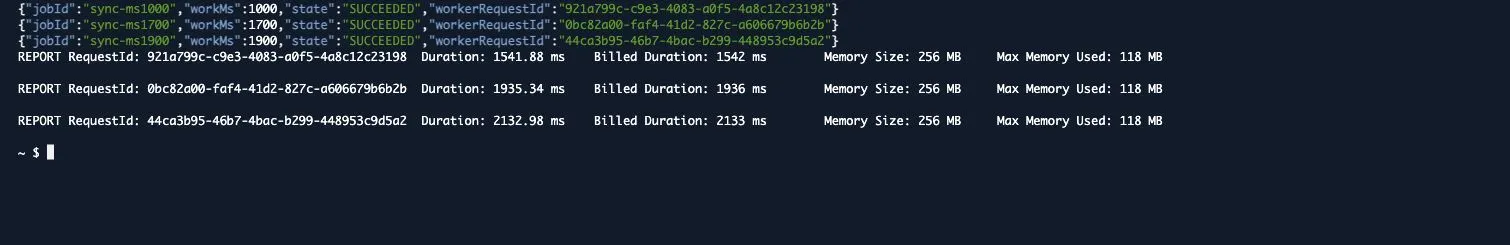
図4:S3の入力とCloudWatch Logsの実行時間を照合しました。REPORTのDurationは順に1541.88、1935.34、2132.98msです。表のPCから見た返答時間とは、測る範囲が異なります。
待機1.7秒の同期返答は2秒以内でした。待機1.9秒では超えています。workerは、待機のほかに状態の取得と複数回の保存も行います。通信も加わるため、待機時間だけを返答期限と比べると見誤ります。
各条件1回なので、1.7秒なら常に間に合うとは言えません。それでも、短い仕事なら同期で完了を返せる候補になります。利用者がその場で登録結果を必要とするなら、実際の負荷で応答の余裕を確かめる方が要件に合います。
数量の境界を確かめる
数量の下限と上限を確かめました。0、1、3、4を両経路へ各1回送り、待機を100msに変えています。
| quantity | 同期の応答と業務結果 | Eventの応答と後の状態 |
|---|---|---|
| 0 | API 200、ok false、FAILED | API 202、FAILED |
| 1 | API 200、ok true、SUCCEEDED | API 202、SUCCEEDED |
| 3 | API 200、ok true、SUCCEEDED | API 202、SUCCEEDED |
| 4 | API 200、ok false、FAILED | API 202、FAILED |

図5:数量の許可範囲は1〜3です。範囲外のjobにはquantity_out_of_rangeを保存しました。
範囲外の数量を、workerは通常の戻り値で拒否します。関数例外は出さず、FunctionErrorもありませんでした。8件とも試行は1回です。Lambdaにとって正常な実行でも、業務では拒否になるようにしています。
不正な数量は、待っても正しくなりません。業務の拒否と、一時的な処理失敗を分けると、直らない依頼の再試行を避けられます。この実装ではworker関数の中で数量を検査するため、Eventは先に202を返しました。受付時点で拒否を伝えたい要件なら、#02で扱った送信前の検査が必要になります。
初回だけ失敗させてみる
次に、数量2、待機100msのjobを使いました。両経路で、初回だけ保存前に例外を起こす試験を各1回行いました。例外の直前にはRETRYINGを保存します。
同期の初回は、API 200にFunctionErrorが付きました。Lambdaによる同期の自動再試行はありません。SDKの自動再送も無効にしています。状態を確認し、同じjob IDで手動再送すると、2回目にSUCCEEDEDになりました。
Eventは、最初の202を0.042秒で返しました。その後にworkerが失敗し、AWSが1回再試行しています。Invoke開始から55.025秒後に、2回目のSUCCEEDEDを確認できました。
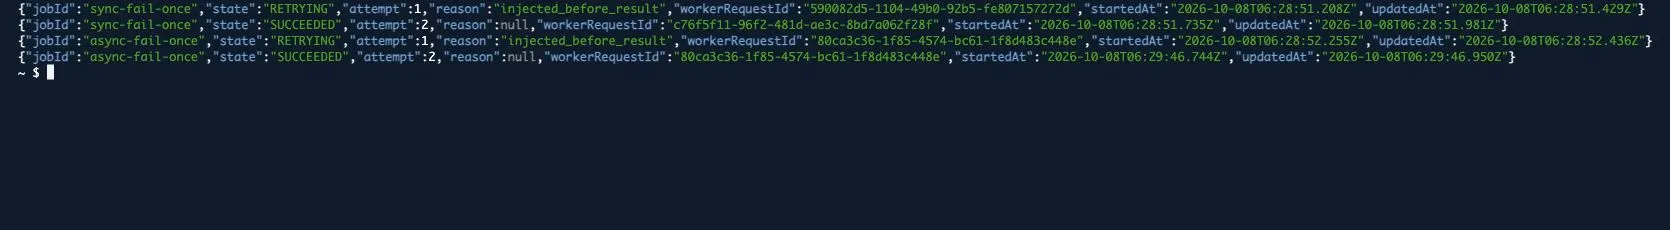
図6:初回の履歴と再試行後の履歴です。非同期では、二つの試行に同じRequestIdが記録されています。
非同期の開始時刻は、初回が06:28:52.255Z、2回目が06:29:46.744Zでした。約54.5秒離れています。今回の非同期では、RequestIdだけでは試行を区別できませんでした。job IDと試行番号、時刻も残したため、二つの実行を追えています。
AWSの仕様 では、関数errorの再試行は既定で2回です。待機は初回と2回目の間が1分、2回目と3回目の間が2分です。今回は再試行を1回、最大event ageを180秒に変えました。約55秒はこの設定での1回の観測で、固定の再試行間隔や完了期限には使えません。
#01 でも、同期の手動再送と非同期の同じRequestIdを観測しました。再試行の開始間隔は、保存前の例外で59.2秒、保存後で55.2秒です。今回、同じ測り方の値は54.5秒でした。入力とruntimeに加え、最大event ageも120秒から180秒へ変えています。条件が異なる値なので、固定の開始間隔の根拠にはしません。
今回は、受付から完了確認までの約55秒と、試行履歴を追いました。次に、関数のtimeoutを超えた場合を調べます。呼出元のread timeoutも、別に試します。#01で扱った冪等性の条件は、後でまとめます。冪等性は、同じ依頼を繰り返しても業務効果を重ねない仕組みです。
関数のtimeout
待機を6500msに延ばし、関数のtimeout 5秒を超える条件も試しました。両経路へ1回ずつ送っています。
同期は5.083秒でFunctionErrorを受け取りました。S3にはRUNNINGが残っています。実行が途中で止まり、workerがFAILEDを書けなかったためです。通常の例外処理だけでは、この停止を終端状態へ変えられません。
非同期は0.060秒で202を返しました。初回と再試行の両方がtimeoutしています。その後、OnFailureで受け取った記録を、別のfailure recorderがS3へ保存しました。Invoke開始から71.766秒後に、FAILEDを確認できました。
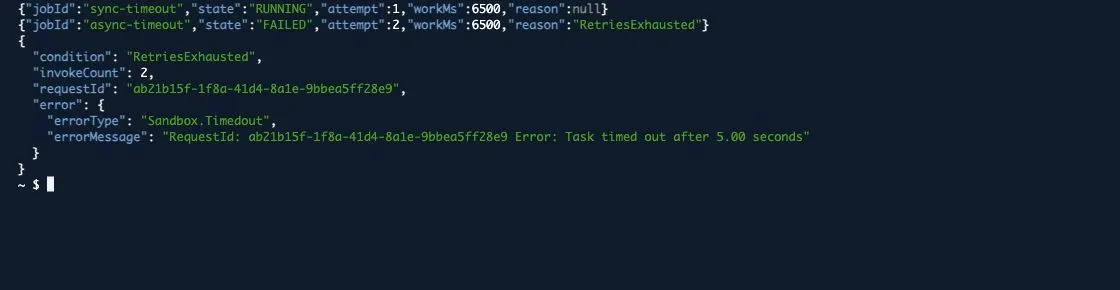
図7:非同期の通知にはRetriesExhaustedと、実行回数の概数2が入っています。画面は通知の抜粋です。requestContext.approximateInvokeCountをinvokeCount、responsePayloadをerrorという名前で表示しました。timeoutのエラーも、同じRequestIdで確認できます。
failure recorderは、workerと同じ256 MB、arm64、timeout 5秒です。再試行は0回、最大event ageは60秒にしています。workerのOnFailureは非同期呼び出し用なので、同期timeoutのRUNNINGは更新しませんでした。
失敗した呼び出しの記録を保持する設定 には、配送失敗の監視もあります。通知先へ送れない場合、LambdaはCloudWatchへ失敗回数を出します。監視に使うmetric名はDestinationDeliveryFailuresです。今回は通知が届き、状態を書けることを確認しました。
非同期配送の仕様 では、正常処理でも重複配送が起こり得ます。期限切れや全再試行の失敗では、イベントは破棄されます。処理が追い付かない場合、関数へ送られる前に削除されることもあります。
採用する際は、DestinationDeliveryFailuresを監視します。failure recorder関数のErrorsも確認します。Errorsは、関数の実行失敗を数えるmetricです。状態が未作成のjobや、長くRUNNINGのままのjobも探します。呼出元のjob IDと受付記録で、期限までに終わったかを照合します。再試行後の失敗を誰へ伝えるか、どこから再処理するかは業務側で決めます。約72秒という失敗確認の時間も、今回の再試行1回・最大event age 180秒での値です。その場で確定が必要な業務へ当てはめることはできません。
呼出元のtimeout
関数の実行期限とは別に、呼出元の通信期限も試しました。通常と同じ2500msのjobを同期で1回送り、SDKのread timeoutを1秒にします。自動再送は無効です。後の撮影用のCLI試験も1回です。
PCでは1.053秒後にReadTimeoutErrorが出ました。この値はInvoke開始から、例外を受けるまでの時間です。Invokeの応答を読めていないので、その時点で登録の成否は分かりません。同じjob IDの状態を追うと、3.939秒後にSUCCEEDEDを確認できました。
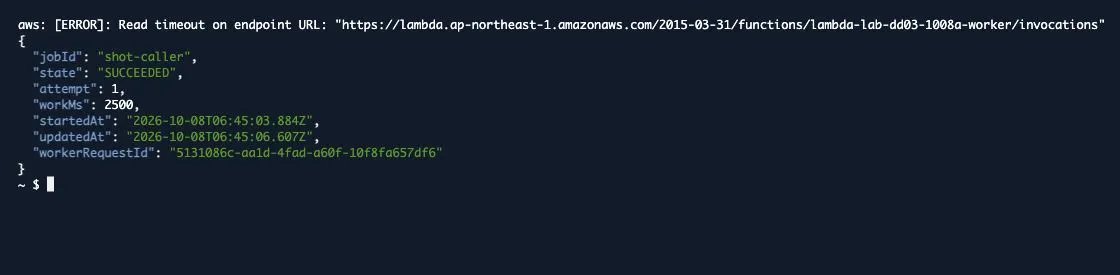
図8:撮影用にCLIでも1回確かめた結果です。CLIのread timeoutは1秒です。AWS_MAX_ATTEMPTS=1で自動再送を無効にしています。3秒待ってから、同じjob IDの状態を取得しました。上のSDK測定とは別のjobです。
この条件では、呼出元が待つのをやめても、workerは登録結果を保存しました。timeoutを「登録に失敗した」と決めて再送すると、完了済みの仕事へ新たな依頼を重ねるおそれがあります。まず既知のjob IDで状態を照合する設計が必要になります。
今回の比較に含めた負荷は、別IDのjobを一つずつ送る条件です。backlog、同時実行数を増やした場合、p99、意図的なcold startは未測定です。既定の再試行設定での完了時間も、集計の対象外です。通知先の障害・権限不足、未配送、期限切れを起こす試験は省いています。運用工数と費用の差も、今回の判断の根拠には含めません。
まとめ
今回の2.5秒の仕事では、Eventの返答が2秒以内に収まりました。再試行をAWSへ任せ、timeout後のjobの失敗を別の関数で残せました。受付を早く返し、約72秒後の最終失敗まで追えたことが、今回の条件でLambdaを選ぶ理由になります。
そのためには、利用者が後から結果を確認できることが必要です。商品登録の一括依頼なら、「受け付けました」と「登録できました」を分け、失敗した行を後から直す、という要件を設計候補にできます。正常時の中央値約2.85秒だけでは、期限を決められません。最大約3.5秒まで観測しました。この最大値も、期限の上限を保証するものではありません。利用者に伝える期限は、正常時の幅に加え、再試行や最終失敗までの待ち時間を考えて決めます。この業務での適合性は、今回の架空のjobから導く設計上の判断です。
同時に、job IDと状態の保持、結果の通知、停滞したjobの照合、再処理の判断を用意します。
今回のworkerは、既存の状態がSUCCEEDEDでも同じjobを再実行します。受付から完了確認までを見る実験用のコードとして、冪等化を省いています。S3の状態更新も、readとwriteを順に行うだけです。同じjobの同時更新を排除するtransactionはありません。reserved concurrency 1にしても、重複配送や業務効果の重複は防げません。本番の在庫確保や決済に使うなら、#01の条件付き保存と既存結果の照合を出発点にします。外部処理後の再送や、同じjobの同時更新も、対象の業務で確かめます。
その場で在庫の確保や支払いの確定が必要なら、202だけを成功の返答にはできません。同期で期限内に終える条件を探すか、受付待ちを許せる業務の流れへ変える必要があります。完了を待たずに返せる業務は、後の失敗まで含めて結果を伝えられる業務です。その約束を作れるかどうかが、非同期のLambdaを選ぶ条件になります。
Series: Serverless DeepDive (13 articles)
- …
- 4Serverless DeepDive #03:非同期Invokeのユースケースを探る This article
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article