

在 AWS 上构建生产级多智能体系统的 6 条经验
提示词(prompt)是一个请求,模型可以不听。护栏(guardrail)是一种控制,模型绕不过去。 要构建一个让人信得过的多智能体系统,大部分工作就是把规则从前一种变成后一种。本文介绍我们在 COBRA 中是怎么做的。COBRA 是我为销售团队构建的多智能体系统,它把一封自由文本的采购邮件转成一份带价格的 AWS 物料清单(Bill of Materials,BOM),以及一个共享的 AWS Pricing Calculator 链接。COBRA 最初在 Amazon Quick Automate 上投入生产。我们在 Amazon Bedrock AgentCore 和 AWS Lambda 上重建了它,
问题:只靠代码解决不了的三件事
下面是销售代表转给我们的一个典型请求(仅作示例,名称已修改):

邮件里的三个短语说明了为什么我们需要智能体,而不只是一个脚本:
- "AWS calculator link":没有 API 可用。 客户要的是一个公开的
calculator.aws链接,只有 Pricing Calculator 网页界面能生成。Price List API 返回的是价格,不是链接;较新的 Pricing Calculator API 是在 AWS 账户内创建估算,通过 IAM 共享,也不是公开链接。固定的界面脚本在页面每次改版时都会失效,所以定价这一步是一个浏览器智能体,按页面当前的样子去读取和操作。
- "DR" 和 "high security":需求写在自由文本里。 销售代表不知道这些词对应哪些 AWS 服务,固定规则也无法覆盖人们的各种写法。邮件里甚至没有写数据库引擎。
- "Check it against AWS":需要对照文档核对。 以前由工程师把客户的规格逐行对照 AWS 文档,每份报价大约要花半天。
用户看到的是什么
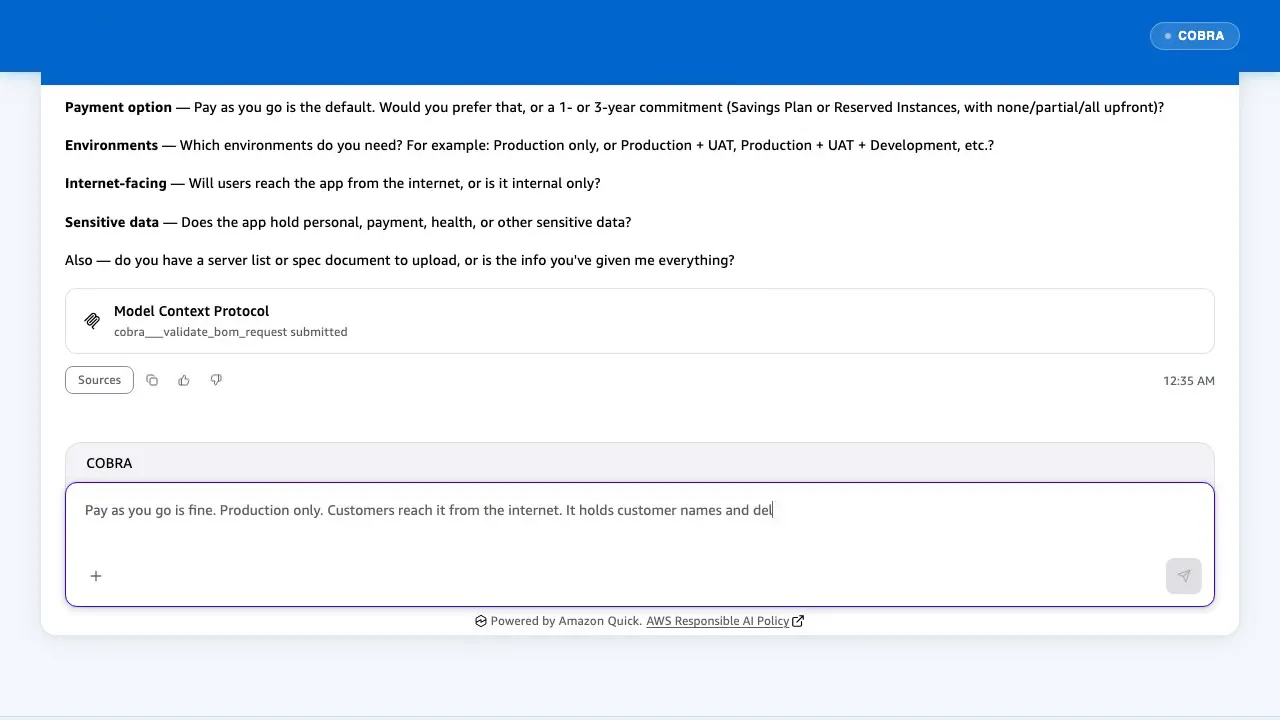
销售代表把请求粘贴到 Amazon Quick 聊天中。COBRA 只问缺少的信息,例如付款方式(除非销售代表另有说明,否则按需付费),以及应用是否面向互联网。没有安全默认值的信息,例如数据库引擎,则是必须回答才能继续的问题。
几分钟后(这次大约 5 分钟),销售代表会收到一封邮件,里面是 BOM 页面。页面显示每月费用、每条假设及其原因(例如,因为应用面向公网,所以加入了 AWS WAF)、可以直接转发给经销商的文字,以及共享的 AWS Pricing Calculator 链接。计算器中的每一行都标注了 BOM ID。

演示是容易的部分。本文其余内容讲的是哪些地方花了最长时间才做到可信。
架构
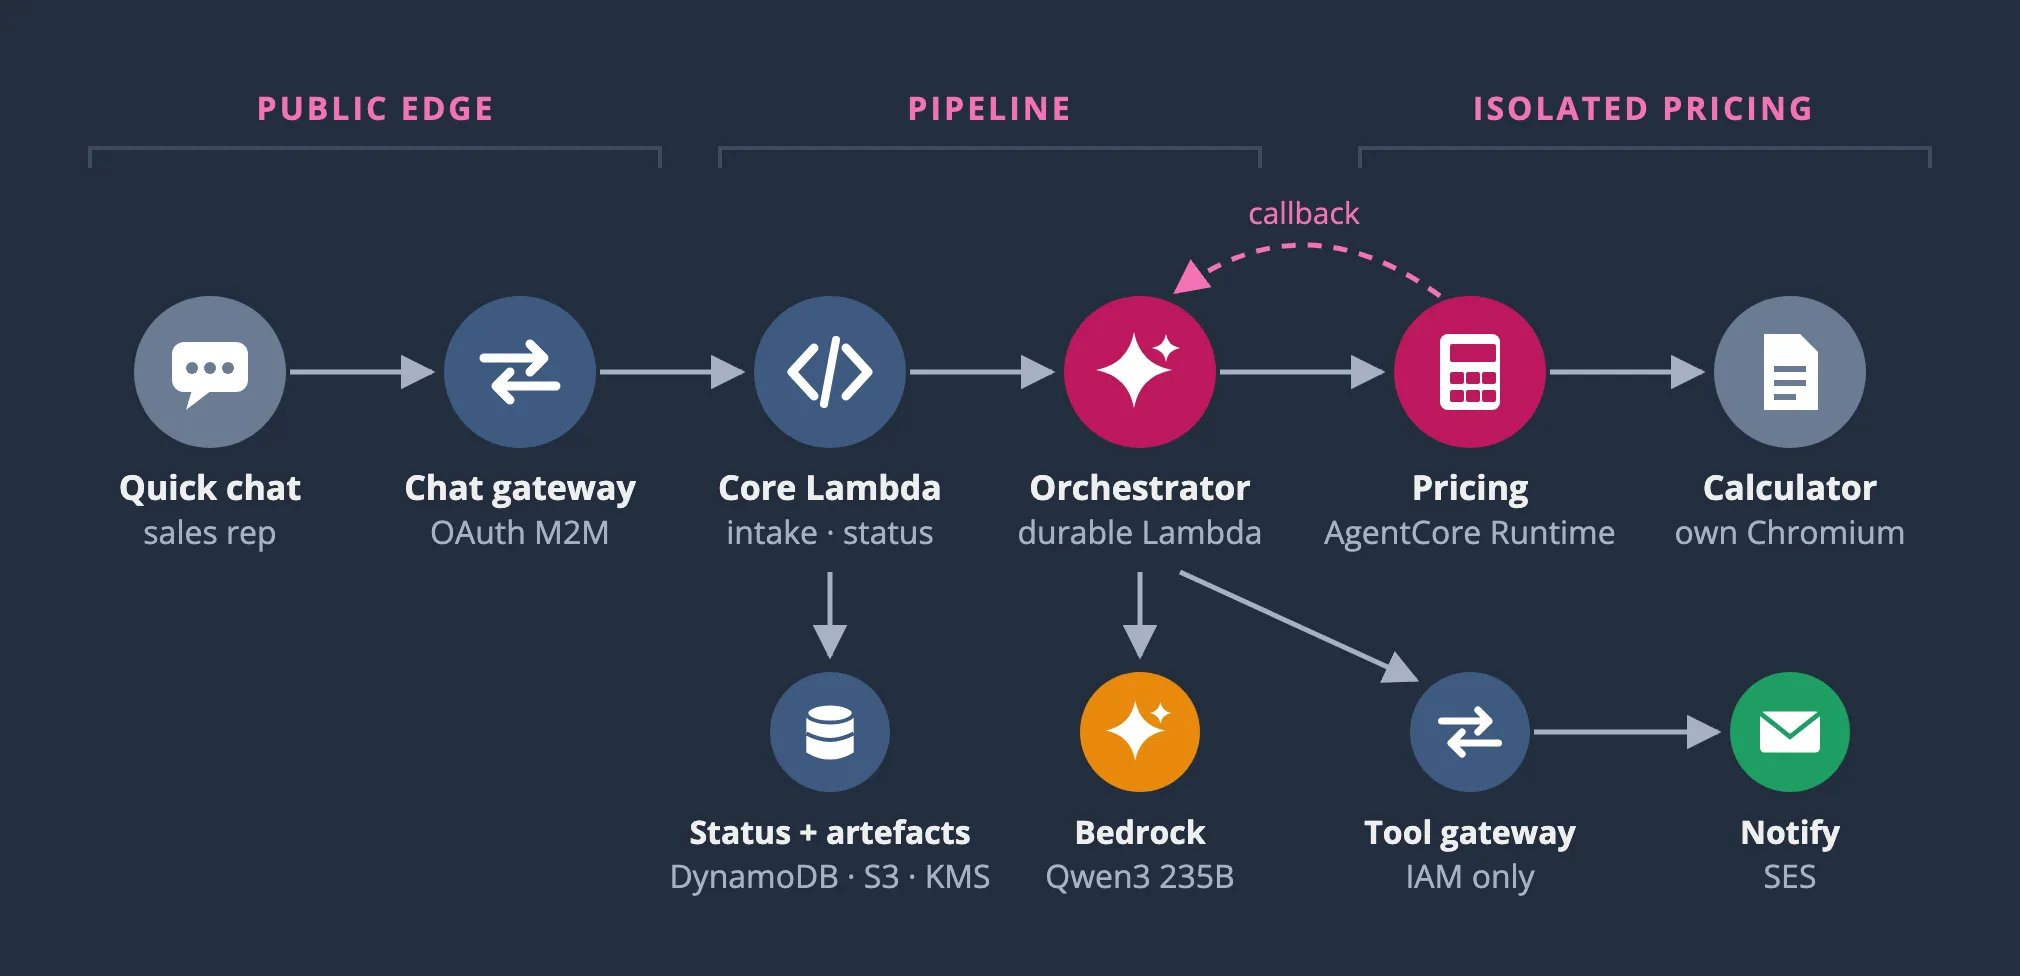
请求路径,从左到右:
- Amazon Quick 聊天:销售代表在这里与 COBRA 对话。
- 聊天网关:一个 AgentCore Gateway ,放在聊天可以调用的工具前面。它使用 OAuth 和 Amazon Cognito 机器对机器(M2M)凭证,所以网关认证的是 Quick 连接器,而不是销售代表本人。
- 核心 Lambda 函数:负责接收请求和查询状态。
- 编排器:一个 Lambda 持久函数(durable function) ,按顺序运行各个阶段。持久函数在每一步之后保存进度,等待期间可以暂停且不产生计算费用,最长可以运行一年。
- 定价:一个浏览器智能体,运行在自己的 AgentCore Runtime 中,在我们自己容器内的 Chromium 里操作 Pricing Calculator,完成后回调编排器。
支撑服务:状态和中间产物存放在 Amazon DynamoDB 和 Amazon S3 中,使用同一个 AWS KMS 密钥加密;模型由 Amazon Bedrock 提供;还有第二个网关,只接受 IAM 签名的调用,用于内部工具,例如通知(Amazon SES)和费用估算器。
系统分为三个信任区:公网入口用 OAuth,每个 Runtime 一个 IAM 角色,内部工具只接受 IAM。LLM 任务完全没有工具。 每个任务只返回 JSON,由代码检查后再执行。即使是浏览器智能体,也只能从一个固定列表中选择下一步操作;由代码在页面上执行,并检查该行是否已添加。模型负责提议,代码负责执行。
经验 1:在输出可以被检查的地方拆分
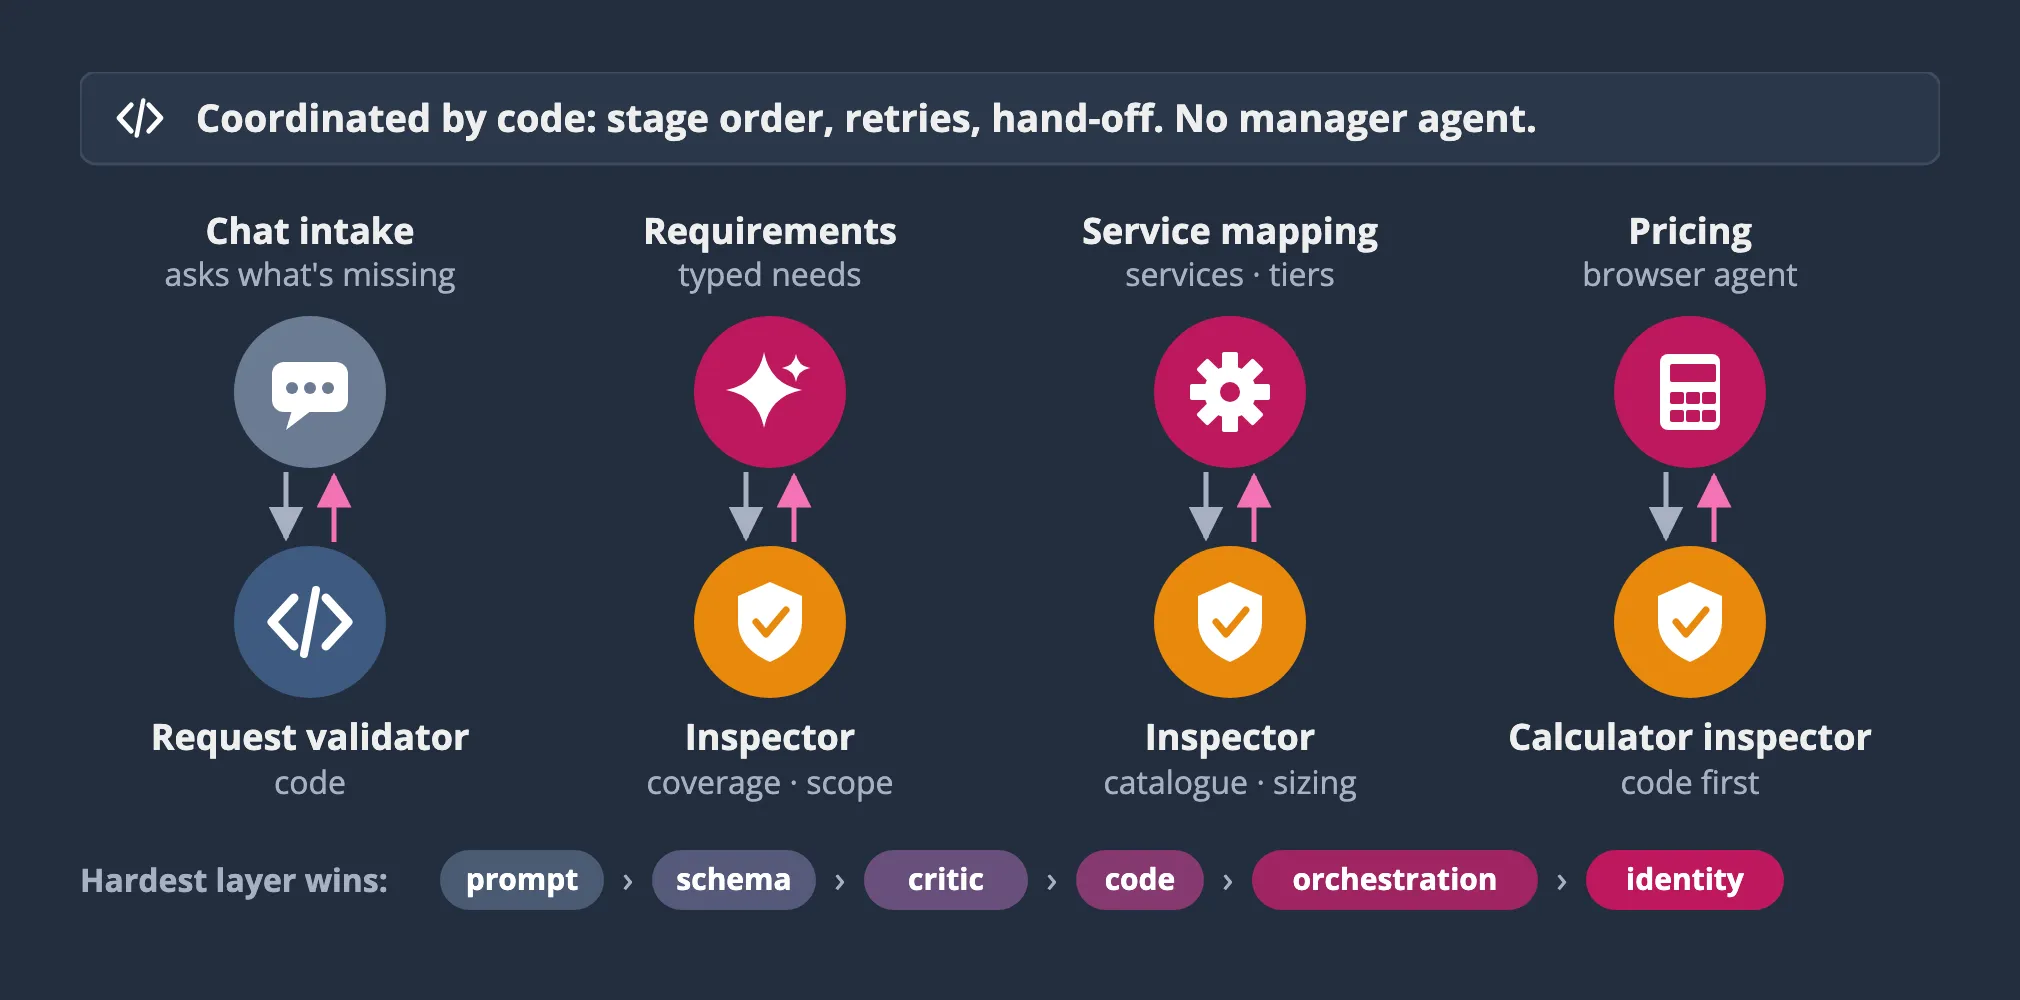
COBRA 有四个智能体。每个智能体都配有一个评审者(critic)(我们也叫它检查器,inspector):一个独立的检查,读取智能体的输出,按照写好的规则返回通过或不通过。有的评审者是纯代码,有的是外面包着代码的 LLM。
智能体 | 产出 | 对应的评审者 |
|---|---|---|
聊天收集 | 一个完整、有效的请求 | 请求校验器(代码) |
需求 | 带类型的需求,每条都引用原文 | 检查器:覆盖范围和边界 |
服务映射 | AWS 服务、规格和区域 | 检查器:服务目录和规格大小 |
定价(浏览器智能体) | 一个共享的计算器估算 | 计算器检查器,先用代码 |
这里有两个关键选择。
协调用代码,不用管理者智能体。 阶段顺序、重试和交接都是确定的,所以放在编排器里。管理者智能体需要掌握每个智能体的上下文,会成为瓶颈。
按输出能否被单独检查来拆分,而不是按岗位职责。 迁移中的两个例子:
- Quick Automate 流程中有一些 LLM 步骤,唯一的工作就是把固定字段写入状态记录。没有任何东西需要评审者判断,所以它们不是真正的拆分点,后来都改成了纯代码。
- 大型请求总是在需求阶段失败。我们把输入拆成块,每块评审者都可以单独检查,并且并行读取这些块。
图底部的那一条是整个设计背后的原则:把每条规则放在能执行它的最硬的一层。 下面是每一层中一条真实的 COBRA 规则,从最弱到最强:
层次 | 由什么执行 | 该层的一条 COBRA 规则 |
|---|---|---|
提示词 | 模型,如果它遵守指令 | 浏览器智能体只能访问 calculator.aws (已知缺口,见经验 5) |
Schema | 模型无法生成 Schema 之外的输出 | 选择的服务必须是我们服务目录中的一个值 |
评审者 | 第二道检查,通常是 LLM | 请求中的每个句子都被某条需求覆盖,或标注为非需求 |
代码 | 每次都给出相同答案 | 操作系统必须引用请求原文,否则为 not_stated (经验 2) |
编排 | 工作流,而不是任何智能体 | 阶段最多尝试 3 次,然后交给人;只有代码能修改 BOM 状态 |
身份 | IAM,在应用之外 | 每个 Runtime 有自己的 IAM 角色;内部工具只接受 IAM 签名的调用 |
评审者排在代码下面,是因为 LLM 评审者可能出错(经验 3 有一个例子)。代码对相同输入总是返回相同答案。能写成代码的规则,就写成代码。
经验 2:所有模型调用遵守同一份约定

COBRA 中每次 LLM 调用都经过同一个函数:
- 使用 Bedrock Converse,并在解码时强制 JSON Schema(通过
outputConfig实现 结构化输出 )。"解码时"的意思是模型只能生成符合 Schema 的 token,所以即使内容错了,结构也是对的,除非答案在 token 上限处被截断。代码仍然会检查 Schema。我们不依赖强制工具选择(forced tool choice)来约束输出格式,因为有一个模型在输入与 Schema 冲突时忽略了它。
- 代码中的校验器运行 Schema 检查、Python 业务规则,以及依据检查(grounding check):模型引用的文字必须真实出现在原文中。
- 错误以重新提问的方式返回给模型,每条错误按 JSON 路径列出,最多修复 2 次。之后,保留通过的条目并丢弃其余部分("salvage"),或者让这一步失败。
- 达到输出 token 上限立即失败。 没有可以修复的内容。
- 如果 Lambda 调用剩余时间少于 90 秒,就停下,在新的调用中重试。
- 校验通过的答案按步骤缓存到 S3。 持久函数恢复时会重放:从头再运行一遍代码,跳过已经完成的步骤。缓存覆盖的是超时或崩溃后再次运行的步骤,这样已经通过的模型调用不会重复执行,也不会重复付费。
这个函数的核心部分(已简化,省略了限流重试、缓存、时间检查和 salvage):
Python
import jsonimport boto3import jsonschemafrom botocore.config import Configbedrock = boto3.client("bedrock-runtime", config=Config(read_timeout=300)) # 长答案会超过默认的 60 秒class BudgetExceeded(Exception): ...class SchemaInvalid(Exception): ...def llm_call(task, model, system, user, schema, validate=None, max_repairs=2, max_tokens=6000):"""一个范围很窄的任务:解码时强制 Schema,然后代码校验,最多修复 2 次。"""validator = jsonschema.Draft202012Validator(schema)messages = [{"role": "user", "content": [{"text": user}]}]for _ in range(max_repairs + 1):resp = bedrock.converse(modelId=model, system=[{"text": system}], messages=messages,inferenceConfig={"maxTokens": max_tokens},outputConfig={"textFormat": {"type": "json_schema", "structure": {"jsonSchema": {"schema": json.dumps(schema), "name": "result", "description": "result"}}}})if resp["stopReason"] == "max_tokens":raise BudgetExceeded(task) # 答案被截断:没有可修复的内容text = "".join(c.get("text", "") for c in resp["output"]["message"]["content"])try:obj = json.loads(text)errors = [f"{'/'.join(map(str, e.absolute_path)) or '(root)'}: {e.message}"for e in validator.iter_errors(obj)]except json.JSONDecodeError as e:obj, errors = None, [f"(root): not valid JSON ({e.msg})"]if not errors and validate:errors = validate(obj) # 业务规则和依据检查,在代码中完成if not errors:return objmessages += [{"role": "assistant", "content": [{"text": text}]},{"role": "user", "content": [{"text": "Your answer has these problems. ""Return the full corrected JSON.\n- " + "\n- ".join(errors)}]}]raise SchemaInvalid(f"{task}: {errors[:3]}")
每个任务传入自己的
validate 函数,大部分护栏都在这个函数里。Schema 规则是测试,不是风格指南
我们吃过亏才学到三条 Schema 规则。只要任何一个主要任务的 Schema 违反其中一条,单元测试就会失败:
- 每个数组都有
maxItems。 没有它时,有一个模型一直循环输出,直到达到 token 上限。不同模型对 Schema 关键字的支持不同,所以一个模型只有在我们用强制结构化输出实际调用过之后,才会进入允许列表。
- Schema 中不使用数值边界(
minimum、maximum)。 Bedrock 结构化输出文档 列明它们不受支持。有一个模型还是接受了,然后一直输出空白直到上限。边界改在代码中检查。
- 引用字段放在决定字段之前。 我们要求先给出原文。这个顺序并不保证(有一个模型把引用写在决定之后),所以代码总是对照引用检查决定。
Python
def test_every_model_schema_follows_the_contract():seen = collect_task_schemas() # [(task, schema)]:运行主要 LLM 任务,并替换 llm_call 以记录 Schemadef walk(node, path):if isinstance(node, dict):assert not {"minimum", "maximum", "exclusiveMinimum", "exclusiveMaximum"} & set(node), pathif node.get("type") == "array":assert "maxItems" in node, pathfor k, v in node.items():walk(v, f"{path}/{k}")elif isinstance(node, list):for v in node:walk(v, path)for task, schema in seen:walk(schema, task)# 在每条提取的需求中,引用的原文排在由它决定的值之前req = next(s for t, s in seen if t == "extract_needs")["properties"]["needs"]["items"]["required"]for quote, decision in (("quantityText", "quantity"), ("osText", "osFamily"),("dbEngineText", "dbEngine"), ("deploymentText", "deployment")):assert req.index(quote) < req.index(decision)
一条规则如果不是一个会失败的测试,就只是一个建议。
护栏示例:代码只验证,不提取
引用字段在校验器中发挥作用。对需求智能体提取的每条需求,代码检查引用的文字确实出现在客户的那一行中,每个数字都写在它引用的证据里,以及操作系统这类决定有原文支持(根据我们的代码简化):
Python
def need_errors(n):"""代码检查一条带类型的需求。每个错误连同 JSON 路径返回给模型。"""errs, line = [], n["sourceLine"]for f in ("osText", "dbEngineText"):if n[f] and not grounded(n[f], line):errs.append(f"{f}: must be words from sourceLine")for k, m in enumerate(n["measures"]):if not grounded(m["evidence"], line):errs.append(f"measures/{k}/evidence: must be words from sourceLine")if m["value"] not in numbers_in(m["evidence"]):errs.append(f"measures/{k}/value: {m['value']:g} is not written in its evidence \"{m['evidence']}\"")if n["osFamily"] != "not_stated" and not n["osText"]:errs.append("osFamily: quote the words naming the operating system in osText, or use not_stated")if n["dbEngine"] != "not_stated" and not n["dbEngineText"]:errs.append("dbEngine: quote the words naming the engine in dbEngineText, or use not_stated")return errs
最后两项检查执行的规则,以前只是提示词里的一句话:"不要假定是 Linux"。如果请求没有写明操作系统,模型必须回答
not_stated ,然后在聊天中或之后在 BOM 页面上询问销售代表。COBRA 从不猜测操作系统。唯一映射到 "Linux" 的地方在计算器步骤,针对 Ubuntu 或 Rocky Linux 这类具体发行版,因为计算器里没有这些选项。经验 3:评审者先用代码检查
反思模式(reflection,一个生成者配一个评审者)是对我们帮助最大的技术。但如果评审者只是另一个被问"这个好不好?"的 LLM,它往往要么什么都通过,要么什么都不通过。

定价完成后,计算器检查器读取实时的共享计算器链接(从不读取导出文件),并逐行检查:
- 先用代码检查: 某行缺失或重复、区域错误、服务器设置与计划不符,或者费用与 AWS Price List API 的估算相差 5 倍以上。
- LLM 只判断会影响价格的设置。 请求中没有写明的设置、默认值,或数量为零的附加项,都不算失败。没有这条规则时,检查器把所有行都判为失败,阶段一直重试,直到用完预算。
- 由代码给出结论。 失败的行会在计算器中更正:原地修改,或者在缺失或重复时重新添加。如果模型判定某行失败,但这一行的费用已经和价格表估算一致,那可能是计划本身有问题,这一行会转给我们的团队处理。
评审者也会产生幻觉。我们的 LLM 检查器曾经给一个定价行判了失败,理由是:"She was the first woman to fly solo across the Atlantic."(她是第一位独自飞越大西洋的女性。)修复在代码中:声称的不匹配必须与请求有共同的词,否则退回。
Python
def ungrounded(requested, line):"""当声称不匹配中的 'requested' 一侧与该行的请求或计划没有任何共同词时,返回 True。"""claim = words(requested) # 小写词,去掉停用词source = words(json.dumps({k: line.get(k) for k in ("service", "request", "cobraSettings")}))return bool(claim) and not (claim & source)def validate(obj):errors = []for n, x in enumerate(obj["lines"]):x["verdict"] = "fail" if x["mismatches"] else "pass" # 由代码给出结论,而不是模型if x["verdict"] == "fail" and not x["fix"].strip():errors.append(f"lines/{n}: a fail needs its mismatches and a fix")for k, m in enumerate(x["mismatches"]):if ungrounded(m["requested"], lines_by_id[x["itemId"]]):errors.append(f"lines/{n}/mismatches/{k}/requested: quote what the line's request "f"or COBRA's settings say; {m['requested'][:60]!r} is not in them")return errors
以请求行 "1 database server, 8 vCPU, 32 GB RAM, SQL Server Standard, 500 GB data" 为例:
- 一个不匹配,requested 为 "SQL Server Standard",页面为 "MySQL",与请求共有 "sql"、"server" 和 "standard" 三个词。它会被保留,这一行判为失败。
- 一个不匹配,requested 为 "She was the first woman to fly solo across the Atlantic",与请求没有共同词。它会作为一个错误,按 JSON 路径退回给模型。
经验 4:每次重试都有预算,用完就交给人
没有上限的自我修正是一个 bug。COBRA 中每个循环都有上限:
- 模型调用: 遇到限流、5xx 错误

- 和超时时,持久步骤最多运行 3 次。每次运行内部,Bedrock 调用也会按自己的退避策略重试。
- Schema 修复: 2 次,然后这次尝试失败。
- 阶段: 最多 3 次尝试。
- 然后交给人: 向销售代表提出一个必须回答的问题,或者转交给我们的团队,并把失败的阶段显示为 BOM 状态(例如 "AWS Service Mapping Failed")。
我们以前会在最后一次尝试时切换到更大的模型(Kimi K3),后来去掉了。用更大的模型重跑整个阶段成本很高,而且很少能通过。第三次尝试失败时,通常是输入缺了什么,而人可以补上。
有些事情从来不由模型决定:
- 状态变更: 由代码完成,使用带版本的写入。
- 邮件: 每封状态邮件都有一个幂等键,由 BOM、其版本、轮次和邮件类型组成。发送方在发送前记录这个键,并跳过已经记录过的键,所以重试不会把同一封状态邮件发两次。
- 智能体之间的交接: 通过存放在 S3 中、按键索引的中间产物,从不通过聊天历史。
一整轮处理通过持久函数的执行超时限制在 6 小时以内,另外每 10 分钟有一次巡检作为第二道检查。
经验 5:分清哪些是你的架构,哪些是平台提供的
COBRA 的编排器先后在三种 AWS 运行环境上跑过。每次设计都没变,变的是我们需要自己构建的部分。
| Step Functions(v1 到 v4) | AgentCore Runtime(v5) | Lambda 持久函数(现在) |
|---|---|---|---|
LLM 修复循环 | Amazon States Language(ASL)状态,不好写 | 我们的代码 | 我们的代码,步骤带检查点 |
等待定价完成 | 回调,不好写 | 异步上限 8 小时(microVM) | 回调,暂停期间不收计算费用 |
步骤之间的状态 | 有负载大小限制 | 我们自己构建检查点 | 内置 |
崩溃恢复 | 内置 | 我们自己构建租约、心跳、巡检 | 重放;每次重试中 LLM 步骤最多执行一次 |
最长运行时间 | 1 年 | 8 小时 | 1 年(我们限制为 6 小时) |
迁移到持久函数后,我们删掉了租约、心跳和恢复的代码。我们的经验法则是:需要长时间等待,再加上 LLM 修复循环,就用持久函数。
定价:自己的 Runtime,自己的浏览器
定价运行在自己的 AgentCore Runtime 中:一个带浏览器的容器镜像,拥有只有它才有的权限,单次运行可以持续数小时。
我们一开始用的是 AgentCore Browser ,这是一个托管浏览器,由我们的代码通过 Chrome DevTools Protocol(CDP)远程操作。在我们的工作负载下,每次页面内调用需要 5 到 15 秒,会话经常卡住,计算器的下拉菜单(用 AWS 的 UI 库 Cloudscape 构建)在远程控制下会自动关闭,一个 12 项的估算还让标签页崩溃了。现在默认使用我们自己容器内的 Chromium,远程浏览器只是一个配置开关。两种模式下,操作都以页面内 JavaScript 运行,脚本超过 30 秒会触发页面重新加载,一次运行最多可以从检查点恢复两次。
自己运行浏览器,意味着补丁更新和出站网络(容器可以访问哪些网站)都由我们负责。一个已知缺口:"只能访问
calculator.aws "目前仍然是提示词规则,不是网络控制。这正是本文说要往下移一层的那类规则。解决办法是出站流量控制。Quick Automate 与 AgentCore:工具与系统
| Amazon Quick Automate(v1,原型) | Amazon Bedrock AgentCore(现在) |
|---|---|---|
提供什么 | 拖放操作、内置连接器,不需要运维或打补丁 | 代码:智能体、工具和编排都在 Git 中 |
适合 | 一个人把自己的工作自动化 | 其他人要依赖的系统 |
谁来修改 | 任何人,在流程编辑器中 | 开发人员,以及 AI 编程智能体 |
怎么测试 | 手动运行样例请求:每轮数小时 | 单元测试、离线测试和端到端测试:每轮数分钟 |
你要负责什么 | 很少 | 编排、状态、网关、身份 |
Quick Automate 是做原型的合适选择。我们切换主要是为了测试。在 Quick Automate 上,每次修改都要手动运行样例请求,再逐个阅读每个阶段的输出。换成代码后,测试套件几分钟就能跑完,AI 编程智能体(我们用的是 Claude Code)可以自己写修改并运行这些测试。这只有在系统是代码时才行得通。
原封不动保留下来的有:智能体的拆分方式、每个生成者配一个评审者,以及重试预算。架构从一个平台搬到另一个平台,本身没有变化。
经验 6:先修 harness,再换模型
我们说的 harness,指模型周围的一切:提示词、Schema、校验器、工具、数据和测试。LLM 步骤失败时,原因通常在 harness,而不在模型。

我们的测试,从快到慢:
- 约 167 个单元测试,很多以出过问题的真实 BOM 命名。
- 一个 Schema 约定测试(经验 2)。
- 一个离线 harness,使用真实的 Bedrock 调用和内存存储运行各个阶段。
- 开发环境中的端到端测试,经过聊天网关,检查邮件和 BOM 页面。
- 一个浏览器智能体测试台:25 个手写用例,加上服务目录中每个服务各一个用例。只有当这一行确实出现在计算器中,并且检查器判为通过时,用例才算通过。
- 评估集(evals)(完整运行,并与已知的正确答案对比打分):26 份早期 BOM,目前人工对比。计划在 CI 中运行。
一份真实 BOM 出问题时,就变成一个以该 BOM 命名的测试。
下面这些失败,一开始都被归咎于模型:
现象(我们以为是模型的问题) | 真正原因 | 在 harness 中的修复 |
|---|---|---|
"4 vCPU / 16 GB" 被读成 16 GB 磁盘 | 代码用正则表达式重新解析了原文 | 模型返回带原文引用的类型化需求;代码只做验证,并用 lint 防止正则解析器再次出现 |
AgentCore Gateway 被按 Amazon Bedrock 定价 | 服务目录中没有这个服务,所以工具做不了这件事 | 新增 108 个服务;代码拒绝该行所写服务之外的任何服务 |
大型请求在需求阶段失败 | 输出 token 预算 | 分块并行读取;保留通过的部分,而不是让整个阶段失败 |
SMB 文件共享被选成 Amazon S3 | 枚举值没有说明 | 每个选项加一行说明 |
更好的模型绕过了 harness 中的缺口,并不能证明问题出在模型上。只有在证明原因是模型之后,才更换某个任务的模型。
按最差测试选模型,而不是按平均分

我们设计了 8 个贴近 COBRA 实际任务的测试,每个运行 5 次,通过 Bedrock Converse 使用 Schema 输出(2026 年 10 月)。分数是通过检查项的比例。平均分看起来都不错,最差测试却不是这样:有三个模型至少在一个任务上得了 0 分,意味着这个任务对它们来说完全不可用。
然后我们把价格和质量放在一起看。以下是亚太地区(东京)的按需标价,来自 2026 年 10 月的 AWS Price List API。Kimi K3 和 Grok 4.6 显示的是它们全局跨区域推理配置文件的价格,我们也是这样测试的:
模型 | 最差测试 | 输入,每百万 token 美元 | 输出,每百万 token 美元 |
|---|---|---|---|
Kimi K3(全局) | 0.83 | 3.00 | 15.00 |
Kimi K2 Thinking | 0.75 | 0.73 | 3.03 |
Grok 4.6(全局) | 0.65 | 2.00 | 6.00 |
Qwen3 235B | 0.50 | 0.27 | 1.06 |
DeepSeek V3.2 | 0 | 0.74 | 2.22 |
MiniMax M2.5 | 0 | 0.36 | 1.44 |
Devstral 2 | 0 | 0.48 | 2.40 |
Qwen3 235B 是七个模型中最便宜的,而且没有完全不可用的任务。Kimi K2 Thinking 的最差测试更好,但价格约为 3 倍,在我们的测试中每次调用约慢 4 倍(16 秒对 4 秒)。Kimi K3 表现最好,但输入价格约为 11 倍,输出约为 14 倍。Qwen3 最弱的那个测试也让我们看到 harness 哪里需要改进,修 harness 比每次调用都为更大的模型付费要便宜。所以 COBRA 中每次模型调用都使用 Qwen3 235B,包括浏览器智能体。它以文本形式(无障碍树,accessibility tree)读取计算器页面,而不是读截图。
尚未解决的问题
- 浏览器出站访问仍是提示词规则,不是网络控制(见经验 5)。
- 追踪: 每次调用都记录了 BOM ID,校验通过的输出存放在 S3 中,浏览器会记录步骤和截图。但目前还没有贯穿 Lambda、AgentCore Gateway 和 AgentCore Runtime 的端到端 OpenTelemetry 追踪。
- 每份 BOM 的成本: 每次调用的模型 token 都有记录,但浏览器和 Runtime 的时间还没有按 BOM 统计。
- 评估集目前人工对比,下一步是放进 CI。
要点
- 把每条规则放在能执行它的最硬的一层。 提示词、Schema、评审者、代码、编排、身份。
- Schema 约束输出的形状,代码做决定。
- 每个生成者都配一个评审者,评审者主要是代码。
- 每次重试都要有预算,用完就交给人。
- 分清哪些由你负责,哪些由平台提供。
- 先修 harness,再换模型。
在你自己的系统上从哪里开始
- 让所有模型调用都经过同一个函数。 解码时强制 Schema,代码校验,最多修复 2 次,达到输出上限直接失败。
- 加上 Schema 约定测试。 每个数组都有
maxItems,不用数值边界,引用在决定之前。
- 给一个评审者先加上代码检查。 选出错代价最高的那个智能体,在任何 LLM 判断之前,先检查代码能检查的部分。
- 为每个循环写下重试预算, 并决定预算用完后由哪个人接手。
- 把每个生产故障都变成一个测试, 以出问题的请求命名,并且先修 harness,再换模型。
John Ng 是香港的 AI 与云解决方案架构师,AWS Community Builder,也是 AI Tinkerers Hong Kong 的联合组织者。如果你正在把智能体用在没有 API 的工具上,或者想交流架构或测试 harness 方面的经验,欢迎 在 LinkedIn 上联系我 。
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article