

无侵入监控和回放 Claude Code 会话执行过程
Apache SkyWalking AI Sessionizer 可以直接读取本机已有的 Claude Code 记录,将对话、工具调用和子 Agent 的执行过程关联起来,在浏览器中查看。接入时不需要在 Claude Code 中安装插件或修改配置,使用 Sessionizer 之前留下的历史记录也可以回放。
Series: AI x 可观测性 (中文专题) (3 articles)
- 2无侵入监控和回放 Claude Code 会话执行过程 This article
英文原文: Replay Claude Code Sessions Without Plugins or Configuration Changes ,发表于 2026 年 9 月 3 日。本文保留原文发表时的功能状态与使用方式。
Claude Code 完成一项耗时较长的任务后,怎样回头查看它的执行过程?你可能想重读对话,检查某次工具调用及其返回结果,或者确认子 Agent 完成了哪些工作。这些记录已经保存在本机,但一项任务如果持续数小时,期间调用了多个工具、压缩过上下文,还启动了子 Agent,相关内容就可能分散在许多文件中。
我们正在公开一个处于 pre-alpha 阶段的新项目: Apache SkyWalking AI Sessionizer 。它读取 Claude Code 已经写出的原生记录,将对话与工具、子 Agent 的活动关联起来,并提供本地回放页面,供你在浏览器中查看执行过程。不需要在 Claude Code 中安装插件或修改配置,开始使用 Sessionizer 之前留下的历史记录也可以直接查看。
回放能查看什么
这里的回放,是根据会话留下的记录重建执行过程,供人查看。打开一段对话,可以阅读输入和回复,检查已经记录的工具请求与结果,并沿时间轴查看父 Agent 和子 Agent 的活动。它要解决的问题是:一项长时间运行的 Agent 任务结束后,人还能看懂其中发生了什么。
例如,Claude Code 将部分工作交给子 Agent 时,你可以查看父 Agent 发出的请求,进入子 Agent 独立的执行流,检查它记录下来的工作过程;如果原始记录提供了足够依据,还可以沿关联关系回到父 Agent。这样,对话内容和背后的执行活动就能放在一起查看。
需要区分的是,回放不会重新调用模型,也不会再次执行工具。Claude Code 的本地文件不会完整提供每次发给模型服务方的请求、系统指令、缓存标注、精确的计时边界或重试标识。Sessionizer 根据已有记录重建活动,并展示缺失的信息和无法确定的关联。对于记录中未公开的模型推理过程,它也无法还原。
目前,采集与组装流程已经实现,本地回放页面仍在开发中。静态导出和远程遥测集成属于后续工作。我们在 pre-alpha 阶段公开项目,希望开发者可以尽早试用,一起完善对话模型,以及如何依据原始记录建立关联的规则。
无需在 Claude Code 中安装或配置
Sessionizer 直接读取已有的本地文件。不需要安装 Claude Code 插件、注册 Hook 脚本、通过额外的包装程序启动 Claude Code,也不需要调整环境或运行时配置。为了采集数据,你不必重新开启一个 Claude Code 会话,已经保留下来的历史记录就可以使用。
Sessionizer 自身作为独立程序运行。下面介绍如何从源码构建,并启动本地回放页面。
启动本地回放页面
从源码构建需要 Go 1.27 或更高版本。克隆项目后,执行构建并启动:
Bash
git clone https://github.com/apache/skywalking-ai-sessionizer.gitcd skywalking-ai-sessionizermake build./bin/asz view
如果想单独检查采集过程,还可以使用以下两个命令。运行
asz view 之前不需要先执行它们:Bash
./bin/asz sources # 列出发现的会话和源文件./bin/asz collect -once # 采集一次当前本地记录,不启动界面
这些命令需要在仓库根目录下运行,以便 Sessionizer 读取项目附带的
asz.yaml 。默认配置已经能够发现已有的 Claude Code 数据并提供本地回放页面,无需修改配置。
图 1:对话列表汇总了各个 Claude Code 会话中的交互轮次(Talk)、步骤(Step)、执行流(Execution Stream)和片段(Segment)数量,以及活跃时间跨度和最近活动时间。
页面从对话和交互轮次开始,再展示背后的父 Agent 与子 Agent 执行流。阅读对话内容时,可以同时查看按时间轴展开的执行过程,包括模型调用、工具执行、Agent 活动、关联关系,以及建立这些关联所依据的来源记录。

图 2:一轮交互中的输入和输出,与父子执行流、来源记录查看面板,以及上下文、模型和工具活动的时间线放在一起展示。
将分散记录整理为会话
对话记录很有用,但它并不能代表完整的执行过程。
Claude Code 可能将主对话记录、子 Agent 的对话记录及元数据、工作流日志、清单和脚本保存在不同位置。其中一部分可以直接作为对话阅读,另一部分描述工具执行、模型调用、任务委派或工作流状态。仅凭某一个文件,未必能确定这些内容之间的全部关系。
在组装之前,Claude Code 适配器会先把这些运行时特有的数据映射为统一的 Session Data 格式。每条记录都会保留所属的会话和执行流、原生标识与父级引用、调用和运行的关联键、工具及子 Agent 的关联键,以及稳定的来源位置。这样,记录所表达的含义就不再依赖某个运行时使用的具体文件格式。
根据原始记录建立关联
组装过程按八个阶段依次进行,每个阶段先确定下一阶段所依赖的信息。同一条记录如果出现多次,只保留最先落地的一份。随后,将记录划分到相互独立的父 Agent 和子 Agent 执行流中;按消息 ID 将助手消息片段归并为模型调用;按工具调用标识(tool-use ID)关联工具请求和结果;再利用已有的 Agent 与运行标识,将 Agent 调用连接到子执行流。
只有记录中明确出现重置事件,才能开启一个新的上下文周期(Context Epoch)。Talk 和 Run 则根据触发事件与父级关系链构建,不能只因两条记录相邻,就认为它们属于同一组。采集周期划定了形成 Segment 的时间窗口。一个 Segment 可以关联这个周期中的多个 Talk,但不一定包含该周期采集到的全部 Talk。
整个过程都以记录实际落地的先后顺序为准,因为不同记录的时间戳可能出现倒退。

图 3:分散在不同位置的原生记录,经过有序且有据可查的组装,形成可以持久保存的对话。一个 Segment 关联同一采集周期中的多个 Talk,但不一定包含全部 Talk;尚未解析的记录,以及每次关联的质量,都会保留下来。
组装结果会区分数据归属和关联关系。每个节点最多只有一个包含它的父节点,层级依次为:
text
Session → Execution Stream → Context Epoch → Talk → Run → Step
跨执行流的活动和其他因果关联,则通过少量、具有明确类型的关系表达,例如
starts 、 reports 、 ends_with 、 follows 、 summarizes 和 in_segment 。每条关系都保留来源依据和关联质量。Conversation 提供能够长期保留的对话链标识,Session 则保留数据来自哪个运行时会话的信息。父 Agent 和子 Agent 始终位于不同的 Execution Stream 中,子 Agent 的消息和工具调用不会复制到父执行流里。Segment 也不是另一个包含层级。它用于关联同一采集周期中的多个 Talk,并不意味着该周期中的所有 Talk 都属于这个 Segment。
一个 Segment 可以关联同一采集周期中的多个 Talk
采集周期决定了形成 Segment 的时间窗口。图 4 展示了一个周期内采集到的四个 Talk。其中,Segment 3 关联了 Talk 12 和 Talk 13,Talk 11 与 Talk 14 则不在其中。图中进一步展开 Talk 12,展示这轮交互背后的 Agent 活动。
一轮交互中可以包含完整的 Agent 循环
Talk 表示一次由 Agent 外部输入发起、可以供人阅读的交互。它不一定只包含一个问题和一个回答。工作进行期间,用户可能继续发送消息,Agent 也可能在工具调用之间输出进展;子 Agent 完成任务后的通知,还可能在原有 Talk 继续的同时,触发另一个 Run。
因此,一个 Run 对应一次 Agent 循环,而非单次模型调用。在一个 Run 内,模型回复可以请求调用工具,工具返回结果又可能触发下一次模型调用,任务委派则可以开启独立的子执行流。Sessionizer 会将一次工具请求及其结果合并为一个 Tool 步骤。子 Agent 的输出仍归属于子执行流,父执行流通过标明证据情况的关系与它关联,不会将这些输出直接纳入自身。
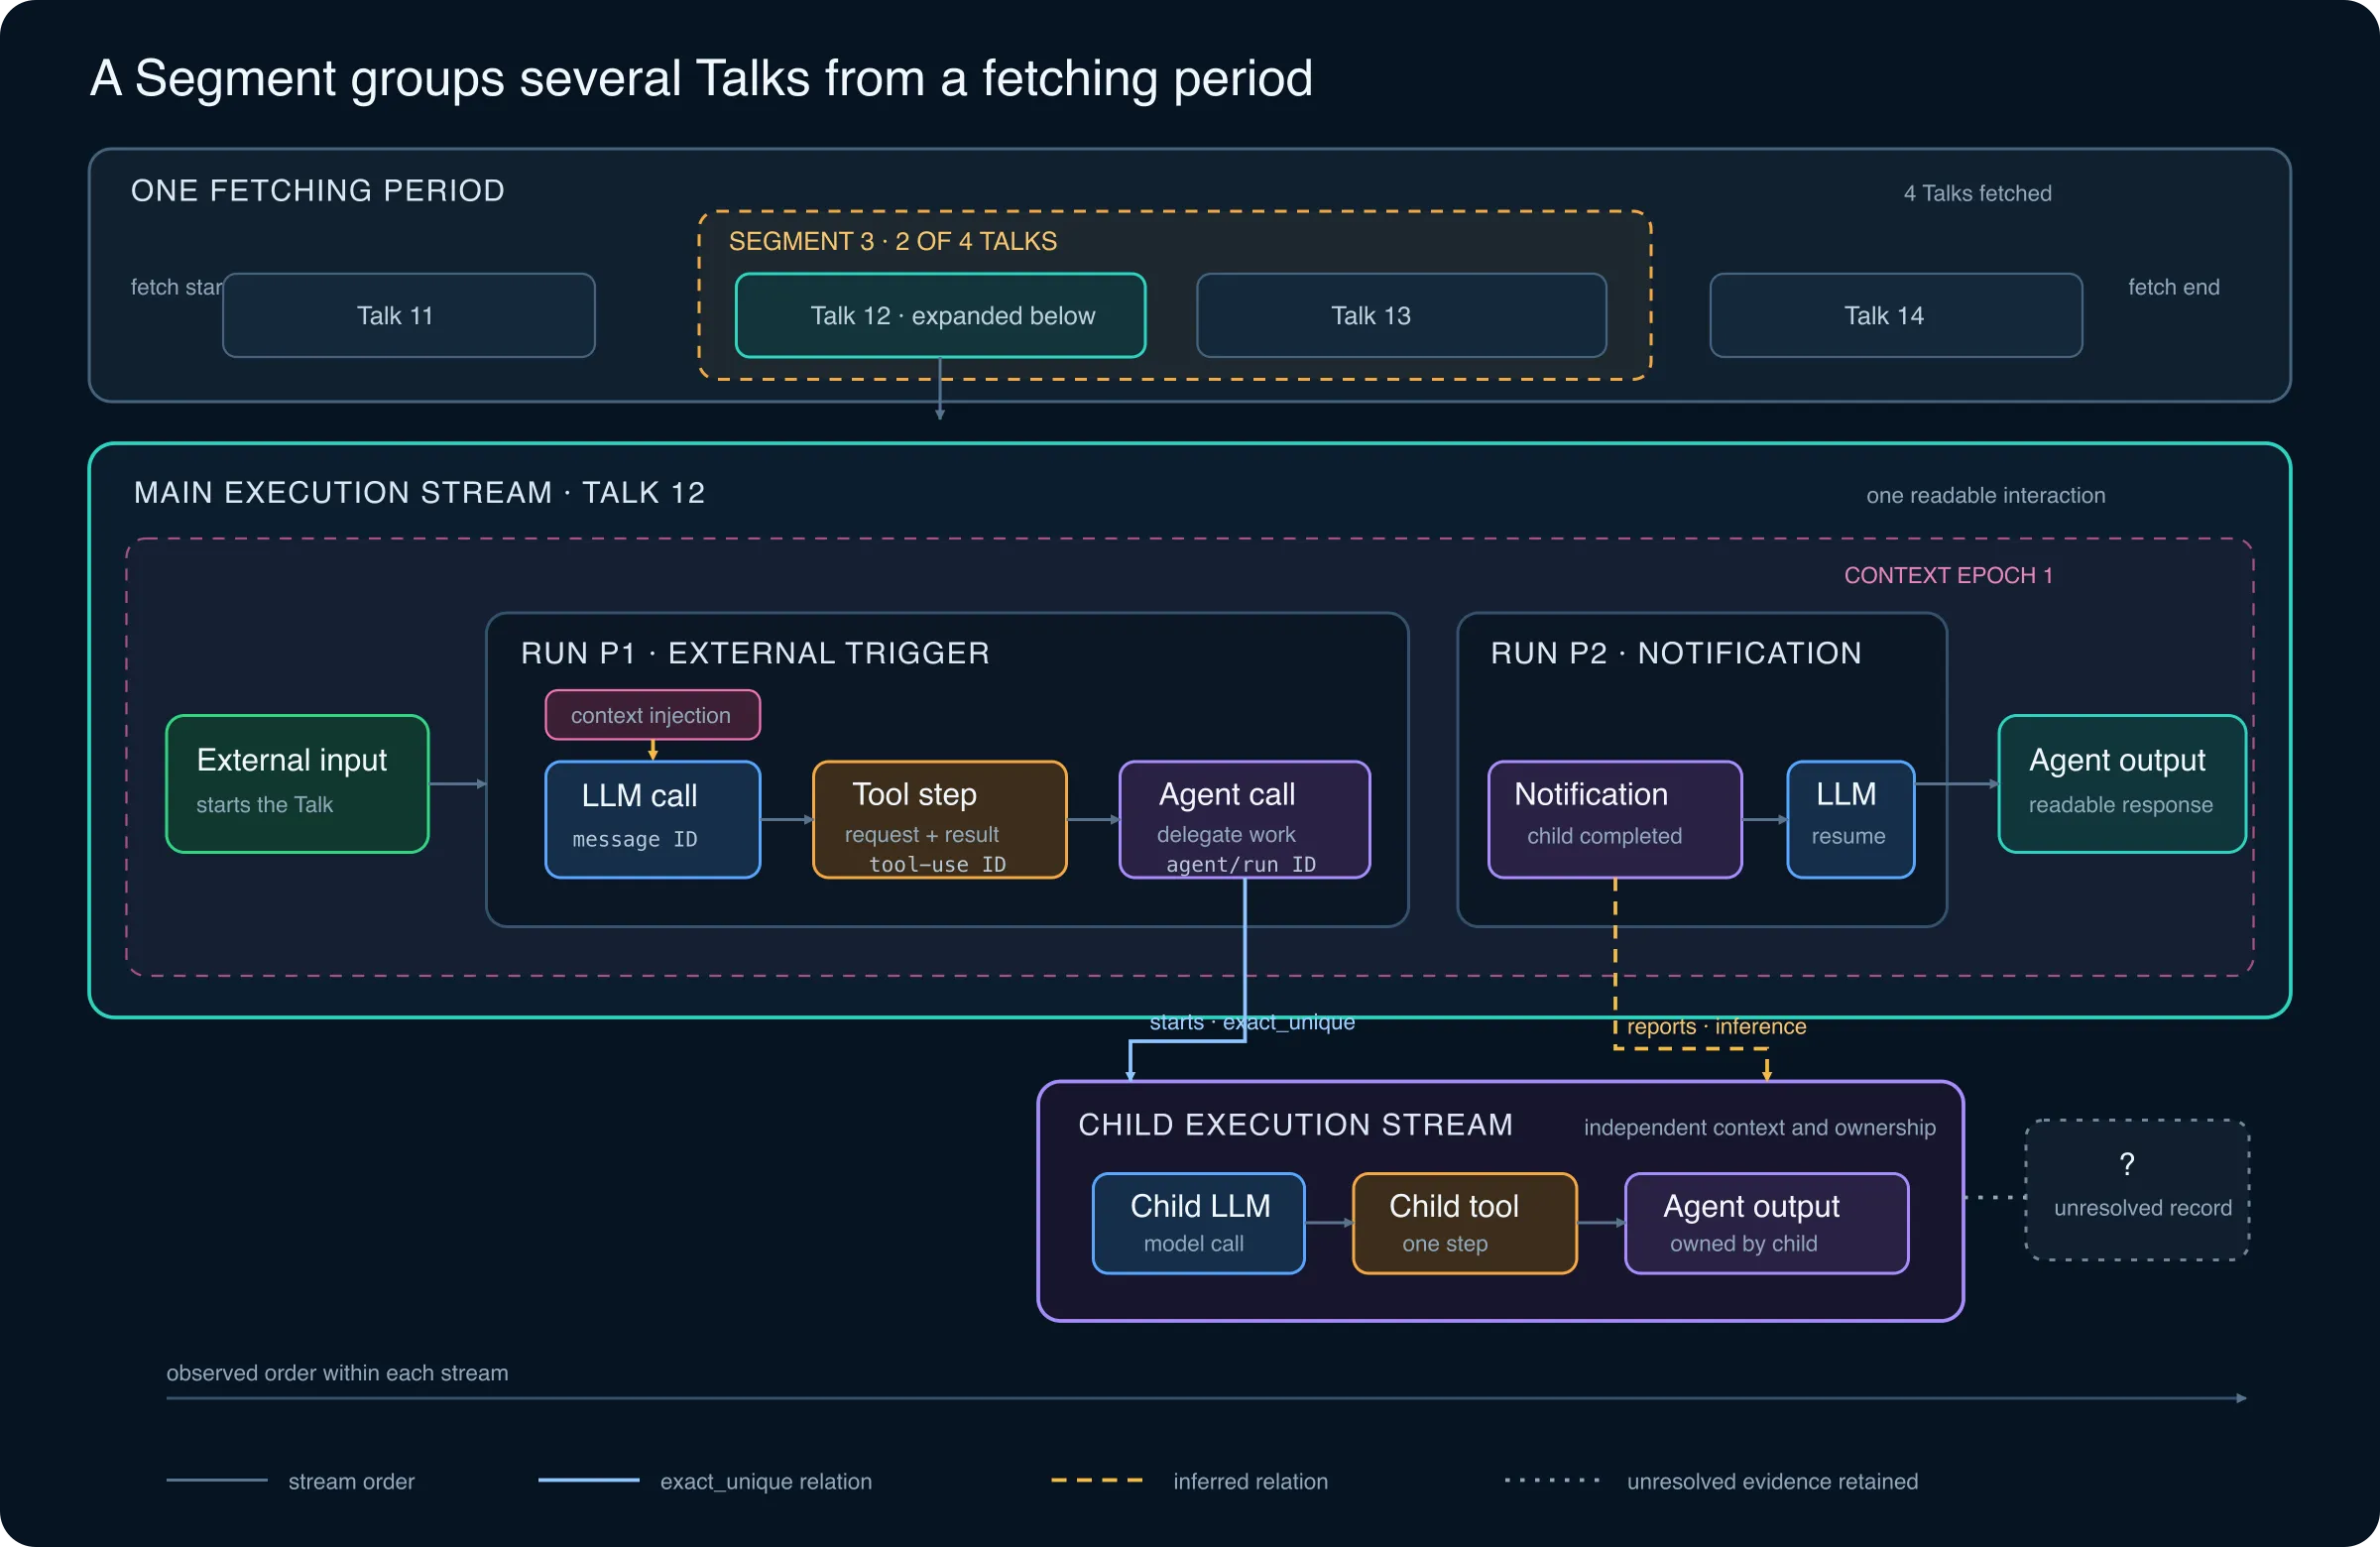
图 4:同一个采集周期包含四个 Talk,Segment 3 只关联其中两个。展开的 Talk 展示了一轮交互如何跨越多个父 Agent Run 和一个独立的子 Agent 执行流。实线、虚线以及未解决的关联,分别保留原始记录能够支持的确定程度。
这就是 sessionizing 所做的工作:将分散的运行时记录整理为连贯、可持久保存的会话,同时保留数据来源,以及每条关联是否能够确定。
保留记录能够说明的范围
一条清晰的时间线,容易让人觉得其中的关系都已经得到确认。但原始记录未必支持这样的判断。因此,Sessionizer 将证据质量作为数据本身的一部分保存。
每项信息都会标明状态:已观测且可回放、已观测但仅能用于报告、拟议中,或者不可用。关联关系也有自己的解析状态,例如精确匹配且唯一、精确匹配但存在歧义、基于强证据推断、尚未解析或存在冲突。如果一个标识同时匹配多个候选项,组装过程会保留这种歧义,不会自行选择一个看起来最方便的结果。
这些规则贯穿整个模型。会话标识不能根据用户名或时间戳接近程度猜测;父 Agent 和子 Agent 的执行流分别保留自身的连续性;来源中缺失的信息继续标为不可用,不能把估算结果当成事实。
因此,组装结果可以用于页面展示,也能作为一份组装完成并保存的会话数据,供后续的查看、导出、度量和评估使用。这些功能都能基于同一套记录,明确哪些活动确实被观测到了。
后续的三个方向
目前的 Claude Code 适配提供了一条可以实际验证的数据路径。但项目的目标会继续扩展到本地查看之外,也会支持更多 Agent 运行时。后续主要有三个方向。
用统一的数据格式承接本地和远程采集
本地记录的价值在于,不需要接入运行时,就能立即查看当前和历史会话。当需要跨机器、跨团队,或在受管理的环境中观测会话时,则需要远程采集。
我们希望这两种互补的采集方式最终使用同一套会话数据格式。无论对话来自本地文件,还是通过远程遥测组装,都应该保留相同的核心层级、来源规则、证据状态和执行边界。本地重建、可移植导出、远程接收和集中存储,不应各自重新定义同一种 Agent 行为。
这样,今天的本地查看就能逐步扩展为近实时监控,以及可以与他人分享的会话记录。先确定数据模型,后续再演进传输和展示方式,无需每次都重新定义会话。
从 Claude Code 扩展到 Codex 和 LangChain、LangGraph Agent
Claude Code 适合作为起点,因为它已经留下了丰富的本地记录,也覆盖了许多需要认真处理的情况:长对话、工具调用、上下文变化、子 Agent、工作流,以及分散在多个文件中的活动。
我们计划继续探索 Codex,以及 LangChain、LangGraph 生态中 Agent 的适配。每种运行时都有自己的术语,也会提供不同类型的记录。适配器需要将它们映射到共同的对话结构,同时保留各运行时特有的事实。
目标是让不同 Agent 生态共享清晰的会话边界,并保留准确理解各自执行过程所需的信息,避免在统一格式时丢失这些差异。
在会话数据之上提供指标与分析看板
会话数据采集并规范化之后,就可以从同一套结构中计算有用的指标,例如会话持续时间、模型和工具活动、可获取的 Token 用量、子 Agent 参与情况、错误,以及上下文不连续等行为信号。
指标分析和看板由此成为会话整理之后的一项额外能力。它们可以帮助使用者了解大量会话中的活动与趋势;进入具体会话后,又能保留排查所需的详细记录。随着数据基础逐步完善,还可以进一步支持完整会话评估,检查 Agent 对话的执行轨迹和最终结果,而不仅是给孤立的输入、输出打分。
这些看板和评估能力仍属于后续方向。当前首先要把会话数据本身整理可靠,让之后的分析有据可依。
为什么在这么早的阶段公开
Sessionizer 中最重要的设计,涉及标识、连续性、因果关系、数据来源、隐私和不确定性。相比页面颜色或图表类型,这些决定会更早影响适配器和已存储的数据。一旦后续实现依赖了它们,再调整就会困难得多。
因此,我们选择在 pre-alpha 阶段公开项目,希望 Agent、可观测系统和评估工具的开发者一起检查模型,用真实会话测试 Claude Code 适配器,并指出我们尚未遇到的情况。现阶段尤其欢迎围绕数据结构、保护隐私的测试样本、确定性组装、证据状态判定规则,以及基于预期结果的回归测试(golden tests)参与贡献。
可以先从本机一段已有的 Claude Code 会话开始,在本地回放页面里查看它留下的执行记录,并帮助我们逐步完善面向更多 Agent 的回放、监控和分析能力。
Series: AI x 可观测性 (中文专题) (3 articles)
- 2无侵入监控和回放 Claude Code 会话执行过程 This article
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article