RAG con LangChain y FastAPI: dale contexto de todo el repo a tu agente
Cómo el copiloto pasa de espiar el repo archivo por archivo a consultarlo por relevancia, y cómo sale de la terminal para vivir detrás de una API. Con una regla que sostiene todo: Strands orquesta, LangChain recupera.
Pongámonos en contexto rápido. El protagonista de este artículo es un copiloto de código: un agente construido con Strands Agents que ya sabe analizar un repositorio con un puñado de tools y recordar la conversación entre sesiones. Si vienes siguiendo la serie, es el mismo copiloto; si llegas hoy por primera vez, no necesitas nada más que esa idea para seguir. Aquí le vamos a resolver un límite concreto que arrastra desde el principio.
El agente solo ve el repo a través de las tools que abren archivos. read_file aquí, analyze_structure allá. Es como mirar una casa por la ranura del buzón: ves un pedazo, luego otro, pero nunca la casa completa. Para un repo de 20 archivos funciona. Para uno de 500, el agente no sabe ni por dónde empezar a mirar.
Piensa en la pregunta más normal del mundo: "¿dónde está la lógica de autenticación?". Hoy el agente tendría que abrir archivos a ciegas hasta toparse con ella. Lo que necesita es poder preguntar y recibir los fragmentos relevantes sin haber abierto nada uno por uno. Eso es RAG: recuperas el conocimiento del repo por relevancia, en vez de pasearte por los archivos a mano.
Este artículo hace dos cosas con eso. Primero, le damos al copiloto ese RAG para que entienda el repo completo. Segundo, lo sacamos de la terminal y lo ponemos detrás de una API con FastAPI, para que cualquier cliente lo use por HTTP con la respuesta llegando token a token. Y de paso cambiamos la memoria casera por la nativa del SDK, que es el salto que pide un servicio con usuarios de verdad.
Es un artículo L300 de la serie #PausaYConstruye, donde construyo este copiloto pieza por pieza. Se puede leer solo, pero si quieres el hilo completo te dejo enlaces al final. Antes del código, la decisión que le da forma a todo.
La tesis: Strands orquesta, LangChain recupera
Cuando la gente integra LangChain a un agente que ya funciona, cae casi siempre en la misma trampa: termina montando un agente de LangChain encima del agente que ya tenía. Ahora hay dos orquestadores. Dos formas de definir tools. Dos manejadores de historial. Dos capas de prompt. Un sistema que nadie puede razonar de principio a fin.
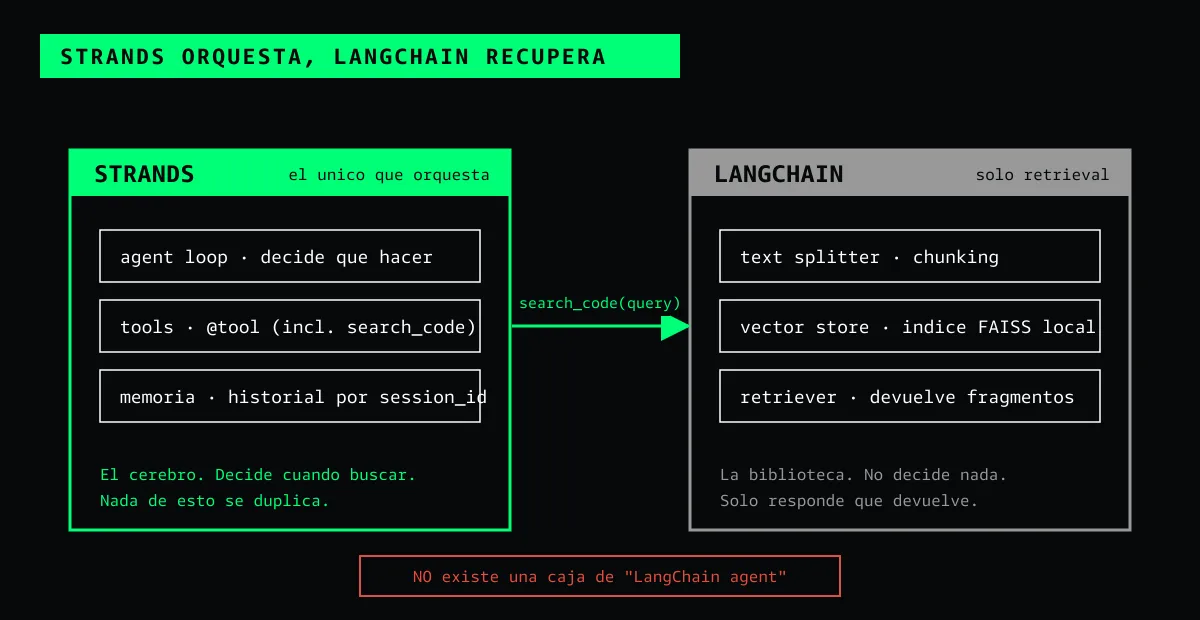
La regla de este artículo es una sola frase: una sola capa de orquestación. En este proyecto esa capa es Strands, y no se toca. LangChain entra únicamente como capa de retrieval: indexar el codebase y devolver fragmentos relevantes. Nada más. No hay chains de orquestación, no hay agent executors de LangChain, no hay un segundo cerebro.
La flecha va en un solo sentido. El agente Strands usa el retriever como si fuera una tool más, igual que usa read_file. LangChain nunca decide nada; solo responde qué fragmentos devuelve cuando el agente pregunta.
¿Por qué insisto tanto en esto a nivel L300? Porque mezclar responsabilidades no es un pecado estético, se paga en tres monedas. Pagas latencia, porque metes un segundo loop de razonamiento donde bastaba una consulta. Pagas costo, porque cada capa de orquestación gasta tokens. Y pagas bugs, porque duplicaste la superficie donde algo puede fallar. Separar las capas mantiene el sistema testeable y portable: si mañana quieres cambiar LangChain por LlamaIndex, tocas la capa de retrieval y nada más.
Con esa frontera clara, vamos a lo concreto.
Ingesta e indexado: convertir el repo en un índice
El objetivo de esta primera pieza es simple: recorrer el codebase, partirlo en fragmentos, convertir cada fragmento en un vector y guardar todo en un índice que se pueda consultar por relevancia. Ese índice vive local, en disco.
Las dependencias nuevas sobre lo que ya traía el proyecto (Strands, tree-sitter, boto3):
faiss-cpu es la versión de FAISS para CPU, suficiente para indexar un repo local y sin necesidad de GPU. langchain-aws trae los embeddings de Bedrock; langchain-community trae el vector store FAISS; langchain-text-splitters trae el chunker. supabase es el cliente de Postgres que usaremos como backend de memoria del servicio (más sobre esto adelante). Nada de esto es un agente ni una chain de orquestación.
Lo bueno es que no partimos de cero. El copiloto ya sabe caminar un repositorio: iterSourceFiles recorre los archivos de código y salta las carpetas que no valen la pena (node_modules, .git, dist), y readTextSafely lee texto sin reventar con archivos binarios. Vamos a reusar exactamente eso.
Aquí LangChain aporta tres piezas y solo tres: el text splitter, el vector store y el retriever. No aparece ninguna chain ni ningún agente.
# knowledge.py: LangChain SOLO para retrieval, nunca para orquestar. from pathlib import Path
from langchain_aws import BedrockEmbeddings from langchain_community.vectorstores import FAISS from langchain_core.documents import Document
from code_copilot.utils import ( EXTENSION_LANGUAGE_MAP, iterSourceFiles, readTextSafely, )
defloadCodeDocuments(repoPath: str) -> list[Document]: """Read every source file into a Document, reusing the repo walker.""" basePath = Path(repoPath).expanduser().resolve() documents: list[Document] = [] for filePath in iterSourceFiles(basePath): language = EXTENSION_LANGUAGE_MAP.get(filePath.suffix) if language isNone: continue sourceText = readTextSafely(filePath) ifnot sourceText: continue documents.append( Document( page_content=sourceText, metadata={ "path": str(filePath.relative_to(basePath)), "language": language, }, ) ) return documents
defbuildIndex(repoPath: str) -> FAISS: """Build a local FAISS index from the repository's source files.""" documents = loadCodeDocuments(repoPath) chunks = splitCodeDocuments(documents) # chunking strategy: see next section embeddings = BedrockEmbeddings(model_id="amazon.titan-embed-text-v2:0") return FAISS.from_documents(chunks, embeddings)
Un par de cosas que vale la pena señalar.
Los embeddings salen de Bedrock, con amazon.titan-embed-text-v2:0. Un embedding es la representación numérica de un texto: un vector que ubica el fragmento en un espacio donde lo semánticamente parecido queda cerca. Ese modelo es el que usa el proyecto porque el copiloto ya corre sobre Bedrock, así que no sumamos un proveedor nuevo solo para esto.
El índice es FAISS y vive local, en disco, sin infraestructura extra. Es la misma filosofía con la que el copiloto guardaba su memoria en un archivo local: empieza simple, con algo inspeccionable y sin servicios que levantar, y deja la puerta abierta a cambiar el backend después.
Cada fragmento carga sus metadatos: la ruta y el lenguaje. Eso no es decoración. Es lo que después nos deja citar la fuente en la respuesta ("esto sale de auth/login.py") en vez de soltar un pedazo de código sin contexto.
Falta la pieza que anoté como pendiente: splitCodeDocuments, el chunking. Y no es un detalle.
Chunking de código: la decisión que hace o rompe el retrieval
Partir código no es partir prosa, y esa diferencia es la que decide qué tan bueno queda tu retrieval.
Si partes un artículo a la mitad de un párrafo, se lee raro pero se entiende. Si partes una función de Python a la mitad, arruinas la recuperación: el fragmento queda con la firma sin el cuerpo, o con el cuerpo sin la firma, y cuando el agente pregunte por esa función va a recibir basura a medias. El chunking define qué tan bueno es tu retrieval, punto.
Hay dos estrategias, y entre ellas hay un trade-off honesto.
Por archivo. Tomas el archivo completo y, si es grande, lo cortas en trozos con un solape entre ellos. Es simple, robusto, y preserva el contexto del módulo (los imports, las constantes de arriba). El costo: los trozos son grandes y menos precisos, así que cada recuperación trae más tokens de los que necesitas.
Por símbolo. Partes por función y por clase, de modo que cada fragmento es una unidad que tiene sentido por sí sola. El retrieval sale mucho más preciso. El costo: necesitas parsear el código para saber dónde empieza y termina cada símbolo, y puedes perder el contexto del módulo alrededor.
Y otra vez no partimos de cero para la versión por símbolo. El copiloto ya usa tree-sitter en su tool analyze_structure para sacar los símbolos de cada archivo, con un fallback a regex cuando la gramática no está instalada. Esa misma maquinaria nos sirve para cortar por símbolo.
Empecemos por la estrategia por archivo, que es el fallback robusto:
1 2 3 4 5 6 7 8 9 10
from langchain_text_splitters import RecursiveCharacterTextSplitter
defsplitByFile(documents: list[Document]) -> list[Document]: """Chunk by file: robust, preserves module context, coarser retrieval.""" splitter = RecursiveCharacterTextSplitter( chunk_size=1200, # characters, roughly ~300 tokens chunk_overlap=150, # overlap so a split never fully severs context ) return splitter.split_documents(documents)
Los dos parámetros que importan son chunk_size y chunk_overlap. El tamaño decide cuánto contexto cabe en cada fragmento; el solape evita que un corte deje una idea partida sin remedio, repitiendo un poco al final de un trozo y al inicio del siguiente.
La versión por símbolo reusa ese mismo parsing: sacas los símbolos, y cada símbolo se vuelve un chunk con su propia metadata.
from code_copilot.tools.structure import _extractSymbols # tree-sitter
defsplitBySymbol(documents: list[Document]) -> list[Document]: """Chunk by symbol: precise retrieval, needs parsing (reuses tree-sitter).""" chunks: list[Document] = [] for document in documents: language = document.metadata["language"] symbols = _extractSymbols(document.page_content, language) ifnot symbols: # No parseable symbols: fall back to file chunking for this document. chunks.extend(splitByFile([document])) continue for symbolText, symbolName in sliceSourceBySymbols(document, symbols): chunks.append( Document( page_content=symbolText, metadata={**document.metadata, "symbol": symbolName}, ) ) return chunks
Fíjate en la última línea del bloque de metadata: "symbol": symbolName. Ahora cada fragmento sabe de qué función o clase salió, no solo de qué archivo. Eso hace la cita mucho más útil: "la validación está en la función validate_token de auth/login.py".
¿Cuándo usar cuál? Mi criterio: por símbolo cuando el lenguaje se parsea bien y la precisión manda (Python, JavaScript, que ya tienen gramática de tree-sitter en el proyecto), y por archivo como fallback robusto cuando tree-sitter no puede con el lenguaje. Es la misma degradación elegante que uso en el resto del copiloto: si la herramienta buena no está, caes a la que siempre funciona en vez de reventar.
Por archivo
Por símbolo
Precisión del retrieval
Menor (trozos grandes)
Mayor (unidades coherentes)
Contexto de módulo
Se preserva
Se puede perder
Requiere parsing
No
Sí (tree-sitter)
Rol en el proyecto
Fallback robusto
Preferido cuando el lenguaje se parsea
search_code: el retriever es una tool más
Ya tenemos el índice. Falta el puente: una tool que el agente pueda llamar para consultarlo. Y aquí está la clave de diseño de todo lo que armamos.
Para el agente, buscar en el índice tiene que ser indistinguible de leer un archivo. Una tool normal, con su docstring, que recibe una consulta y devuelve texto. El agente decide cuándo buscar; LangChain solo responde qué devuelve. Ni una gota de orquestación cruza la frontera.
# The retriever is built once at startup from the index (see knowledge.py). # It is a plain LangChain retriever: no chains, no agent, just similarity search. _RETRIEVER = None
defsetRetriever(retriever) -> None: """Wire the LangChain retriever built at startup. Called once by the app.""" global _RETRIEVER _RETRIEVER = retriever
@tool defsearch_code(query: str, k: int = 5) -> str: """Semantic search over the indexed repository.
Returns the top-k most relevant code chunks for the query, each with its file path (and symbol, when available) so the answer can cite its source.
Args: query: A natural-language or code question, e.g. "where is auth handled?". k: How many chunks to return.
Returns: The relevant chunks as text, each prefixed with its source location. """ if _RETRIEVER isNone: return"Index not available: the repository has not been indexed yet."
hits = _RETRIEVER.invoke(query)[:k] formatted = [] for hit in hits: location = hit.metadata.get("symbol") or hit.metadata.get("path", "unknown") formatted.append(f"# source: {hit.metadata.get('path')} :: {location}\n{hit.page_content}") return"\n\n---\n\n".join(formatted) if formatted else"No relevant code found."
El puente entre las dos piezas es una línea: el buildIndex devuelve el vector store FAISS, y al arrancar la app se convierte en retriever con index.as_retriever() y se pasa a setRetriever(...). De ahí en adelante search_code solo consulta.
Ese docstring, como en toda tool de Strands, no es un comentario para ti. Es lo que el modelo lee para decidir cuándo llamar la tool. Si dice bien que sirve para "where is auth handled?", el modelo la va a usar en el momento correcto. Sumar search_code a ALL_TOOLS es lo único que hay que hacer para que el agente Strands la tenga disponible; no cambia nada de su orquestación.
Esto además aclara una distinción fácil de confundir: la memoria conversacional no es lo mismo que el conocimiento del repo. Ahora que el conocimiento del repo se materializa en el índice, queda claro que RAG no es memoria:
La memoria recuerda la conversación: qué le pediste al agente, qué respondió. Cambia con cada turno.
El RAG recupera conocimiento del repo: qué dice el código. Cambia cuando cambia el codebase, no cuando hablas.
Son dos stores distintos, con propósitos distintos, y está bien que vivan separados.
Cuándo NO agregar otra librería
Antes de seguir con el servicio HTTP, una pausa honesta, porque acabamos de agregar una dependencia grande y eso nunca es gratis.
Cada librería que sumas trae una factura que se paga después: más superficie de bugs, versiones que hay que mantener alineadas, un deploy más pesado, y una curva de mantenimiento que crece. La pregunta no es "¿esta librería es buena?", sino "¿esta capa la resuelve algo que yo no quiero reimplementar?".
En este caso, sí vale la pena: retrieval vectorial maduro y probado (splitters, embeddings, vector stores), código que ya resolvió los casos borde y que reescribir a mano te costaría semanas sin ganar nada. Ese es el criterio para decir que sí.
¿Cuándo NO? Cuando Strands ya lo resuelve. Si te descubres metiendo LangChain para orquestar, para definir tools, o para manejar el historial de conversación, estás duplicando algo que el agente ya hace. Estos son los olores de duplicación que hay que vigilar:
Dos formas de definir tools (las @tool de Strands y las tools de LangChain).
Dos manejadores de historial (la memoria del propio copiloto y la memoria de una chain).
Dos capas de prompt peleando por el control del modelo.
La regla práctica que me llevo: agrega una librería solo para la capa donde aporta un valor único, y ponla detrás de una interfaz que puedas cambiar. Por eso el retriever vive detrás de search_code. Si mañana quieres LlamaIndex, cambias lo de adentro y el agente ni se entera.
Antes de exponerlo: cambiamos la memoria propia por la nativa del SDK
Hasta ahora el copiloto guardaba su memoria detrás de una interfaz propia, el MemoryStore, con un JsonFileStore. Y seré honesta: esa interfaz era una decisión educativa. La escribí a mano para ver el mecanismo funcionar (cargar, podar, guardar), no porque Strands no lo trajera. El plan siempre fue este: mientras el copiloto vive en una terminal, la memoria casera basta; el día que se vuelva un servicio real con usuarios, toca la salida nativa del SDK.
Pues llegó ese momento. Estamos a punto de ponerlo detrás de HTTP, con sesiones concurrentes y varias instancias posibles. Un archivo JSON local deja de alcanzar. Es hora de hacer el cambio.
Strands separa las dos responsabilidades de la memoria, y entender esa separación es la clave de todo el cambio:
El session manager se encarga de la persistencia. El SDK trae FileSessionManager (disco) y S3SessionManager (nube).
El conversation manager se encarga de la poda. El SDK trae SlidingWindowConversationManager (el truncado por ventana deslizante) y SummarizingConversationManager (el resumen).
Para un servicio con usuarios queremos un backend concurrente, persistente y compartido entre instancias. Vamos con Supabase, que es PostgreSQL gestionado con un cliente de Python cómodo. Strands no lo trae listo, y aquí está la decisión de diseño: en vez de volver a mi interfaz propia, extiendo la del SDK. Strands expone SessionRepository, la interfaz base sobre la que están construidos FileSessionManager y S3SessionManager. Si implemento esa, mi backend se enchufa directo al Agent y hereda todo lo que el framework ya resuelve: la serialización de mensajes, el ciclo de vida de la sesión, la reparación de secuencias de tool-use, y lo que Strands agregue después.
Primero, dos tablas en Supabase: una para las sesiones y sus agentes, otra para los mensajes. Nada exótico, un JSON por fila:
1 2 3 4 5 6 7 8 9 10 11 12
create table sessions ( session_id text primary key, data jsonb not null-- session + agents, as the SDK serializes them );
create table messages ( session_id text not null, agent_id text not null, message_id integernot null, data jsonb not null, -- the SDK's SessionMessage primary key (session_id, agent_id, message_id) );
SessionRepository es una clase abstracta con métodos CRUD sobre tres entidades: la sesión, el agente y los mensajes. Extenderla para Supabase se ve así (recortado a los métodos centrales):
# memory/supabase_repository.py from supabase import Client from strands.session.session_repository import SessionRepository from strands.types.session import Session, SessionAgent, SessionMessage
classSupabaseSessionRepository(SessionRepository): """A Strands SessionRepository backed by Supabase (PostgreSQL).
Implementing the SDK's own interface (instead of a custom one) plugs the backend straight into the Agent and reuses the framework's session lifecycle: message indexing, restore, tool-use repair. """
# create_agent, read_agent, update_agent, read_message, update_message: # same pattern (an upsert/select against the sessions or messages table). # Omitted for brevity.
Hay dos cosas que vale la pena ver. Primero, ya no invento el formato de serialización: guardo los to_dict() de los tipos de Strands (Session, SessionMessage) en una columna jsonb, igual que el JsonFileStore casero guardaba SessionMessage. Segundo, los métodos son puro CRUD contra Supabase; no hay lógica de sesión, porque esa la pone el framework.
El puente al agente es una sola línea, gracias a RepositorySessionManager, que envuelve cualquier SessionRepository y le da el ciclo de vida completo:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
from supabase import create_client
from strands.session.repository_session_manager import RepositorySessionManager

# The custom repository plugs into the SDK's session manager...
supabase = create_client(SUPABASE_URL, SUPABASE_KEY)
repository = SupabaseSessionRepository(supabase)
session_manager = RepositorySessionManager(session_id=sessionId, session_repository=repository)

# ...and the session manager plugs straight into the Agent.
agent = Agent(
    model=buildBedrockModel(),
    tools=ALL_TOOLS,
    session_manager=session_manager,          # persistence, native
    conversation_manager=SlidingWindowConversationManager(window_size=20),  # pruning, native
)
Y esto es lo importante: el Agent ahora carga y guarda solo. No hay loadHistory ni appendExchange manuales; el session_manager persiste cada mensaje en Supabase y lo restaura por session_id en cada invocación. La poda tampoco la manejo yo: la hace el conversation_manager nativo. Y como la conversación vive en Postgres, cualquier instancia del servicio puede retomar la sesión: eso es justo lo que un archivo JSON local no te daba.
Interfaz propia (MemoryStore)
Extender SessionRepository
Cuándo
Aprender el mecanismo, control total de tu límite
Servicio real con usuarios y backend custom
Serialización
La manejas tú
La resuelve el SDK
Ciclo de sesión
Lo orquestas a mano
Lo hereda del framework
Costo
Cero peso del SDK
Atado al contrato de Strands
¿Por qué no arrancar directo con el componente nativo? Porque no habrías visto el mecanismo. Una vez que entiendes qué hace load/prune/save por dentro, usar el componente nativo deja de ser magia y pasa a ser una decisión informada. Por eso el camino casero primero y el nativo después.
Nota: ya existe una implementación open source de este patrón para Supabase (supabase-strands) que puedes mirar como referencia, además de otras para Redis/Valkey. Extender SessionRepository es el camino que la propia comunidad de Strands usa para backends que el SDK no trae de fábrica.
Sacarlo de la terminal: FastAPI con streaming
Hasta aquí el copiloto sigue viviendo en una terminal. Vamos a exponerlo como un servicio HTTP para que cualquier cliente lo consuma: un POST /chat que recibe un session_id y un mensaje, y responde en streaming, token a token, para que el usuario vea la respuesta formarse en vez de esperar frente a una pantalla en blanco.
La buena noticia es que Strands trae streaming asíncrono de fábrica con stream_async, pensado justo para frameworks como FastAPI. En lugar de un callback handler que escribe a la terminal, iteramos los eventos del agente y los mandamos por la red. Son los mismos eventos que antes coloreaban la terminal; solo cambia el transporte.
Y como ya migramos a la memoria nativa, el endpoint queda más simple: el session_manager se encarga de cargar y guardar la conversación por session_id. Nosotros solo construimos el agente con ese manager y mandamos el stream.
# api.py from fastapi import FastAPI from fastapi.responses import StreamingResponse from pydantic import BaseModel from supabase import create_client from strands import Agent from strands.agent.conversation_manager import SlidingWindowConversationManager from strands.session.repository_session_manager import RepositorySessionManager
from code_copilot.config import SUPABASE_URL, SUPABASE_KEY, sanitizeSessionId from code_copilot.memory.supabase_repository import SupabaseSessionRepository from code_copilot.model import buildBedrockModel from code_copilot.tools import ALL_TOOLS
defbuildServiceAgent(sessionId: str) -> Agent: """Build the agent wired to the native session + conversation managers.""" session_manager = RepositorySessionManager( session_id=sessionId, session_repository=SupabaseSessionRepository(_supabase), ) return Agent( model=buildBedrockModel(), tools=ALL_TOOLS, session_manager=session_manager, # persistence: loads/saves on its own conversation_manager=SlidingWindowConversationManager(window_size=20), callback_handler=None, # async streaming, not the CLI handler )
@app.post("/chat") asyncdefchat(request: ChatRequest): sessionId = sanitizeSessionId(request.session_id) agent = buildServiceAgent(sessionId) # history is restored by session_id
asyncdefstream(): asyncfor event in agent.stream_async(request.message): if"data"in event: # a text chunk from the model yield event["data"] # the session manager persists it
La memoria ya no se maneja a mano. Nota que desaparecieron el loadHistory y el appendExchange que antes hacíamos a mano. El session_manager nativo restaura el historial por session_id al construir el agente y persiste cada mensaje solo. Un cliente que manda el mismo session_id en dos requests retoma la conversación donde la dejó, igual que en la terminal, pero ahora sobre Supabase y sin código de memoria en el endpoint.
El streaming sale de mirar event["data"]. Cuando el evento del agente trae la llave data, es un pedazo de texto que el modelo acaba de generar, y lo mandamos al cliente en el momento. Es el mismo data que el callback handler pintaba en la terminal.
Nota: para streaming asíncrono, el agente se construye con callback_handler=None. El callback handler y stream_async son dos formas de consumir los mismos eventos: uno síncrono para la terminal, otro asíncrono para la red. No se usan a la vez.
Errores y timeouts: que un agente no cuelgue tu API
Poner un agente detrás de HTTP abre modos de fallo que en la terminal no te dolían. La llamada al modelo puede tardar de más. Una tool puede fallar (los scanners externos del copiloto, como Semgrep u OSV.dev, no siempre responden). El stream se puede cortar a media respuesta. Y si no haces nada, cada uno de esos casos deja un request colgado, un cliente esperando para siempre, y en el peor caso tu servidor con conexiones zombie.
Dos defensas.
Timeouts. Nunca dejes una operación correr sin límite. Envuelve el stream del agente en un timeout con asyncio, de modo que si el modelo o una tool se cuelgan, el request termina de forma controlada en vez de quedarse abierto.
Errores que no rompen el stream. Aquí está el detalle fino. Si ya empezaste a mandar tokens y algo falla, no puedes soltar un 500 seco: el cliente ya recibió parte de la respuesta con un 200. Lo correcto es emitir un evento de error dentro del propio stream y cerrar limpio, para que el cliente sepa que la cosa se cortó y por qué.
El mismo stream() de antes, ahora envuelto en las dos defensas:
asyncdefstream(): try: asyncwith asyncio.timeout(STREAM_TIMEOUT_SECONDS): asyncfor event in agent.stream_async(request.message): if"data"in event: yield event["data"] except TimeoutError: # Never leave the request hanging: emit an error event, close clean. yield"\n[error] request timed out\n" except Exception as streamError: # a tool failed, the model errored, etc. yieldf"\n[error] {type(streamError).__name__}\n"
Nota:asyncio.timeout() existe desde Python 3.11. El proyecto ya corría en 3.11+, así que encaja; en 3.10 el equivalente es envolver el stream con asyncio.wait_for. Desde 3.11 asyncio.TimeoutError es un alias de TimeoutError, por eso el except captura este último.
Un par de cosas aquí. Ya no persistimos a mano: el session_manager nativo guarda cada mensaje por su cuenta, así que un timeout no deja la memoria a medias sin que tengamos que tocar un finally. Y el mensaje de error dice el tipo de fallo, no el valor de un secreto ni el stack completo: la misma disciplina de no filtrar información que el copiloto aplica en sus tools, ahora en la capa HTTP.
Es el mismo principio de la degradación elegante que ya usamos con los scanners: un agente que se cae ante el primer problema no sirve en producción. La pregunta correcta sigue siendo "¿qué le entrego al cliente con lo que sí funcionó?".
Evaluar el RAG y el endpoint
Cada capa nueva trae un modo de fallo nuevo, y si no lo mides no sabes si tu sistema mejoró o empeoró.
El RAG tiene uno particularmente incómodo: puede recuperar fragmentos irrelevantes, o peor, hacer que el agente invente código que no existe porque el retrieval no le trajo lo correcto. No basta con que la respuesta final "suene bien".
Para el retrieval, la métrica es recall@k: tomas preguntas cuya respuesta sabes en qué archivo o símbolo está, corres search_code, y verificas que el fragmento correcto aparece en el top-k. Es binario y reproducible.
1 2 3 4 5 6 7 8
defevaluateRetrieval(retriever, cases, k: int = 5) -> None: """recall@k: does the known-correct file show up in the top-k hits?""" hits = 0 forcasein cases: results = retriever.invoke(case["question"])[:k] paths = {r.metadata.get("path") for r in results} hits += case["expected_path"] in paths print(f"recall@{k}: {hits}/{len(cases)}")
Para el endpoint, los checks son sobre comportamiento, no sobre texto exacto: que /chat responda en streaming, que respete el timeout, y que ante una tool caída degrade sin colgarse. Es la misma idea del pipeline determinista que el copiloto ya usa como infraestructura de evaluación reproducible; aquí se extiende a la capa HTTP.
Esto es apenas la semilla: más adelante la evaluación crece a correr en CI y a atrapar regresiones. Pero la disciplina arranca ahora: mides el retrieval y el endpoint, no solo la respuesta final.
Lo que quiero que te lleves
Esto no trata de "conectar LangChain". Trata de la frontera de responsabilidades que hace que sumar una librería no te explote en la cara:
Strands orquesta, LangChain recupera. Una sola capa de orquestación; nada de agente de LangChain encima del que ya tienes.
El chunking de código define el retrieval: por símbolo cuando el lenguaje se parsea bien (reusa tree-sitter), por archivo como fallback robusto.
search_code es una tool más: el agente decide cuándo buscar, LangChain solo responde qué devuelve, detrás de una interfaz que puedes cambiar.
RAG no es memoria: conocimiento del repo contra historial de conversación. Dos stores, dos propósitos.
No sumes una librería por sumar. Agrégala solo donde aporta un valor único que no quieres reimplementar.
Al pasar a servicio, cambiamos la memoria casera por la nativa del SDK: extender SessionRepository para enchufar Supabase (PostgreSQL) y heredar el ciclo de sesión de Strands. La interfaz casera era para aprender; el SessionRepository es para producción.
Un agente detrás de HTTP necesita streaming, timeouts y errores que no cuelguen el request.
Cada decisión aquí prepara la que viene. El servicio HTTP no es el final, es la base sobre la que se monta lo que sigue.
Qué sigue
El siguiente paso del copiloto es dejar de ser uno para volverse muchos: un equipo de agentes especializados. El servicio HTTP que armamos hoy es justo la base para orquestar varios agentes detrás de una misma puerta.
Mientras tanto, el ejercicio, sobre el copiloto con RAG y API:
Indexa un repo real con chunking por archivo y luego con chunking por símbolo, y mide recall@5 sobre 5 preguntas cuya respuesta ya conoces. ¿Cuál recupera mejor, y por qué?
Agrega un timeout al POST /chat y provoca una tool lenta a propósito para verificar que el request no queda colgado.
Reto de arquitectura: encuentra en tu código un punto donde te tentó usar LangChain para orquestar, y explica cómo lo mantuviste en solo-retrieval con Strands al mando.
El código: clona la carpeta del episodio en github.com/hsaenzG/Copiloto-de-Codigo, indexa un repo real y consúltalo vía POST /chat en streaming. Ahí también está el copiloto completo, por si quieres ver de dónde salen las piezas que reusamos aquí (el recorrido del repo, tree-sitter, la memoria).
La serie #PausaYConstruye: cada entrega agrega una pieza a este mismo copiloto. Si quieres el hilo completo, en el repo y en el canal Soy Hazel Sáenz están las entregas anteriores (cómo nació el copiloto y cómo aprendió a recordar) y las que siguen.
¿Te resultó útil? Compártelo con tu equipo o cuéntame qué repo vas a indexar primero. Y si ya estás integrando librerías de retrieval a tus agentes, me encantaría saber cómo mantienes la frontera entre quién orquesta y quién recupera.
Any opinions in this article are those of the individual author and may not reflect the opinions of AWS.
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.




Loading article