

¿Y si los agentes dejaran de escribir código tradicional? Lo pusimos a prueba con IR y WebAssembly
Una prueba de concepto sobre Agent-Native Development, representaciones intermedias y qué sucede cuando el agente mantiene la lógica de un programa sin trabajar directamente sobre un lenguaje de programación convencional.
Series: Knowledge Driven Development - KDD (9 articles)
- …
- 9¿Y si los agentes dejaran de escribir código tradicional? Lo pusimos a prueba con IR y WebAssembly This article
Durante una de las conversaciones que hemos tenido en la comunidad de TryCatch.tv surgió una pregunta que me pareció interesante llevar un poco más allá de la teoría: ¿por qué seguimos haciendo que los agentes de inteligencia artificial escriban software utilizando los mismos lenguajes que diseñamos para los seres humanos? Hoy los agentes generan aplicaciones en JavaScript, Python, Rust o Go, pero eso no significa necesariamente que esos lenguajes sean la mejor representación para que una IA construya y mantenga un programa.
No estoy diciendo que debamos abandonar los lenguajes de programación ni que la ingeniería de software haya perdido sentido. La inquietud era mucho más concreta, si un agente puede comprender una especificación, ¿podría trabajar directamente sobre una representación estructurada del programa y dejar que otras herramientas la conviertan en algo ejecutable? En lugar de quedarnos discutiendo si esto sería posible, decidimos convertir la idea en una prueba de concepto durante una transmisión.
De una idea a una hipótesis que pudiéramos comprobar
La idea se relaciona con un concepto que hemos estado explorando: Agent-Native Development, un enfoque en el que los agentes no se limitan a asistir a una persona que programa, sino que pueden convertirse en participantes activos de la construcción y evolución del software. Esto nos obliga a cuestionar algunas de las interfaces que hoy utilizamos para desarrollar, sin asumir que todo lo que conocemos debe desaparecer.
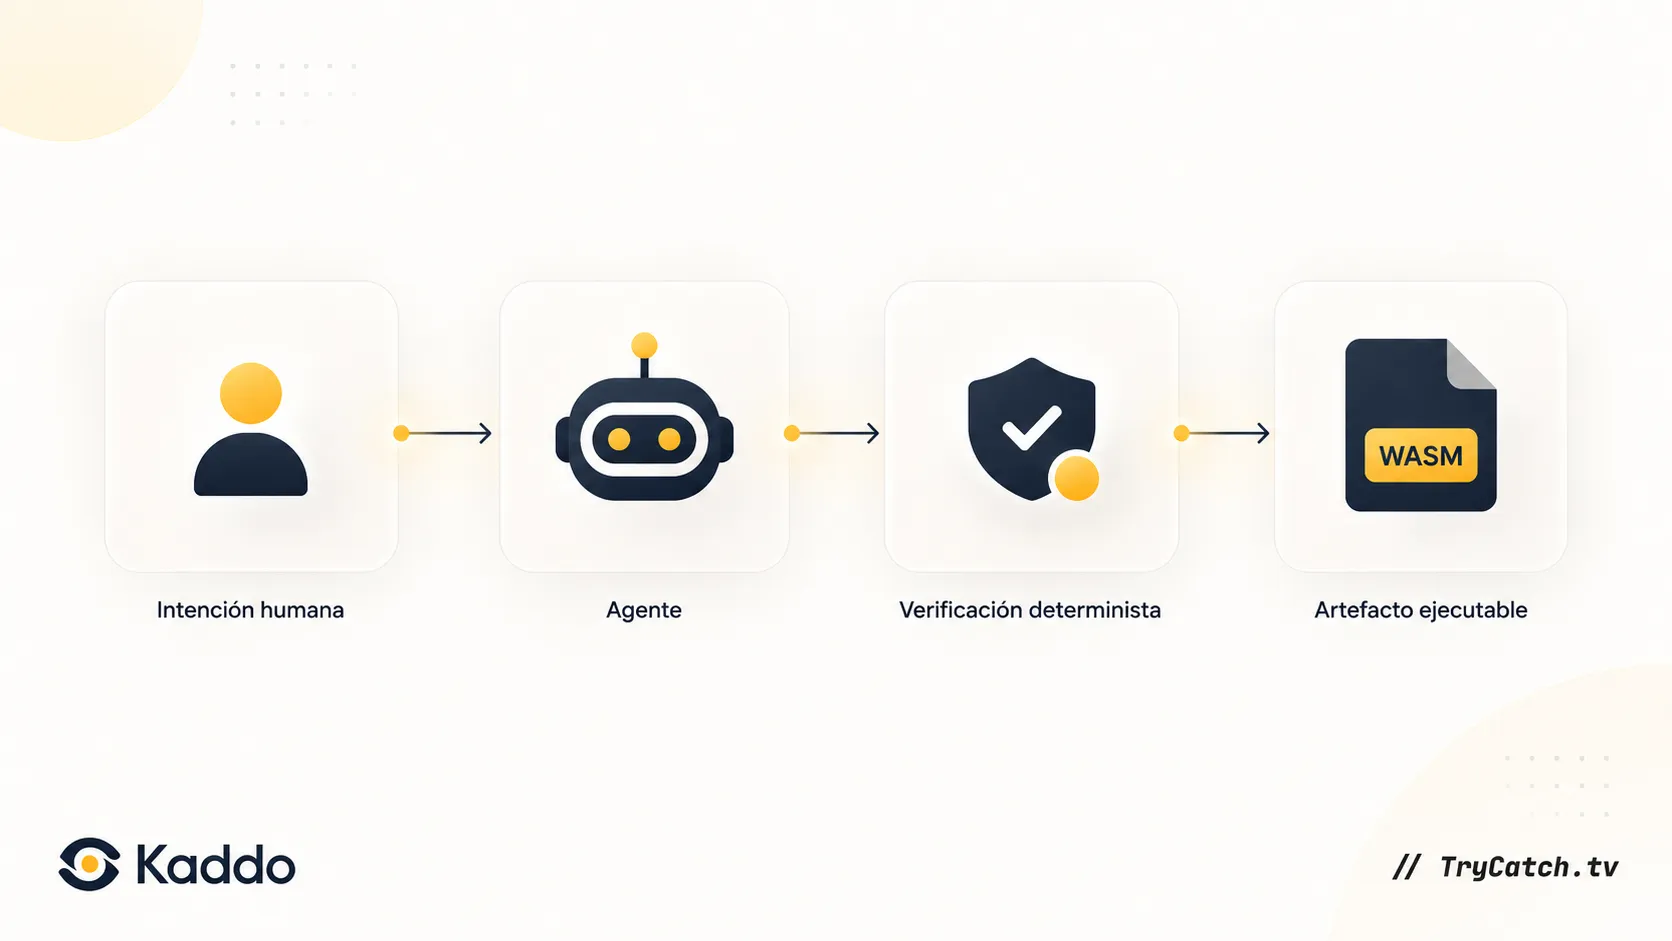
Para aterrizarlo definimos una hipótesis, un agente podría construir, corregir, extender y mantener un programa utilizando una representación intermedia semántica como artefacto principal, mientras una serie de herramientas deterministas se encargan de verificarla, compilarla y ejecutarla. La diferencia es importante, porque no queríamos demostrar únicamente que una IA podía generar un archivo válido, sino comprobar qué ocurría cuando el software tenía que evolucionar.
Para organizar el experimento utilizamos el modo POC de Kaddo , un proyecto de Knowledge-Driven Development que venimos construyendo. Allí documentamos el problema, las hipótesis, los criterios de aceptación, los Work Items y las evidencias. Kaddo no ejecutó el agente ni compiló WebAssembly; su función fue ayudarnos a mantener el experimento estructurado y tomar decisiones a partir de resultados observables.
Primero, ¿qué es una IR y por qué usarla?
Una IR (Intermediate Representation, o representación intermedia) es una forma de representar un programa para que pueda analizarse, transformarse o compilarse. Quienes han trabajado con compiladores seguramente conocen conceptos como los AST, LLVM IR o las representaciones utilizadas internamente por distintas herramientas. No estamos hablando de una idea nueva, sino de explorar un uso diferente de algo que lleva muchos años en la ingeniería de software.
En nuestra POC definimos una Semantic IR v0.1, representada mediante JSON y limitada a funciones puras, enteros de 32 bits, booleanos, operaciones aritméticas, comparaciones y condicionales. El agente no necesitaba preocuparse por detalles de sintaxis de Rust ni por cómo generar instrucciones WebAssembly. Su responsabilidad era expresar correctamente la lógica del negocio dentro de un contrato que pudiera verificarse.
El flujo terminó siendo el siguiente, una especificación describe las reglas, el agente crea o modifica la IR, un verificador comprueba sus restricciones y un compilador transforma esa estructura directamente en WebAssembly (WASM). Finalmente, ejecutamos el módulo con Wasmtime y comprobamos su comportamiento mediante pruebas funcionales. Si la representación es inválida, el agente recibe un diagnóstico estructurado para que pueda corregirla.

Aquí hubo una decisión técnica que vale la pena aclarar. Inicialmente exploramos la posibilidad de trabajar con una IR existente, como LLVM IR, o generar WAT, que es la representación textual de WebAssembly. Sin embargo, la implementación final utilizó una IR semántica pequeña y una herramienta propia,
irtool, desarrollada en Rust con bibliotecas existentes como wasm-encoder, wasmparser y wasmprinter.Eso significa que el flujo real fue IR → WASM directamente, no IR → WAT → WASM. WAT quedó como una representación de inspección del resultado, útil para entender qué instrucciones había generado el compilador. Tampoco significa que elimináramos por completo los lenguajes tradicionales, utilizamos Rust para construir la infraestructura experimental, pero las reglas comerciales que el agente debía desarrollar y mantener vivían en la IR.
Cuatro ejercicios para comprobar si el enfoque funcionaba
Decidimos utilizar un escenario intencionalmente pequeño: un motor de reglas para calcular costos de envío y descuentos. Puede parecer demasiado sencillo, pero era suficiente para comprobar diferentes situaciones que aparecen constantemente al desarrollar software. No queríamos comenzar con una aplicación enorme y terminar sin saber si los resultados dependían del agente, del compilador o de la complejidad del problema.

1. Construir el programa desde cero
El primer ejercicio consistía en implementar
calculate_shipping, una función que recibe el subtotal de una compra expresado en centavos. Si el valor es negativo, devuelve -1; si es igual o superior a 5000, el envío es gratuito; de lo contrario, cuesta 500. Entregamos esta especificación al agente y le pedimos que construyera la representación intermedia correspondiente.El resultado fue positivo desde el primer intento. La IR pasó la verificación, produjo un módulo WASM válido de apenas 76 bytes y superó las 6 pruebas públicas y 9 pruebas reservadas. El registro del experimento también indica que no se realizaron ediciones manuales sobre la IR y que no fueron necesarias reparaciones para completar este primer ejercicio.
2. Provocar un error y comprobar si podía corregirlo
Generar algo correctamente es interesante, pero mantener software también implica enfrentarse a errores. Para el segundo ejercicio introdujimos deliberadamente una referencia inválida: reemplazamos
subtotal_cents por subtotal, un parámetro que no existía. La intención era comprobar si el verificador podía detectar el problema y entregar al agente información suficiente para corregirlo.El sistema rechazó la IR y produjo el diagnóstico
E_UNKNOWN_PARAM, indicando incluso la ubicación lógica del error dentro del JSON. Con esa información, el agente corrigió la representación en un intento y recuperó el comportamiento anterior, conservando las 15 pruebas aprobadas. Lo interesante no fue solamente que encontrara un nombre incorrecto, sino que la corrección se produjo a partir de una respuesta estructurada del verificador, sin modificar el compilador.
3. Extender el programa sin romper lo anterior
Después agregamos una segunda función:
calculate_discount. Esta debía calcular un descuento del 10 % para clientes premium, devolver cero cuando el cliente no fuera premium y mantener la convención de -1 para subtotales negativos. El agente debía incorporar esta funcionalidad sin alterar la lógica de envío que ya había sido aceptada.La extensión también se completó en el primer intento, con 12 de 12 pruebas públicas y 18 de 18 pruebas reservadas aprobadas. En esta etapa ya teníamos dos funciones dentro del mismo módulo WASM, y el binario pasó de 76 a 134 bytes. Un detalle fundamental es que el verificador, el compilador y el runner habían quedado congelados después del primer ejercicio; agregar esta nueva función no requirió modificar esas herramientas.
4. Cambiar una regla de negocio y conservar el resto
Finalmente llegamos a una situación muy común, el negocio cambió de opinión. Ahora el envío debía ser gratuito a partir de
4000 centavos y costar 600 cuando no se alcanzara ese umbral. La función de descuentos tenía que permanecer exactamente igual, así que el agente debía identificar qué parte de la representación modificar y conservar el comportamiento no afectado.El cambio se realizó correctamente, nuevamente con 12 pruebas públicas y 18 reservadas aprobadas. Además, ejecutamos tres compilaciones consecutivas sobre la misma IR y obtuvimos el mismo hash SHA-256 del artefacto WASM, lo que confirmó su reproducibilidad en esas condiciones. El registro muestra que el cambio quedó localizado, que no se editó manualmente la IR y que la herramienta de compilación permaneció intacta.
¿Y qué pasó cuando lo comparamos con Rust?
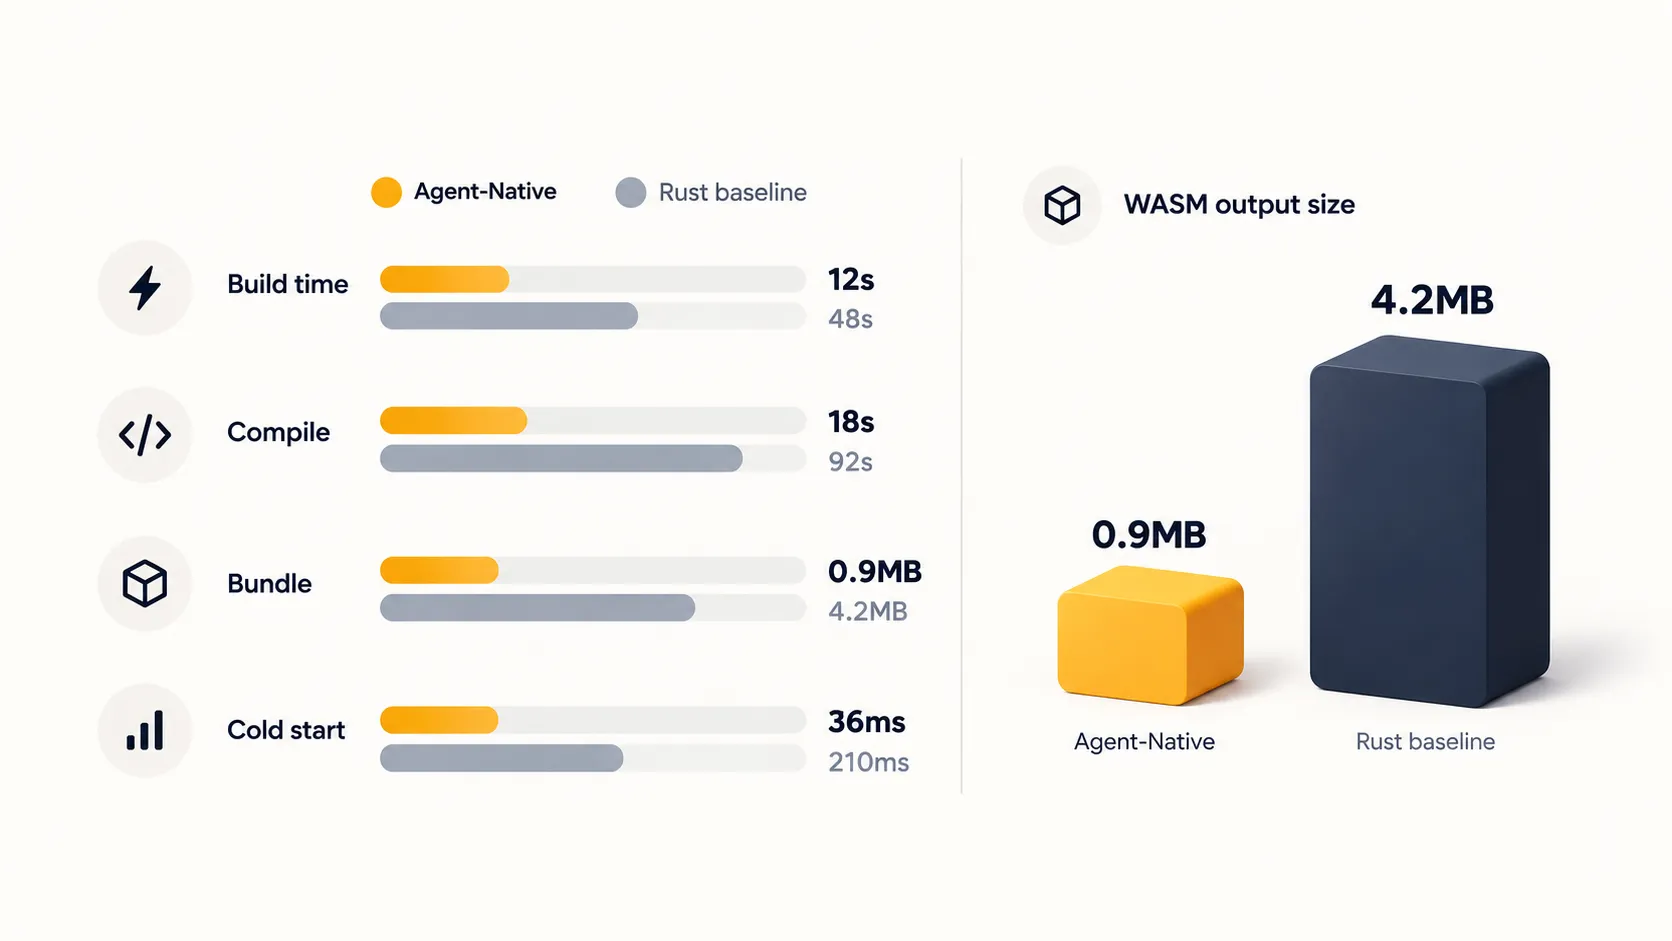
Después de los ejercicios principales realizamos un benchmark adicional, registrado en el WI-008, para comparar el enfoque Agent-Native con una implementación tradicional en Rust compilada al target
wasm32-unknown-unknown. Ambas rutas resolvieron las mismas reglas y pasaron por las mismas pruebas funcionales sobre Wasmtime. La diferencia estaba en lo que mantenía el agente y en la herramienta utilizada para producir el módulo WASM.En el enfoque Agent-Native, el agente modificaba una Semantic IR y utilizaba
irtool para verificarla y compilarla. En el baseline, trabajaba sobre código Rust y utilizaba cargo check y cargo build --release, con opciones de optimización orientadas a reducir el tamaño del binario. Esta comparación no enfrenta dos compiladores equivalentes, porque uno está especializado en un conjunto muy pequeño de operaciones y el otro es una herramienta de propósito general.Aun con esa diferencia, los resultados fueron interesantes:
EjercicioAgent-NativeRustDiferenciaConstrucción inicial27 ms1324 ms49,0×Reparación, después de corregir25 ms401 ms16,0×Extensión funcional25 ms550 ms22,0×Mantenimiento incremental25 ms508 ms20,3×
Los tiempos corresponden al ciclo determinista de verificación y compilación, no al tiempo total de trabajo del agente.
La ruta Agent-Native completó estos ciclos entre 16 y 49 veces más rápido, dependiendo del ejercicio. También produjo binarios más pequeños: 76 frente a 138 bytes con una función, y 134 frente a 205 bytes con dos funciones. Lo importante es que esas diferencias se observaron manteniendo el mismo resultado funcional en las pruebas; ambas implementaciones aprobaron el 100 % de los casos registrados.

Sin embargo, hay que tener cuidado con la interpretación. No demostramos que Agent-Native sea 49 veces más rápido desarrollando software ni que ejecute programas 49 veces más rápido que Rust. Medimos una etapa específica del proceso, después de que la representación ya estaba disponible. No tenemos una medición comparable del tiempo total de razonamiento, generación, revisión y corrección del agente, y tampoco una muestra de ejecuciones suficiente para generalizar estadísticamente esos resultados.
Uno de los resultados más interesantes no estuvo en la compilación

Durante el ejercicio de reparación también medimos el tamaño de los diagnósticos que recibía el agente. Para el mismo error,
irtool generó un mensaje JSON de 264 bytes, mientras que el flujo JSONL de cargo check produjo 6158 bytes. Ambos permitieron corregir el problema en un intento, por lo que no podemos afirmar que el mensaje más pequeño hiciera al agente más efectivo en esta prueba.Lo que sí llamó mi atención es la forma de presentar el problema. En nuestra representación, el diagnóstico indica un código de error, una ubicación dentro de la estructura y los valores esperado y encontrado. En Rust, el compilador entrega información mucho más amplia, diseñada para trabajar con archivos de código, posiciones de texto, sugerencias y diferentes herramientas del ecosistema. Esa riqueza es útil, pero también nos plantea una pregunta: ¿qué información necesita realmente un agente para resolver un problema?
Quizá una de las oportunidades de Agent-Native no esté solamente en cambiar cómo se representa el programa, sino en rediseñar las interfaces de retroalimentación. Si un agente puede consumir errores semánticos precisos, podríamos reducir parte del trabajo de interpretar mensajes pensados originalmente para una persona frente a una terminal. Es una posibilidad que merece más pruebas, especialmente para medir consumo de tokens, cantidad de intentos y capacidad de recuperación ante errores más complejos.
Lo que validamos y lo que todavía no sabemos
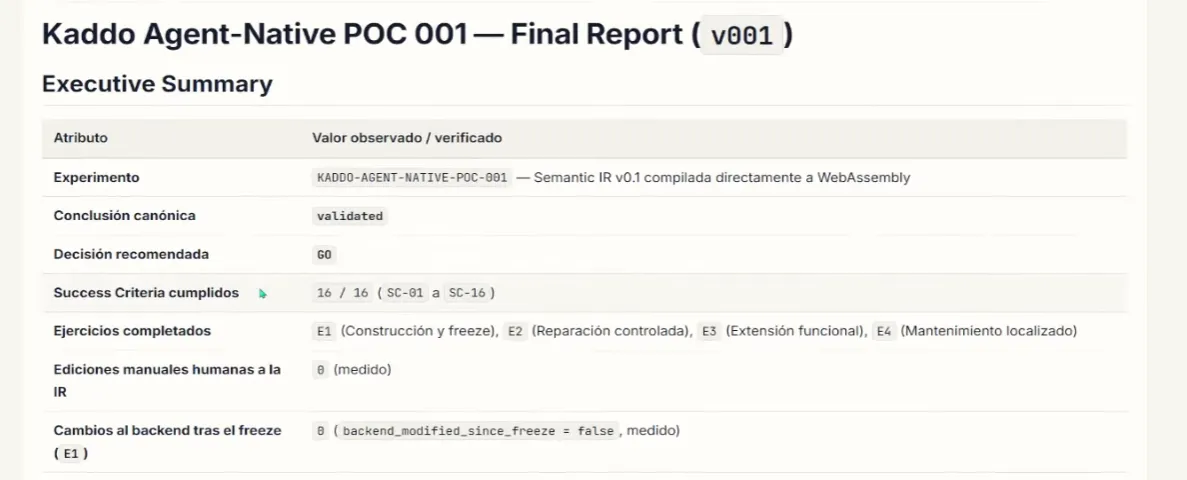
El reporte final de Kaddo registró la POC como
validated, con 16 de 16 criterios de éxito cumplidos y una recomendación de continuar investigando. Los cuatro ejercicios demostraron que, dentro de un dominio limitado, el agente pudo utilizar la Semantic IR como artefacto principal para construir, reparar, extender y mantener un programa ejecutable. También comprobamos que las modificaciones podían realizarse sin cambiar continuamente el backend y que el proceso determinista podía generar artefactos reproducibles.Esto no equivale a demostrar autonomía completa. Nosotros definimos la intención, establecimos las restricciones, controlamos las pruebas, introdujimos el defecto y decidimos cuándo avanzar entre ejercicios. Los registros indican cero ediciones manuales de IR y cero aclaraciones humanas durante las ejecuciones evaluadas, pero el experimento siguió teniendo supervisión humana. Personalmente, no veo eso como un problema, una arquitectura donde el humano define la intención, el agente implementa y las herramientas verifican puede ser bastante más interesante que intentar eliminar a la persona del proceso.
También debemos reconocer los límites técnicos. Nuestra IR todavía no maneja estructuras de datos complejas, llamadas entre funciones, acceso a archivos, HTTP, bases de datos, concurrencia o múltiples módulos. Trabajamos sobre reglas puras y un conjunto muy pequeño de tipos y operaciones. Tampoco medimos consumo de tokens ni costo de inferencia, y el ejercicio de mantenimiento produjo un cambio localizado de tres líneas tanto en la IR como en el baseline Rust, de modo que no hay evidencia suficiente para afirmar una superioridad general de mantenibilidad.
Hay un aspecto que me parece especialmente importante, esta POC no elimina la necesidad de aplicar principios de ingeniería de software. Seguimos necesitando contratos, pruebas, trazabilidad, separación de responsabilidades, control de cambios y mecanismos para detectar comportamientos incorrectos. En realidad, el ejercicio nos mostró que esas prácticas cobran todavía más relevancia cuando una parte de la implementación depende de un sistema probabilístico.
¿Qué sigue para Agent-Native?
El siguiente paso no debería ser convertir esta IR en un lenguaje de propósito general. Antes de ampliar su alcance, me gustaría comprobar qué sucede cuando introducimos composición entre funciones, estructuras de datos, módulos y reglas que empiezan a depender unas de otras. Ahí podremos observar si la representación mantiene sus ventajas o si terminamos construyendo, poco a poco, otro lenguaje de programación con todas sus complejidades.
También necesitamos repetir los experimentos con distintos modelos y sesiones independientes, además de medir el proceso completo desde que el agente recibe una especificación hasta que entrega un programa validado. Sería interesante comparar Semantic IR, LLVM IR y código Rust bajo condiciones más controladas, incluyendo consumo de contexto, costo, tiempo total, cantidad de reparaciones y facilidad para analizar los cambios. Solo así podremos empezar a distinguir qué beneficios provienen de la representación, cuáles de la herramienta especializada y cuáles del propio agente.
Por ahora, el resultado justifica continuar investigando, no llevar el enfoque directamente a producción. Y esa es una diferencia que considero importante mantener, especialmente cuando hablamos de inteligencia artificial: que algo funcione en un experimento no significa que ya esté preparado para reemplazar herramientas o prácticas consolidadas.
Una reflexión final
Comenzamos con una pregunta que podía sonar un poco descabellada: ¿y si un agente no tuviera que escribir el código fuente tradicional de la aplicación para construir software? Terminamos con una representación semántica que el agente pudo mantener durante cuatro ejercicios, un compilador que generó WebAssembly ejecutable y un conjunto de evidencias que nos permite explicar qué funcionó y qué todavía falta comprobar.
Lo que más me deja este ejercicio no son los 49× del benchmark ni los 76 bytes del primer ejecutable. Es haber comprobado que podemos separar la intención del negocio, la representación mantenida por el agente y la generación determinista del programa. Esa separación abre preguntas interesantes sobre cómo podríamos diseñar las herramientas de desarrollo cuando los agentes participan cada vez más en la construcción de software.
Quizá Agent-Native no consista en eliminar el código o hacer que una IA escriba binarios incomprensibles. Quizá se trate de encontrar representaciones que los agentes puedan modificar de manera controlada, que las personas podamos inspeccionar y que las herramientas puedan verificar antes de ejecutar. Todavía tenemos muchas preguntas por responder, pero al menos ahora tenemos un experimento reproducible para seguir avanzando, en lugar de quedarnos solamente con la opinión de si esto debería funcionar o no, y esa es precisamente una de las cosas que más disfruto hacer con la comunidad de TryCatch.tv, tomar una idea, cuestionarla, construir algo y ver qué nos dice la evidencia.
Código y evidencias
Todo el ejercicio está disponible públicamente para quien quiera revisar la implementación, analizar los resultados o intentar reproducirlos. El repositorio contiene la definición de la POC, su Semantic IR, el código del verificador y compilador, los Work Items, las ejecuciones registradas y el benchmark frente a Rust.
Repositorio: Trycatch-tv/poc-agent-native
Benchmark completo: BENCHMARK_REPORT.md
Reporte final de Kaddo: knowledge/delivery/poc-report.md
Definición del experimento: knowledge/delivery/poc.md
Live: https://youtu.be/wjvVB1XPX0A
Series: Knowledge Driven Development - KDD (9 articles)
- …
- 9¿Y si los agentes dejaran de escribir código tradicional? Lo pusimos a prueba con IR y WebAssembly This article
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article