
架构 91 分,视频 38 分:战术犯规队的 NBA 黑客松复盘
一位资深篮球解说与一位 maker,做出了基于 AWS 的篮球分析与主播制作工作台,却太晚验证那段 24 秒进攻是否已经成为完整作品。复盘三条技术链路、可播放的 AWS 架构,以及下一次真正需要改变的取舍。
在这次由亚马逊云科技中国团队与 NBA 联合举办的 Broadcast Code 12 黑客松中,我们收到的评分反馈里,AI 架构分析拿了 91 分,视频制作只有 38 分。最后,我们没有进入决赛。
最让我失落的,并不是两个数字之间的落差。到了交付阶段,我还在反复确认:视频上传好了没有?声音保住了没有?别人打开链接,能不能直接看到我们的作品?
我们确实做出了一套东西。但那段最应该被看见的 24 秒进攻,没有足够早地成为一件完整、清楚、容易观看的作品。
这篇文章想认真拆开这件事:哪些技术选择值得保留,哪些投入顺序需要改变,以及我为什么总能把一个具体命题,做成一套越来越完整的平台。

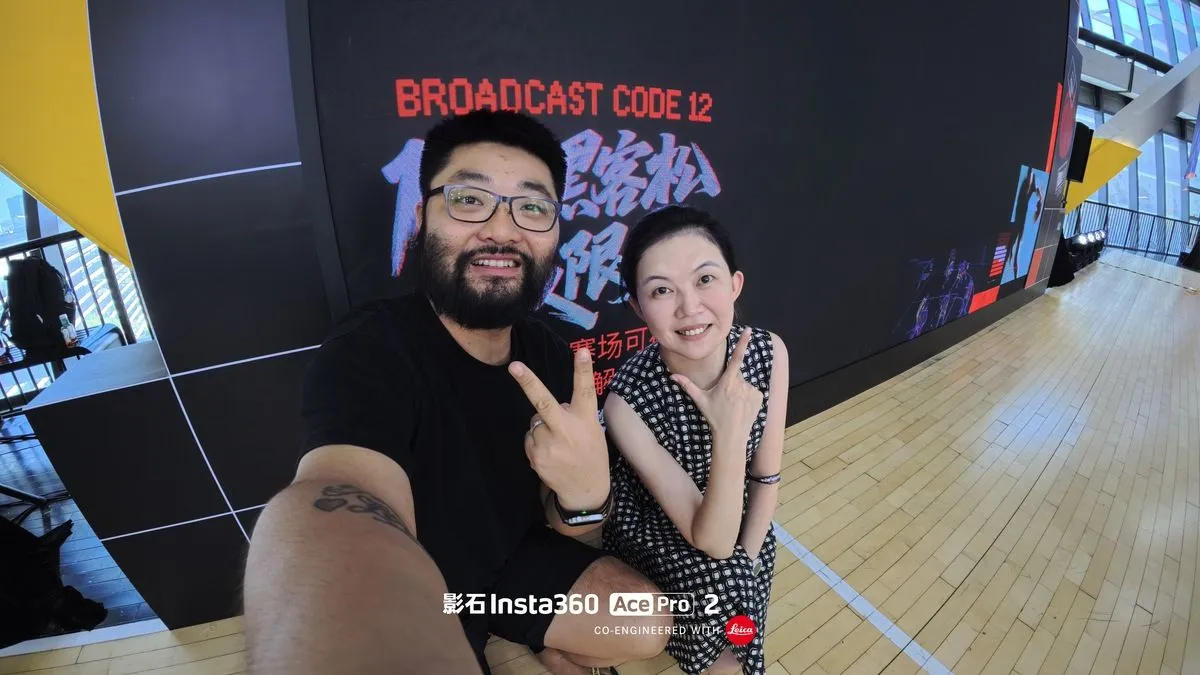
Broadcast Code 12:NBA 深度赛场可视化,让 AGENT 解读数据。现场照片来自本次参赛素材。
一位篮球解说和一位 maker,为什么做出了主播台
我们叫战术犯规队,只有两个人:我的队友是一位资深篮球女解说,我是一位资深 maker。
她熟悉一段进攻应该怎样讲:在哪里暂停,先解释谁的移动,什么时候让画面继续,哪些数字值得说给观众听。我习惯把这些需求接成工具:暂停、标注、查数据、让 AI 辅助分析,再把讲解录下来。
于是我们做了 Courtside IQ,一套围绕篮球视频的分析与主播制作工作台。主播可以核对球员身份和数据、选择关键帧、画战术线、修改 AI 解说稿、录制讲解,再把作品交给观众观看。

项目博客中保存的完整主播台截图:左侧是主播快捷操作,中间是比赛画面与球员数据卡,右侧是小Q辅助区。尚未确认的 Player 标签保留在画面里,提醒我们继续核对身份。
这些需求并不是凭空想象的。它们来自真实解说工作,也让我第一次这么具体地理解:篮球数据只有进入画面和讲解节奏,才会成为观众能接住的信息。

战术犯规队:一位熟悉篮球叙事的解说,一位喜欢把问题做成工具的 maker。这个组合带来了很多好想法,也需要更明确的取舍。
重新读赛制材料时,我被开头的一句话提醒了:“数据进去,能看的作品出来。” 比赛要求将真实比赛视频与数据结合,在画面上做可视化;同时也有 AgentCore、CloudFront Web 交互和 CDK 的技术门槛。解说可以是真人或 AI,并不是必须项。
所以,做工具本身并没有偏离全部要求。我们偏离的是重心:为了讲清一个进攻回合,我们逐渐开始追求一套能支持更多场景的完整平台,而对最终作品的验证被推迟了。
NBA 深度赛场怎样把篮球直觉变成数据
这次命题背后的平台,是 NBA Inside the Game(NBA 深度赛场),powered by 亚马逊云科技。亚马逊云科技是 NBA 全球官方云服务与云 AI 合作伙伴;双方把球员追踪、比赛事件与机器学习结合起来,让球迷理解得分、篮板和助攻数字背后的比赛过程。官方合作介绍
这里的数据科学工作,从明确问题开始:怎样定义出手难度?防守者没有抢断,也没有盖帽时,他做出的贡献怎样被记录?一个没有触球的人,为什么会改变队友的机会?再把这些问题转成特征、模型、基线和可解释的输出。
官方光学追踪系统能够采集每位球员的 29 个身体点,以每秒 60 次记录动作;各项指标实际使用的特征和算法并不相同。采集层提供时空数据,篮球规则和建模方法决定这些数据可以回答什么问题。NBA 对光学追踪与 Gravity 的介绍

四个指标关注四种不同的问题。此图是依据官方定义整理的概念说明,本项目读取并解释官方记录,不宣称复现这些模型。
投篮难度 怎样给一次出手建立基线
预期投篮命中率 xFG%,评估联盟平均球员在该出手情境下的命中可能性。模型关注位置、身体姿态和防守干扰等因素,把球员身份与个人投篮能力排除在这个情境基线之外。较低的 xFG 通常表示更难的出手;它是在出手时对情境的估计,不能被写成持球时已经提前知道某位球员会不会进。NBA 对 xFG 的定义

图源:亚马逊云科技提供的 NBA 深度赛场媒体素材。它把距离、干扰姿态和视野遮挡放回画面,说明模型可以观察哪些特征;图中数值不是本队模型计算的结果。
对主播而言,这个指标的价值,是让“这球很难”有可讨论的依据。一次命中既可以讲球员如何完成,也可以讲这个位置与干扰情境为什么不容易;这比只在屏幕上显示一个百分比,多了一层解释。
防守压力 怎样让持续施压进入统计
防守压力分数 DPS 把距离、传球路线、阻挡、速度和方向等防守原则转成可计算的量。系统再根据压力关系匹配主要防守者,将这些关系与比赛事件结合,形成 Defensive Box Score(防守数据统计)。压力测量与防守统计有关联,但不是同一个字段。NBA 对 DPS 的说明
压力高也不自动代表整体防守成功。例如,两人夹击持球者可以让他的压力很高,同时给弱侧留下机会。解说需要把数字、对位和场上选择放在一起,说明压力作用在谁身上,以及它为其他人留下了什么空间。
球员引力 怎样衡量没有触球时的牵制
Gravity(球员引力) 比较实际吸引到的防守压力,与球和进攻方空间分布所对应的预期防守压力,再将差异转成便于比较的分数。它帮助解释持球和无球状态下的牵制:一个人没有出手,也可能让防守偏移,为队友让出突破或传球通道。NBA 对 Gravity 的定义
这给了我们一个重要提醒:镜头中的持球者未必是唯一值得标注的人。好的可视化应让观众看见牵制发生在哪里,以及谁受益,而不是只给拿球的人贴一张数据卡。
胜率影响力 怎样区分事件与它可能的另一种结果
Leverage Score(胜率影响力) 先根据比赛状态估计胜率,再比较实际发生的事件与反事实结果,最后把贡献分配给相关球员。例如,一次三分命中后的胜率,与“投篮不中、对方取得防守篮板”的胜率进行比较;其意义不同于简单计算回合开始和结束之间的变化。创造机会、完成出手、防守和篮板,都可能进入贡献分配。NBA 对 Leverage 的说明

图源:亚马逊云科技提供的媒体素材。页面选择的是 2025–26 季后赛;红圈中的 3.43 属于该统计范围的 TOT LVG 汇总,不能当成某一次补篮的事件分值。
这也改变了高光选择的问题:除了进球是否漂亮,我们还可以问,它在当时的比赛状态下有多关键,机会由谁创造,哪些没有直接得分的动作也值得被讲出来。
亚马逊云科技怎样支持这些数据科学工作
在 AWS 公开的 Leverage 技术方案中,Amazon EKS 运行容器服务,Amazon Managed Service for Apache Flink 按事件时间关联追踪、事件与上下文指标;S3 保存历史数据和模型产物,DocumentDB 保存回合元数据与结果,Direct Connect 和 Cloud WAN 支撑场馆连接。LightGBM 估计胜率,系统对不同结果进行推理,再做球员贡献分配。官方技术架构
从这个公开方案中,我最想学习的是:模型、数据流和篮球语义要一起设计。事件可能乱序到达,出手情境指标与回合结果需要在正确的时间窗口内关联;服务之间协调得好,模型结果才有机会及时进入观赛体验。这是对官方 Leverage 方案的分析,与下文我们自己的黑客松架构分开理解。
本队面对的是另一层工作:把授权提供的官方记录接回具体视频,让主播讲清楚。 我们拿到的出手时刻数据,不能直接填满整段视频的逐帧状态;单机位视觉观察也不能冒充官方多机位追踪。我们应该把指标的来源、球员、时刻与统计范围展示清楚,再用画面和语言帮助观众理解。
这让我重新理解了赛题:数据科学已经把很多难以察觉的关系变成了指标,我们要完成的,是让这些关系在那段 24 秒进攻里真正被看见。
做对的第一件事:把视频处理、视觉观察和官方事实分开
一段篮球视频看起来只有二十几秒,进入系统后,却包含好几种完全不同的工作。
大文件上传不应该一直占着交互请求。我们的素材通过预签名上传进入 Amazon S3,由 AWS Step Functions 编排后续处理,AWS Lambda 执行各个应用步骤;AWS Elemental MediaConvert 承担转码与帧准备相关工作。原片和较大的分析文件留在 S3,任务状态与索引放进 Amazon DynamoDB。
这样做的价值是:主播看到的是可追踪的处理状态,后台可以按阶段留下结果。一次处理失败,也更容易知道失败发生在素材、视觉推理还是后续分析环节。

从视频到可复核的数据:上方是素材处理链路,下方分开呈现模型观察和 NBA 官方记录,再由主播对照具体时刻与身份使用。
视觉部分,我们在 Amazon SageMaker AI 实时推理端点上运行自定义 GPU 容器,把检测、分割、姿态和相对深度模型接到统一的输入输出契约上。这里做的是部署与集成已有模型,并不是从零训练一套篮球基础模型。SageMaker 实时推理文档
例如,RF-DETR 检测提供候选目标,SAM2 帮助突出选中的球员,ViTPose 提供二维关节观察,Depth Anything V2 提供相对前后层次。Amazon Rekognition 的文字检测则用于比分牌、号码等 OCR 线索。
这些输出各有用途,也各有边界:SAM2 在这里主要是逐帧图像分割,不能据此声称已经实现稳定的跨镜头身份追踪;相对深度也不能直接变成球员之间的米数。
更重要的是,视觉模型的观察不能冒充 NBA 官方数据。赛题提供的深度数据是出手瞬间的数据点,并不包含整段视频的逐帧轨迹。我们需要核对比赛、时间、身份和事件,再把可引用的数据放回对应画面。身份没有确认时,就应该保留未知。
我很喜欢 NBA Inside the Game 提出的那些观察角度:出手质量、防守压力,以及球员如何影响空间。但在我们的系统里,读取官方记录、展示它们,与自己计算同名指标,是两件不同的事。我们没有复现 NBA 的专有模型,也不能把一张图像里的空位,直接说成经过验证的传球成功率。
做对的第二件事:让 Agent 给出有依据、可以修改的解说
我们没有只给大模型一张画面,再等它写一段听起来像篮球解说的文字。
视觉理解和推理通过 Amazon Bedrock 调用模型;智能体应用部署在 Amazon Bedrock AgentCore Runtime。视频预分析流程使用 Strands Agents SDK 的图编排,把任务分为三个角色:先检查证据,再组织战术解读,最后复核表达。实时与暂停帧提问另走单 Agent 与工具路径。AgentCore Runtime 文档 、Strands Graph 文档
对应的代码节点是
evidence_planner → tactical_analyst → evidence_editor。每个角色面对同一份结构化底稿,但职责不同:哪些身份有冲突,哪段动作需要补证,哪些结论能成为主播短句,哪些内容应该留在未解决的问题里。
视频预分析使用 Strands 三节点流程;程序检查证据和身份,主播编辑并确认稿件后保存。实时或暂停帧问答另走单 Agent 与工具路径。
我们还在模型输出之外做了程序校验:引用的证据是否存在,时间是否在片段范围内,姓名是否已经与那一时刻的轨迹建立关联。官方比分和累计统计由程序读取并展示,避免让模型重新编一遍数字。实现可以看这段 Strands 编排代码 。
这仍然不能保证每条战术解释都正确。它至少让我们知道,应该从哪份证据开始检查,而不是只判断一句话听上去像不像专家。
主播等待生成的时间也提醒了我们:已经分析、核对过的内容,应当成为可以继续制作的资产。 我们把关键帧分析和可编辑的解说稿保存下来;录制时优先读取已保存的内容,而不是每次点击都重新等待模型。证据变化时,需要提示重新检查,不能悄悄沿用旧结论。
声音方面,我们接入 Amazon Transcribe Streaming,把主播麦克风输入转成文字;用 Amazon Polly 把确认后的文本生成语音。语音识别、内容核对和文本转语音是不同环节,Polly 本身不会判断篮球事实,也不等于已经完成了主播声音克隆。
我最想留下的方案:让 AWS 架构图可以点,也可以播放
这次项目里,我最喜欢的一个成果,是动态架构说明。
服务一多,静态架构图很容易变成一张需要作者站在旁边讲解的海报。我想让读者自己回答更具体的问题:上传一个视频后会发生什么?主播问 AI 时走哪条路径?制作好的作品怎样进入公共观看入口?

架构预览。完整交互版按用户流程组织,节点说明包含职责、代码依据与限制;这是基于仓库实现的逻辑架构说明,不是对在线资源的实时审计。
我们把完整架构放在下面,上面用类似文件夹标签的方式切换“上传与分析”“主播互动”“节目交付”“安全与运维”。点击播放,当前步骤会高亮对应的服务和连线;点击节点,则可以查看它负责什么、实现在哪里、哪些能力尚不能保证。
适应画布也不是简单缩小几个节点,而是让当前流程的完整图参与缩放计算。读者可以逐步播放,也可以把当前流程的完整图导出成独立 SVG,再用于文章或演示。

交互架构的实际页面:选择流程步骤后,对应服务和连线高亮,下方展示职责、实现依据与运行限制。截图保留了历史页面中的队名文案。
对我来说,这张图最有价值的地方,是迫使我们把边界讲清楚。Roboflow 的可选云端检测应放在 AWS 边界之外,并说明哪些帧会发送到外部;Tripo 用于制作吉祥物模型资产,网页里的动作由本地代码驱动,不能画成每次点击都会调用生成 API。IAM、Secrets Manager 和 CloudWatch 则分别支撑权限、密钥管理和运行观察。
我把这种方法整理成了一个可复用的 AWS 交互架构 Skill 。它帮助作者从代码证据出发解释系统,而不是把更多服务图标塞进一张图。另一位 builder 可以替换节点、流程和实现依据,得到自己的架构说明。
架构分析 三个关键取舍与代价
重新看这套架构,我觉得值得分析的是它如何处理三种不同的约束:素材处理可以等待,主播操作需要及时反馈;模型观察包含不确定性,官方记录需要保留来源;画面能够暂停,节目时间还要继续。
第一,把异步准备与当前画面问答分开。 上传后的转码、分批视觉索引和预分析留下阶段结果;主播暂停提问读取当时冻结的证据包。预分析可以看到完整回合,当前画面问答则需要限制可见事件,避免提前泄露后续结果。代价是两条路径都要维护源时间、版本和身份约定;缓存没有跟随标注更新时,回答即使生成得快,也可能对应旧画面。
第二,把模型观察与官方事实分开。 比分牌和比赛时钟只能帮助近似定位,确认出手帧还要核对动作。视觉模型提供候选人物、轮廓、关节和相对空间线索,官方指标则需要对应到比赛、球员、事件和统计范围。人工确认身份或稿件,代表批准本次使用,并不会自动把未验证的观察变成官方事实。这样设计增加了复核工作,却让错误能够定位到具体证据。
第三,用版本化资产换取制作过程中的复用。 已审核稿件绑定证据版本,录制时优先复用;原片、固定节目音轨和 JSON 操作记录分开保存,让暂停讲解不必立即重编码整段视频。代价是作品依赖自己的回放器,必须正确同步图层、源时间与声音;交付普通 MP4 时仍需合成。这改善了修改与复用,却不能代替最终成片验收。
逐项拆开技术架构 每个服务为什么在这里
下面六组图分别拆开一次操作经过的服务。打开六组 GIF 流程动画 ,可以逐步观看节点与连线高亮,也可下载 GIF 原件。Builder Center 正文展示静态总览;动画用于解释源码中的逻辑路径,不调用 AWS,不表示实测延迟。
这套系统的主线,是把主播的一个动作变成可复用的结果:上传视频后留下证据,暂停时生成可检查的建议,确认后保存稿件,最后把作品交给观众。服务的选择要围绕这些动作,而不只是把模型串起来。
入口与控制面

流程总览,按源码中的职责区分入口和支路;配套 GIF 展示逐步流转,不调用 AWS。
CloudFront 负责网页入口与缓存策略。 静态站点桶通过 Origin Access Control 读取,页面和公共资源可以缓存,
/api/* 请求则转到 HTTP API 并关闭缓存。这样,主播不会把旧的分析状态误当成刚刚完成的结果。WebSocket 另有 WSS 地址,用于会话交互,不能把所有请求都画成经过 CDN。入口配置 API Gateway 与 Lambda 负责应用控制。 API Gateway 接收请求,路由 Lambda 校验操作范围并读取状态;耗时分析交给异步 Worker。这样,控制按钮可以尽快返回状态,模型推理不必占住同一个交互请求。主播和导播的权限由应用的会话能力令牌校验。
Cognito 解决浏览器临时语音权限。 Identity Pool 为开启麦克风转写的浏览器提供临时凭证,用于直连 Transcribe。这里应把“允许转写”与“允许控制节目”分开理解,不能因为浏览器拿到了临时 AWS 凭证,就认为它获得了主播权限。
媒体任务与版本化存储

大文件直传和异步处理流程总览;配套 GIF 展示逐步流转。
S3 保存文件,DynamoDB 保存状态与关联。 原片、抽帧、官方快照、分析 JSON、节目音轨和制作清单留在 S3;DynamoDB 保存查询项、处理状态、版本指针和审核记录。关键帧及历史版本可以追溯,更新时通过版本检查避免旧请求覆盖新修改。共享作品的媒体文件使用限时链接读取,媒体桶整体保持私有。
EventBridge 与 Step Functions 把上传接成持久任务。 已注册 MP4 的对象事件触发幂等启动,再由状态机协调转码、轮询、视觉索引、号码读取和后续推理。使用状态机的原因是,这些步骤持续时间不同,也可能分别失败;留下阶段结果,才有机会定位问题、复用已完成的工作。任务编排
MediaConvert 承担媒体格式处理。 它负责转码和抽帧;成片转码路径接收应用已经合成的
program.webm。我们自定义的暂停、图层与节目时间 JSON,由浏览器回放器解释,不能把它描述为 MediaConvert 原生支持的剪辑指令格式。视觉观察与模型推理

视觉输出、OCR 线索与官方证据分别处理;相对深度不代表米数。配套 GIF 展示逐步流转。
SageMaker AI 承载自定义视觉服务。 后端把 JPEG、帧编号和源时间交给 GPU 实时端点,在统一容器接口下取得检测、分割等观察。ViTPose 在归档分析分支运行,深度网格用于诊断。选择托管端点,是为了把模型依赖和 GPU 环境放在一个可控边界中;端点创建成功,并不代表篮球身份识别已经可靠,也不代表闲置时自动没有成本。视觉服务实现
Rekognition 提供 OCR 线索,Bedrock 提供视觉与语言推理。
DetectText 读取比分牌或号码裁剪;姓名、比赛和事件仍需关联核对。Qwen 通过 Bedrock Converse 接收选定图片与结构化上下文,并不是直接读取整场 MP4。把帧、时间与证据编号一起传入,才能让解释回到一个可检查的时刻。Agent 的运行环境与解说资产

区分预分析、实时问答与版本化播报;Transcribe 是语音输入,Polly 不等于声音克隆。配套 GIF 展示逐步流转。
AgentCore Runtime 托管应用,Strands 组织应用内部的工作。 live 与 prep 两个 Runtime 复用代码包,模型调用由 Bedrock 完成。预分析使用三节点图,暂停帧问答使用单 Agent 与工具;冻结关键帧证据包并检查版本,可以减少重复查询,也能识别回答期间画面已经改变的情况。当前 Runtime 配置使用 PUBLIC 网络,模型调用还涉及 global profile;网络边界与推理区域需要按实际配置解释。运行配置
关键帧稿件是版本化资产。 文本、语言和对应标注版本一起保存;重新运行分析不直接覆盖人工修改,标注改变后提示旧稿需要复核。这样,录制中的一次“播放 AI 解说”可以复用已确认结果,而不是重新启动整个推理流程。
Transcribe Streaming 与 Polly 分别处理输入和输出。 浏览器明确开启麦克风后,将 PCM 音频直接发送给 Transcribe,公开字幕先进入待审区。Polly 根据确认文本生成 MP3 和 speech marks,应用按文本与声音设置的哈希复用音频。中英文切换使用分别审核的字幕稿;自动翻译与主播声音克隆没有在这次实现中完成。稿件与配音缓存
从浏览器录制到公共节目

这里是录制作品的同步循环回放;CloudFront 页面不代表接入 NBA 实时视频流。配套 GIF 展示逐步流转。
Web Audio、原片解码与 Canvas 各自负责一部分。 浏览器混合原声、明确开启的主播麦克风和获准公开的配音,私人助手声音被排除。回放器播放原片,Canvas 重放图层,独立节目音轨推进时间,所以暂停原片时仍能讲解。混音完成后是一条固定音轨,修改文字需要重新生成或录制声音。
共享作品先完整保存,再进入公共回放。 原片、音轨和 JSON 清单上传 S3 后,后端检查文件与清单,齐全才置为 READY。公共
/broadcast 读取 DynamoDB 的固定节目记录,根据起播位置、更新时间和节目时长计算循环进度;观众端定期校正并续期媒体链接。这里共享的是作品与节目时钟,CloudFront 提供观看页面;浏览器仍可能要求观众点击开启声音。公共回放实现 运维和可选第三方

运维能力横切各路径,第三方调用由可选入口触发;SQS 不是正常请求队列。配套 GIF 展示各支路。
IAM、Secrets Manager 与 CloudWatch 支撑权限、密钥和定位问题。 IAM 控制服务调用、指定端点和 MediaConvert 的角色传递;外部密钥由授权后端从 Secrets Manager 读取;CloudWatch 收集执行日志和失败指标。部分策略仍有通配资源,告警通知与处置也需要补齐,因此不能把“配置了这些服务”写成已经完成了全面安全审计。
SQS 保存异步 Worker 的未处理失败。 它在这条链路中是
onFailure 目的地,便于保留失败请求;当前没有正常请求消费或自动重放逻辑。图里的失败支路应单独标明,不能让读者误以为每次问答都先进入 SQS。异步 Worker 配置 Roboflow 和 Tripo 位于两种不同的外部边界。 用户显式开启 Roboflow 云诊断后,少量 JPEG 才发送到外部,诊断结果独立保存;主视觉路径仍在 SageMaker 容器内推理。Tripo 用于创作带材质和骨骼的角色资产,生成的 GLB 进入网页后由本地代码驱动动作。一次制作资产与每次运行互动,是两段不同的工作。
但这也正是我需要警惕的地方:架构解释做得好,是一个成果;它不能替那段比赛视频完成叙事。
做对的第三件事:把原片、声音和操作记录分开保存
录制时,我们遇到了一个很实际的问题:主播暂停视频讲了十秒,原片没有前进,节目却应该继续。
如果只用视频当前秒数作为所有内容的时间轴,字幕、画线和声音就容易错位。如果每改一次解说都重新录屏,又会增加等待和画质损耗。
我们采用了原片、独立节目音轨与 JSON 操作记录组合的方式。JSON 保存暂停、继续播放、源视频位置,以及图层出现和消失等操作。回放时播放原片,同时按节目时间重放这些操作。

示意:原片停在同一帧时,节目时间仍然前进,声音和图层按节目时间播放。图中数值仅用于解释机制。
这样,保存一件作品不必立即把所有像素重新合成一遍。我们可以先保留源文件和制作决定,后续再回放、选取高光,或合成为可下载视频。已录节目的混音是固定音轨,修改口播需要另行生成或录制声音。需要说明的是:保留原片资产,不等于最终合成文件无损。 将声音、暂停和图层压成一个普通视频文件,仍然需要渲染和重新编码。
交付给观众时,作品也不能只存在主播的浏览器或私人 session 里。我们为共享作品与公共播出建立独立入口,通过 Amazon CloudFront 提供观看页面,并支持已录节目循环回放。这里的“播出”是处理后节目的公共回放,不是已经接入 NBA 实时直播源。
这些修复都很必要。问题是,我们太晚才把“另一台设备能独立看完”当成完整交付来验收。
视频为什么只有 38 分:我把“还能完善”排在了“已经讲清”前面
我不能用两个维度的反馈还原全部评审过程,也不想替评委猜原因。但它们让我看见了一个很具体的投入失衡。
我们一直在问:模型还能不能看得更准?标注能不能持续保存?主播台能不能更顺手?吉祥物能不能多一个动作?这些问题单独看,都有道理。
可真正面向观众的问题,需要更早被回答:
- 第一个关键帧为什么停在这里?
- 数据卡对应的是哪个球员、哪个时刻?
- 观众能否看出防守如何变化,而不只是读到一堆数字?
- 解说有没有给画面留时间?从开始到结束,能否顺畅地看完?
本来应该服务于这段叙事的工具,逐渐变成了我们主要展示和完善的对象。我们在平台里能完成很多操作,却没有足够早地用一段完整作品,检验这些操作是否值得观众的注意。
后来看到其他团队用 Claude、Three.js 和 shader,把数据组织成直观的画面,我的第一反应是懊恼。现在再看,视觉表达同样需要工程判断:选什么信息、什么时候出现、怎样跟随人物、怎样让观众一眼理解。把它说成“只是渲染得好看”,会让我再次避开自己的问题。
我也不能把偏移全部归给需求增加。AI 编程助手确实让每个想法都更容易变成“接着就做”,但决定继续扩张的人仍然是我。每加一项能力,我都应该说清:它改善成片里的哪一处,又会挤掉哪一次检查。
架构的 91 分值得保留,视频的 38 分也需要正视。两件事可以同时成立:我们解决了一些真实的工程问题,却没有把这些成果足够好地组织成这次命题最需要的作品。
下一次,我要让复盘改变实际决定
我不想再用“下次注意控制范围”结束。下一次需要留下能检查的约定。
第一,先完成一段能独立看完的样片。 最小必要的云端链路跑通之后,尽快做出包含关键帧、数据叠加和本队目标解说的完整片段。让没参与开发的人用新的浏览器打开,从头看完。先观察他理解了什么,再决定补哪个功能。
第二,每个新增功能都说明取舍。 如果它不能对应到一个具体画面、一句更准确的解说或一次更可靠的交付,就先进入待办。即使值得做,也要明确暂缓什么。AI 助手除了协助实现,也应该帮助我维护这份暂缓清单。
第三,把交付彩排当成正式工作。 声音、字幕、人物对应、图层清理、链接权限、跨设备观看和循环播放,都应该在交付前验证。环境稳定后,再按同一段素材记录模型调用、音频处理和 SageMaker 端点运行时长,评估实际成本,不凭服务清单推算“便宜”。
这些约定还没有经过下一场比赛验证。有没有改变,最终要看我再次遇到一个很想做的功能时,能不能让它等到样片通过之后。
还有一些,很想珍藏的现场记忆
这次我也带去了用 ChatGPT 创作的贴纸,主题来自 Dr. Werner Vogels 的 2025 年 re:Invent 演讲。能亲手把贴纸送给他,再一起拍照“集邮”,对我来说是一件特别荣幸的事。

把屏幕里的创作变成一张能递到本人手里的贴纸,是这次活动里很珍贵的时刻。
我们还在现场见到了篮球传奇球员 肖恩·马里昂(Shawn Marion)。平时通过比赛画面和数据认识的人,真实地站在面前,感觉很奇妙。

与 Shawn Marion 等嘉宾一起留下的现场合照。
没有进入决赛,还是会失落。我也愿意继续整理这次留下的代码、视觉推理实践、视频制作记录和动态架构方案,让其他 builder 少绕一些弯路。
但下一次,我希望先拿出一段别人能够独立看懂的作品。然后再决定,那套工具还需要长多大。
项目与延伸阅读
本文为个人参赛实践与复盘。91 分与 38 分为本队收到的两个维度的评分反馈,不作为正式总分或排名表述;服务能力以文中实际实现范围为准。
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article