
Serverless DeepDive #10:一時ファイルの置き場所を比較してみる
/var/task、/tmp、S3への書き込みと読み出しを比べます。次の呼び出しや別の関数から内容を読み直し、作業用ファイルと処理結果の保存先を考えます。
Series: Serverless DeepDive (13 articles)
- …
- 11Serverless DeepDive #10:一時ファイルの置き場所を比較してみる This article
一時ファイルの保存先
Lambdaで処理の途中にファイルを作るなら、どこへ保存すればよいでしょうか。今回は、コードを配置する
/var/task、作業用の/tmp、Amazon S3を比べました。/var/taskにはファイルを書けませんでした。/tmpには書けましたが、関数の設定を更新した後は、そのファイルを読めませんでした。S3では、別の関数からも、設定更新後も、保存した内容を読めました。作業途中のファイルと、処理の結果を引き継ぐためのデータには、違う役割があります。今回の結果から、それぞれの保存先を考えます。
短いデータ変換の処理などは、Lambdaで必要なときに実行できます。プログラムを動かす環境の管理はAWSへ任せられます。ただし、処理が終わった後に残すデータと、その保存先は利用者が決めます。
検証構成
#06では実行環境の再利用を、#09では失敗後の状態を調べました。
今回は、正常な書き込みと読み直しに絞ります。
今回は、正常な書き込みと読み直しに絞ります。
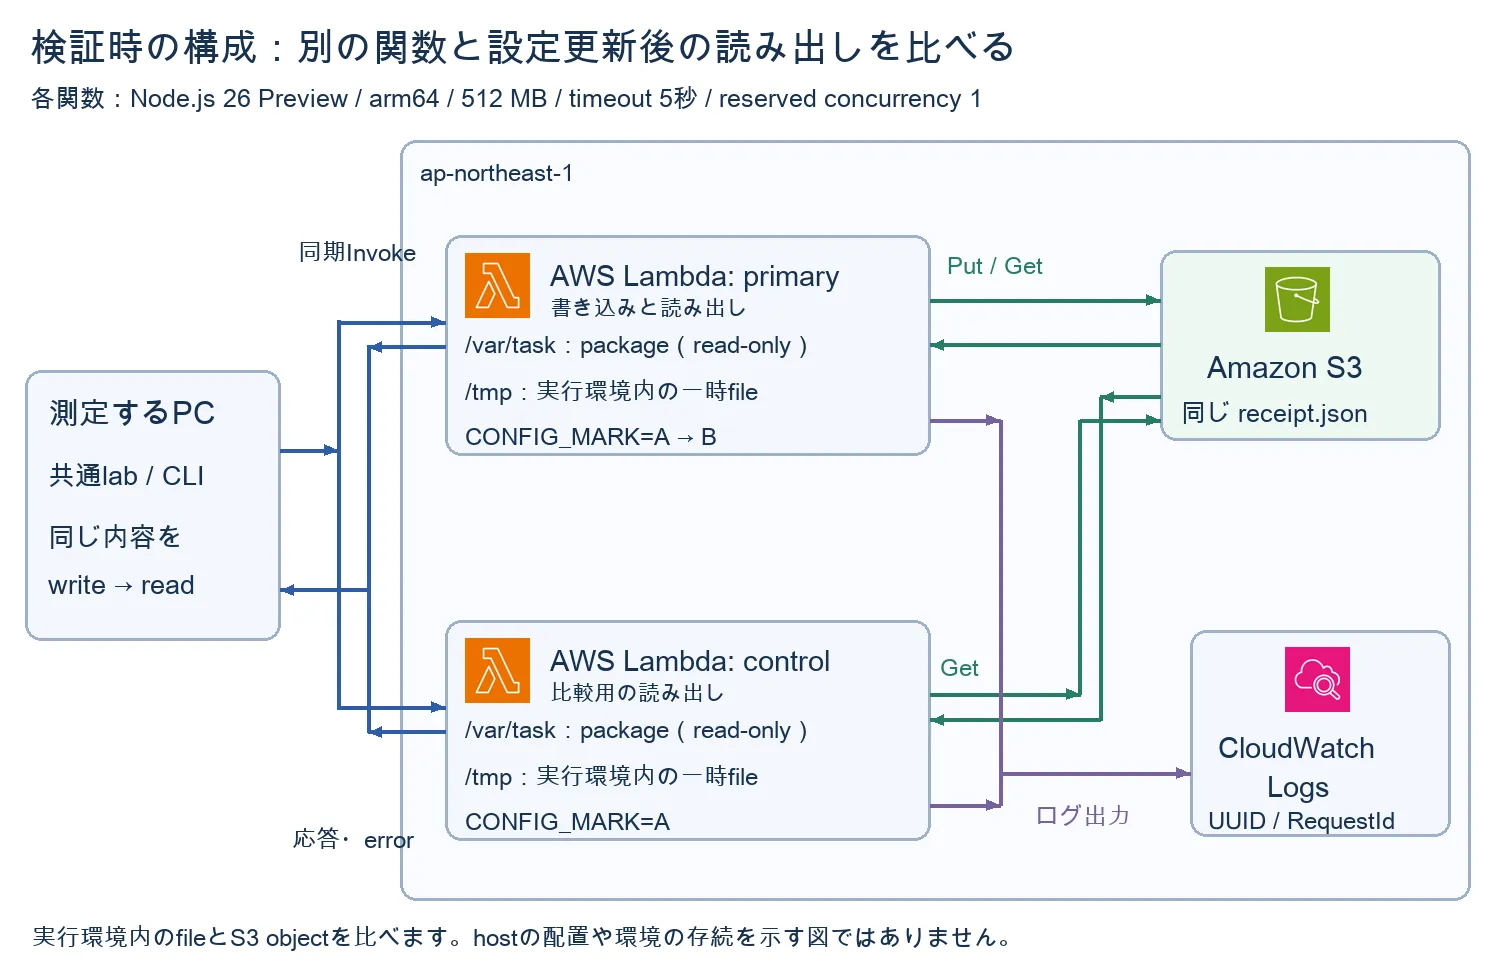
Lambda関数を2つ作り、primaryとcontrolと名付けました。
primaryで書き込みます。その内容をprimary自身とcontrolで読み直して比べます。
S3 keyは、保存するデータを指定する名前です。
両関数は、同じkeyから内容を読みます。
両関数には、同じコードを配置し、同じmemory容量を割り当てました。
S3の読み書きは
#08で扱った、応答を返した後の処理を、この比較に混ぜないためです。
primaryで書き込みます。その内容をprimary自身とcontrolで読み直して比べます。
S3 keyは、保存するデータを指定する名前です。
両関数は、同じkeyから内容を読みます。
両関数には、同じコードを配置し、同じmemory容量を割り当てました。
S3の読み書きは
awaitで完了を待ちました。#08で扱った、応答を返した後の処理を、この比較に混ぜないためです。
| 項目 | 今回の条件 |
|---|---|
| region | ap-northeast-1 |
| runtime(コードの実行基盤) | nodejs26.x、Node.js v26.8.2 |
| 提供状態 | Node.js 26 public preview |
| architecture・memory(割り当て容量) | arm64、512 MB |
| timeout・同時実行 | 5秒、reserved concurrency各1 |
| ephemeral storage(/tmpの保存容量) | 512 MB |
| 呼び出し | 同期Invoke 11回、handlerの記録11件で重複実行なし |
| S3 client | runtime同梱SDK 3.1105.0、maxAttempts 1 |
Invokeは、Lambda関数を呼び出すAPIです。
handlerは、その呼び出しを処理する関数です。
reserved concurrencyは、関数の同時実行数を予約し、上限も設ける設定です。
今回は各関数を1にして、同時に処理する呼び出しを1つまでに制限しました。
この設定は、同じ実行環境を使い続けることを保証しません。
handlerは、その呼び出しを処理する関数です。
reserved concurrencyは、関数の同時実行数を予約し、上限も設ける設定です。
今回は各関数を1にして、同時に処理する呼び出しを1つまでに制限しました。
この設定は、同じ実行環境を使い続けることを保証しません。
2026年10月11日時点で、Node.js 26はpublic preview(正式提供前の試験公開)でした。
今回は検証用に使いました。
この回の結果は、表のversionと条件で得たものです。
正式提供のruntimeで同じ結果になることまでは、確認していません。
保存先の仕様と、今回観測した結果を分けて説明します。
今回は検証用に使いました。
この回の結果は、表のversionと条件で得たものです。
正式提供のruntimeで同じ結果になることまでは、確認していません。
保存先の仕様と、今回観測した結果を分けて説明します。
ファイルを保存する
保存する内容は、
その文字列に、初期化時のUUIDとRequestIdを添えました。
UUIDは、コードの初期化を見分けるために、このプログラムが作る目印です。
RequestIdは、一回の呼び出しを見分ける識別子です。
ファイルを作成した呼び出しを、記録から確認するためです。
result-aのような短い文字列です。その文字列に、初期化時のUUIDとRequestIdを添えました。
UUIDは、コードの初期化を見分けるために、このプログラムが作る目印です。
RequestIdは、一回の呼び出しを見分ける識別子です。
ファイルを作成した呼び出しを、記録から確認するためです。
書き込み先は3つです。
| 保存先 | 今回のpath(保存場所) |
|---|---|
| packageの保存場所 | /var/task/lab-result.json |
| 実行環境の作業域 | /tmp/lab-result.json |
| S3 | 測定専用bucketのevidence/dd10-1011a/storage-10/receipt.json |
primaryでは、まず3つの保存先に値があるかを読み、次のInvokeで書き込みました。
同じ実行環境で読み直した後、controlから同じS3 keyを読みました。
primaryで
CONFIG_MARKは、設定更新を起こすために用意した環境変数です。
handlerは値をログへ残すだけで、処理には使いません。
設定更新後も読み出しを試しました。
その後、
同じ実行環境で読み直した後、controlから同じS3 keyを読みました。
primaryで
result-bへ上書きしてから、環境変数CONFIG_MARKだけをAからBへ変更しました。CONFIG_MARKは、設定更新を起こすために用意した環境変数です。
handlerは値をログへ残すだけで、処理には使いません。
設定更新後も読み出しを試しました。
その後、
result-cを書き込んで読み直しました。| 操作 | 関数・CONFIG_MARK | 初期化UUIDの先頭 | 初期化後の回数 | tmpの値(保存行は書き込み前) | S3の値(保存行は書き込み後) |
|---|---|---|---|---|---|
| 初回の読み出し | primary A | e1871bad | 1 | ファイルなし | objectなし(404) |
| result-a保存 | primary A | e1871bad | 2 | ファイルなし | result-a |
| 再読み出し | primary A | e1871bad | 3 | result-a | result-a |
| 別関数での読み出し | control A | 374f3cc8 | 1 | ファイルなし | result-a |
| 存在しないkey | control A | 374f3cc8 | 2 | ファイルなし | objectなし(404) |
| result-b保存 | primary A | e1871bad | 4 | result-a | result-b |
| 設定更新直前の読み出し | primary A | e1871bad | 5 | result-b | result-b |
| 設定更新直後の読み出し | primary B | f7ef8e7a | 1 | ファイルなし | result-b |
| controlの再読み出し | control A | 374f3cc8 | 3 | ファイルなし | result-b |
| result-c保存 | primary B | f7ef8e7a | 2 | ファイルなし | result-c |
| 再保存後の読み出し | primary B | f7ef8e7a | 3 | result-c | result-c |
UUIDは、コードを最初に読み込んだときに一度だけ作ります。
同じUUIDが続く間は、初期化後の呼び出し回数が増えました。
今回は、handler外の変数が次のInvokeへ引き継がれたことを確認する目印にしています。
物理hostやmicroVMの識別子ではありません。
11回の応答に含む記録は、CloudWatchの11件と全項目が一致しました。
同じUUIDが続く間は、初期化後の呼び出し回数が増えました。
今回は、handler外の変数が次のInvokeへ引き継がれたことを確認する目印にしています。
物理hostやmicroVMの識別子ではありません。
11回の応答に含む記録は、CloudWatchの11件と全項目が一致しました。
packageへ書く
packageは、Lambdaへ配布するコードや設定などをまとめたものです。その内容は、
/var/taskへ配置されます。3回の保存で、
error codeは
同じInvokeの
/var/task/lab-result.jsonへの書き込みはすべて失敗しました。error codeは
EROFSでした。読み取り専用の場所へ書き込もうとしたことを示します。同じInvokeの
/tmpとS3への書き込みは成功しました。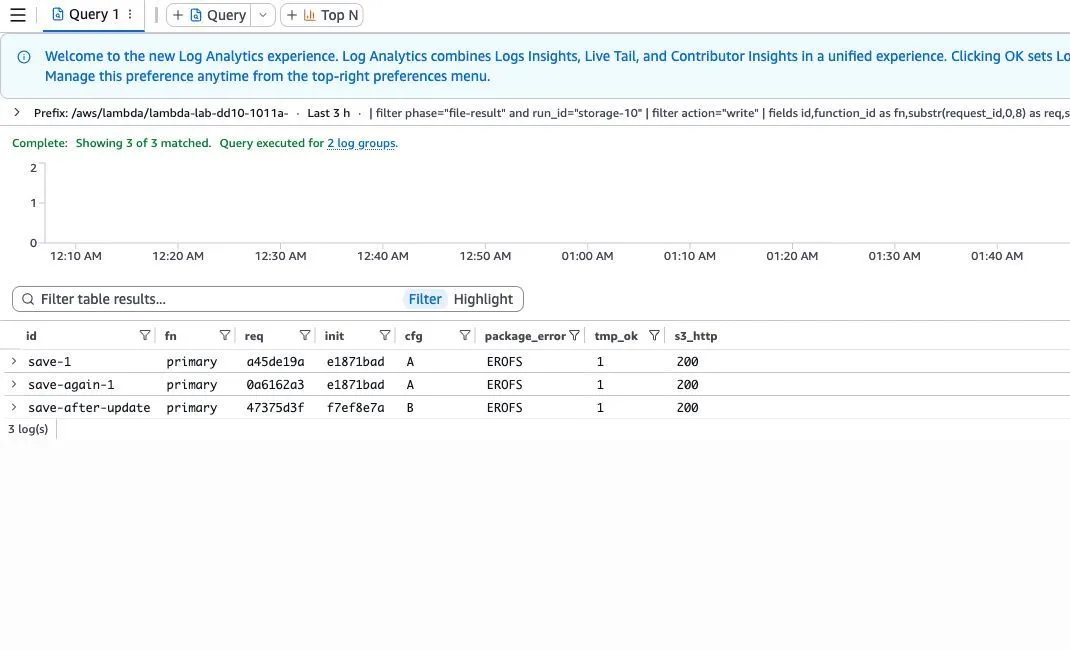
画面のidは入力名です。末尾の
reqとinitは、RequestIdと初期化UUIDの先頭8文字です。
fnは関数名です。
cfgは、CONFIG_MARKの値です。
package_errorは、packageの保存場所への書き込みで得たerror codeです。
tmp_okは、
s3_httpは、PutObjectのHTTP statusを示します。
-1は、測定CLIが1〜6回目の入力へ付けた印です。reqとinitは、RequestIdと初期化UUIDの先頭8文字です。
fnは関数名です。
cfgは、CONFIG_MARKの値です。
package_errorは、packageの保存場所への書き込みで得たerror codeです。
tmp_okは、
/tmpへの書き込みが成功すると1になります。s3_httpは、PutObjectのHTTP statusを示します。
packageの保存場所は、読み取り専用です。
コードに含めた設定や素材を読む用途と、その場で作るファイルを置く用途を分けます。
今回は存在しないファイルを作ろうとしました。
packageに含まれる既存のファイルを書き換えた実験ではありません。
コードに含めた設定や素材を読む用途と、その場で作るファイルを置く用途を分けます。
今回は存在しないファイルを作ろうとしました。
packageに含まれる既存のファイルを書き換えた実験ではありません。
処理の途中で作るCSVや展開したファイルを、packageの保存場所へ書く実装は避けます。
一時ファイルは書き込み可能な
一時ファイルは書き込み可能な
/tmpへ置きます。tmpから読む
primaryの初期化UUIDが
一方、controlの
今回の2関数では、同じ保存場所を指定しても、
e1871badのときは、保存した値を次のInvokeで読めました。一方、controlの
/tmpには、primaryが書いたファイルがありませんでした。今回の2関数では、同じ保存場所を指定しても、
/tmpのファイルを共有できませんでした。その後、primaryの環境変数CONFIG_MARKをAからBへ変更しました。
設定更新直後は、UUIDが
初期化後の呼び出し回数も1へ戻りました。
更新後に
設定更新直後は、UUIDが
f7ef8e7aへ変わりました。初期化後の呼び出し回数も1へ戻りました。
/tmpからも、更新前のresult-bは読めませんでした。更新後に
result-cを保存すると、同じUUIDの次のInvokeで読めました。
countは、初期化後にhandlerが処理した呼び出し回数です。
existsは/tmpのファイルがある場合に1、ない場合に0です。
tmpとs3は、それぞれから読んだ値です。
httpはS3 GetObjectのHTTP statusです。InvokeのStatusCodeとは別です。
existsは/tmpのファイルがある場合に1、ない場合に0です。
tmpとs3は、それぞれから読んだ値です。
httpはS3 GetObjectのHTTP statusです。InvokeのStatusCodeとは別です。
/tmpは実行環境ごとの一時領域です。同じ環境の再利用中に残っていても、次も使えるとは保証できません。
今回は、設定更新後に新しい実行環境が使われたと考えます。
初期化UUIDが変わり、更新前のファイルを読めなかったためです。
ただし、UUIDだけでは、同じ実行環境かどうかを確認できません。
#09では、失敗後の次の呼び出しでもファイルが残りました。
AWSが説明するresetは、同じ実行環境でNode.jsを終了し、次の呼び出しで起動し直す処理です。
resetでは、/tmpの内容を消しません。
#09の結果から、設定更新後にもファイルが残るとは言えません。
辞書などをcacheとして一時保存しているなら、ファイルがなくても取得し直せます。
完了した処理の結果を
完了した処理の結果を
/tmpにしか置かないと、別の実行環境では読み出せないおそれがあります。S3から読む
別の関数controlからも、S3に保存した
primaryを更新した直後も、
S3は実行環境の外にある保存先です。
今回、primaryの設定を更新した後も、更新前に保存した内容を読めました。
result-aを読めました。primaryを更新した直後も、
result-bが残っていました。S3は実行環境の外にある保存先です。
今回、primaryの設定を更新した後も、更新前に保存した内容を読めました。
保存の完了は、
S3では、成功したPUTの後に、そのobjectを読めます。
この動作は、S3の整合性モデル で定められています。
初回と存在しないkeyの試行では、
NoSuchKeyは、objectがないことを示すerrorです。
この動作は、一つのkeyについてのものです。
複数のkeyへ書く処理全体が完了したかを確かめる方法は、今回測っていません。
PutObjectの成功を待ち、同じkeyをGetObjectで読み直して確かめました。S3では、成功したPUTの後に、そのobjectを読めます。
この動作は、S3の整合性モデル で定められています。
初回と存在しないkeyの試行では、
NoSuchKey、HTTP 404を記録しました。NoSuchKeyは、objectがないことを示すerrorです。
この動作は、一つのkeyについてのものです。
複数のkeyへ書く処理全体が完了したかを確かめる方法は、今回測っていません。
今回は同じkeyへ3回書き込みました。2回目以降は上書きです。
最終的なS3 objectは
同時更新、削除、versioning、保存期限は検証していません。
複数の処理の結果を残すなら、処理のIDごとにkeyを分ける設計を考えます。
同じ入力を再送したときに、以前の結果を上書きするかどうかも決める必要があります。
今回の実測では、再送時の設計は検証していません。
最終的なS3 objectは
result-cです。同時更新、削除、versioning、保存期限は検証していません。
複数の処理の結果を残すなら、処理のIDごとにkeyを分ける設計を考えます。
同じ入力を再送したときに、以前の結果を上書きするかどうかも決める必要があります。
今回の実測では、再送時の設計は検証していません。
S3は、objectと呼ぶデータに名前を付けて保存するobject storageです。
今回の
POSIXのファイル操作や、複数の処理が使う共有file systemが必要な場合は、別の構成で確かめます。
今回の
PutObject/GetObject比較から、共有file systemの振る舞いは言えません。POSIXのファイル操作や、複数の処理が使う共有file systemが必要な場合は、別の構成で確かめます。
AWSで準備する
追試では、同じNode.js runtimeの関数を2つ作ります。
memory、timeout、ephemeral storageは検証構成の表へ合わせます。
両関数のpackageに、同じhandlerを
handler名は
次の環境変数を設定します。
memory、timeout、ephemeral storageは検証構成の表へ合わせます。
両関数のpackageに、同じhandlerを
index.jsとして配置します。handler名は
index.handlerです。次の環境変数を設定します。
| 環境変数 | primary | control |
|---|---|---|
| CONFIG_MARK | A | A |
| LAB_FUNCTION_ID | primary | control |
| LAB_EVIDENCE_BUCKET | 検証専用bucket名 | 同じbucket名 |
| LAB_EVIDENCE_PREFIX | evidence/new-storage-id/ | 同じprefix |
S3 bucketは、2つの関数と同じregionに新規作成します。
S3のpublic accessは無効にします。
実行roleには、CloudWatch Logsへの書き込み権限を付けます。
測定prefixへのGetObject/PutObjectの権限も付けます。
prefixは、測定用のS3 keyに付ける共通の先頭部分です。
同じprefixを条件にしたListBucketの権限も付けます。
存在しないkeyの404は、このListBucket権限がある条件で得た結果です。
GetObjectの権限条件 も確認できます。
S3のpublic accessは無効にします。
実行roleには、CloudWatch Logsへの書き込み権限を付けます。
測定prefixへのGetObject/PutObjectの権限も付けます。
prefixは、測定用のS3 keyに付ける共通の先頭部分です。
同じprefixを条件にしたListBucketの権限も付けます。
存在しないkeyの404は、このListBucket権限がある条件で得た結果です。
GetObjectの権限条件 も確認できます。
入力の例です。
同じrun_idを使い、key_idとvalueは後の表に合わせます。
run_idは前の測定と重ならない値にします。
同じrun_idを使い、key_idとvalueは後の表に合わせます。
run_idは前の測定と重ならない値にします。
1
{"id":"initial","action":"read","run_id":"new-storage-run","key_id":"receipt"}
1
{"id":"save","action":"write","run_id":"new-storage-run","key_id":"receipt","value":"result-a"}測定を試す
今回の測定には、検証コードと設定をまとめた共通labを使いました。
file-storage scenarioは、2関数の設定と1〜6回目の入力をまとめたものです。
7〜11回目は、同じ関数へAWS CLIで送りました。
追試では、上の設定で作った2関数へ次のhandlerを配置します。
runtime同梱SDKへの依存も、今回の測定条件に含めています。
file-storage scenarioは、2関数の設定と1〜6回目の入力をまとめたものです。
7〜11回目は、同じ関数へAWS CLIで送りました。
追試では、上の設定で作った2関数へ次のhandlerを配置します。
runtime同梱SDKへの依存も、今回の測定条件に含めています。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
const { randomUUID } = require("node:crypto");
const { readFileSync, writeFileSync } = require("node:fs");
const { S3Client, PutObjectCommand, GetObjectCommand } = require("@aws-sdk/client-s3");
const sdkVersion = require("@aws-sdk/client-s3/package.json").version;
const initId = randomUUID();
const s3 = new S3Client({ maxAttempts: 1 });
const packagePath = "/var/task/lab-result.json";
const tmpPath = "/tmp/lab-result.json";
let count = 0;
function read(path) {
  try {
    return { found: true, value: JSON.parse(readFileSync(path, "utf8")) };
  } catch (error) {
    if (error.code !== "ENOENT") throw error;
    return { found: false };
  }
}
exports.handler = async (event, context) => {
  if (!event || typeof event !== "object" || Array.isArray(event))
    throw new TypeError("event must be an object");
  const action = event.action ?? "read";
  if (!["read", "write"].includes(action)) throw new TypeError("unknown action");
  for (const field of ["run_id", "id", "key_id"]) {
    if (typeof event[field] !== "string" || !/^[a-z0-9-]{1,64}$/.test(event[field]))
      throw new TypeError(`${field} must match [a-z0-9-]{1,64}`);
  }
  if (action === "write" && (typeof event.value !== "string" || event.value.length > 128))
    throw new TypeError("value must be a string of at most 128 characters");
  const bucket = process.env.LAB_EVIDENCE_BUCKET;
  const prefix = process.env.LAB_EVIDENCE_PREFIX;
  if (!bucket || !prefix) throw new Error("storage is not configured");
  const key = `${prefix + event.run_id}/${event.key_id}.json`;
  const record = {
    phase: "file-result",
    id: event.id,
    run_id: event.run_id,
    action,
    request_id: context.awsRequestId,
    init_id: initId,
    count: ++count,
    function_id: process.env.LAB_FUNCTION_ID,
    config: process.env.CONFIG_MARK,
    node: process.version,
    sdk: sdkVersion,
    version: context.functionVersion,
    package_before: read(packagePath),
    tmp_before: read(tmpPath),
  };
  if (action === "write") {
    const value = { value: event.value, saved_by: initId, request_id: context.awsRequestId };
    try {
      writeFileSync(packagePath, JSON.stringify(value));
      record.package_write = { succeeded: true };
    } catch (error) {
      record.package_write = { succeeded: false, code: error.code };
    }
    writeFileSync(tmpPath, JSON.stringify(value));
    record.tmp_write = { succeeded: true };
    const saved = await s3.send(
      new PutObjectCommand({ Bucket: bucket, Key: key, Body: JSON.stringify(value) }),
    );
    record.s3_write = { succeeded: true, http_status: saved.$metadata.httpStatusCode };
  }
  record.package_after = read(packagePath);
  record.tmp_after = read(tmpPath);
  try {
    const loaded = await s3.send(new GetObjectCommand({ Bucket: bucket, Key: key }));
    record.s3_read = {
      found: true,
      value: JSON.parse(await loaded.Body.transformToString()),
      http_status: loaded.$metadata.httpStatusCode,
    };
  } catch (error) {
    if (error.name !== "NoSuchKey") throw error;
    record.s3_read = {
      found: false,
      code: error.name,
      http_status: error.$metadata?.httpStatusCode,
    };
  }
  console.log(JSON.stringify(record));
  return record;
};
入力をinput.jsonへ保存し、次の順に11回だけ送ります。
全入力で同じrun_idを使い、idは表の入力名にします。
valueはwriteでだけ指定します。
全入力で同じrun_idを使い、idは表の入力名にします。
valueはwriteでだけ指定します。
| 順 | 関数 | id | action | key_id | value |
|---|---|---|---|---|---|
| 1 | primary | initial | read | receipt | — |
| 2 | primary | save | write | receipt | result-a |
| 3 | primary | reread | read | receipt | — |
| 4 | control | other | read | receipt | — |
| 5 | control | missing | read | absent | — |
| 6 | primary | save-again | write | receipt | result-b |
| 7 | primary | before-update | read | receipt | — |
| 8 | primary | after-update | read | receipt | — |
| 9 | control | control-after-update | read | receipt | — |
| 10 | primary | save-after-update | write | receipt | result-c |
| 11 | primary | reread-after-save | read | receipt | — |
YOUR_PROFILEを、検証に使う自分のprofile名へ置き換えます。
YOUR_FUNCTION_NAMEは、表のprimaryまたはcontrolに対応する関数名へ置き換えます。
YOUR_PRIMARY_NAMEには、primaryの関数名を使います。
AWS_MAX_ATTEMPTS=1はCLIの自動retryを止める追試用の指定です。
response.jsonとInvoke応答のFunctionErrorを分けて確認します。
YOUR_FUNCTION_NAMEは、表のprimaryまたはcontrolに対応する関数名へ置き換えます。
YOUR_PRIMARY_NAMEには、primaryの関数名を使います。
AWS_MAX_ATTEMPTS=1はCLIの自動retryを止める追試用の指定です。
response.jsonとInvoke応答のFunctionErrorを分けて確認します。
1
2
3
4
5
AWS_PROFILE=YOUR_PROFILE AWS_MAX_ATTEMPTS=1 aws lambda invoke \
  --region ap-northeast-1 --function-name YOUR_FUNCTION_NAME \
  --invocation-type RequestResponse --log-type Tail \
  --cli-binary-format raw-in-base64-out \
  --payload file://input.json response.json
7回目の後に、primaryだけCONFIG_MARKをBへ更新します。
environment-b.jsonには、上の環境変数4件を省かず保存します。
YOUR_LATEST_REVISION_IDには、直前の取得結果を使います。
environment-b.jsonには、上の環境変数4件を省かず保存します。
YOUR_LATEST_REVISION_IDには、直前の取得結果を使います。
1
{"Variables":{"CONFIG_MARK":"B","LAB_FUNCTION_ID":"primary","LAB_EVIDENCE_BUCKET":"YOUR_BUCKET","LAB_EVIDENCE_PREFIX":"evidence/new-storage-id/"}}
1
2
3
4
5
6
7
8
9
10
11
AWS_PROFILE=YOUR_PROFILE aws lambda get-function-configuration \
--region ap-northeast-1 --function-name YOUR_PRIMARY_NAME \
--query '{RevisionId:RevisionId,Environment:Environment}'
AWS_PROFILE=YOUR_PROFILE AWS_MAX_ATTEMPTS=1 aws lambda update-function-configuration \
--region ap-northeast-1 --function-name YOUR_PRIMARY_NAME \
--revision-id YOUR_LATEST_REVISION_ID \
--environment file://environment-b.json
AWS_PROFILE=YOUR_PROFILE aws lambda wait function-updated-v2 \
--region ap-northeast-1 --function-name YOUR_PRIMARY_NAME更新完了後に8〜11回目を送ります。
同期Invokeは、表の順に合計11回です。
今回の全11件を、CloudWatch Logsにあるhandlerの記録と照合しました。
測定を終えたら、専用bucketを空にし、作成した検証用resourceを削除します。
Lambda、Logs、IAM role、bucketがなくなったことも確認します。
同期Invokeは、表の順に合計11回です。
今回の全11件を、CloudWatch Logsにあるhandlerの記録と照合しました。
測定を終えたら、専用bucketを空にし、作成した検証用resourceを削除します。
Lambda、Logs、IAM role、bucketがなくなったことも確認します。
まとめ
packageの保存場所は、配布したコードや素材を読むために使います。
S3は、実行環境をまたいで成果を読むための外部保存先です。
/tmpは、その実行環境で使う作業途中のファイルやcacheを置く場所です。S3は、実行環境をまたいで成果を読むための外部保存先です。
残らなくても作り直せるものは
失うと困る成果は、外部へ保存して完了を確認します。
この役割を先に分けると、実行環境の再利用に頼る範囲も決めやすくなります。
/tmpへ置けます。失うと困る成果は、外部へ保存して完了を確認します。
この役割を先に分けると、実行環境の再利用に頼る範囲も決めやすくなります。
参考資料
Series: Serverless DeepDive (13 articles)
- …
- 11Serverless DeepDive #10:一時ファイルの置き場所を比較してみる This article
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article