

Del RAG tradicional al RAG agentico en AWS: evolución, patrones y arquitectura de referencia
Descubre cómo superar las búsquedas estáticas con sistemas de IA capaces de razonar, coordinar herramientas y evaluar resultados dinámicamente. Explora patrones, frameworks y un caso práctico serverless paso a paso
La inteligencia artificial generativa está evolucionando desde aplicaciones que responden preguntas hacia sistemas capaces de coordinar acciones y utilizar herramientas para resolver tareas complejas. En este contexto, la Generación Aumentada por Recuperación (RAG) permite complementar los modelos de lenguaje de gran tamaño (LLMs) con información externa, propietaria o actualizada, sin necesidad de reentrenarlos cada vez que cambia la documentación.
Sin embargo, cuando una consulta requiere combinar distintas fuentes, reformular búsquedas o verificar información antes de responder, un flujo de recuperación predefinido puede resultar insuficiente.
Aquí aparece Agentic RAG, un enfoque que incorpora agentes capaces de seleccionar herramientas, evaluar los resultados y decidir si necesitan realizar nuevas operaciones antes de generar una respuesta. Esta evolución no significa que RAG tradicional haya quedado obsoleto, sino que existen problemas cuya complejidad justifica una orquestación más dinámica.
Este artículo explora sus principales conceptos, patrones y frameworks, y presenta una propuesta de arquitectura en AWS para analizar cómo estos elementos pueden aplicarse a un caso de uso empresarial.
¿Qué es Agentic RAG?
Agentic RAG combina la recuperación de información con un agente que puede decidir cómo resolver una consulta. En lugar de ejecutar únicamente una secuencia predefinida de búsqueda y generación, el sistema puede descomponer una pregunta, seleccionar herramientas, consultar distintas fuentes y evaluar si dispone de evidencia suficiente.
Por ejemplo, ante la pregunta «¿Qué broca necesita el taladro modelo X para perforar concreto y la garantía cubre ese uso?», el agente puede recuperar las especificaciones del manual técnico y consultar, mediante otra herramienta, la política formal de garantía. Finalmente, integra los resultados en una respuesta fundamentada.
La diferencia no radica simplemente en utilizar un LLM más potente, sino en permitir que el sistema coordine acciones según los resultados obtenidos. Si la información no es suficiente, debe reconocer esa limitación en lugar de inventar una respuesta.
Amazon Bedrock ofrece capacidades de recuperación agéntica para descomponer consultas complejas, recuperar información de forma iterativa y evaluar los resultados obtenidos.
RAG tradicional frente a Agentic RAG
| Dimensión | RAG tradicional | Agentic RAG |
|---|---|---|
| Flujo | Recuperación y generación predefinidas. | Ejecución adaptable según los resultados. |
| Recuperación | Aplica las búsquedas configuradas. | Puede reformular consultas o realizar recuperaciones adicionales. |
| Decisiones | Predominan las reglas definidas previamente. | El agente puede seleccionar herramientas y decidir cómo continuar. |
| Costos y latencia | Generalmente más predecibles. | Pueden aumentar por las iteraciones adicionales. |
| Uso recomendado | Consultas documentales y preguntas frecuentes. | Tareas que requieren combinar fuentes o coordinar varias operaciones. |
Esta comparación no implica que RAG tradicional siempre realice una única búsqueda ni que Agentic RAG sea superior en todos los escenarios. Un sistema convencional también puede incorporar búsqueda híbrida, filtros y reranking.
La decisión depende de la complejidad del problema: cuando un flujo sencillo satisface los requisitos, introducir un agente puede añadir costos y complejidad innecesarios.

Patrones de arquitectura de agentes: ReAct vs. ReWOO
El diseño de un agente no depende únicamente del modelo de lenguaje utilizado, sino también de cómo organiza sus decisiones y ejecuta las herramientas disponibles. Dos estrategias relevantes son ReAct y ReWOO, que abordan de manera diferente la relación entre razonamiento, planificación y ejecución.
ReAct: razonamiento y acción
ReAct (Reasoning and Acting) propone intercalar la evaluación del problema con la ejecución de acciones y el análisis de sus resultados. El agente puede solicitar una herramienta, recibir la observación correspondiente y utilizar esa información para decidir el siguiente paso.
El flujo conceptual es:
Evaluar → Actuar → Observar → Evaluar nuevamente.
Por ejemplo, el agente puede consultar primero un manual técnico y, después de recibir el resultado, determinar que necesita consultar la política de garantía antes de responder.
Su principal ventaja es la capacidad de adaptar el proceso a la información obtenida durante la ejecución. La contrapartida es que las iteraciones adicionales pueden aumentar las llamadas al modelo, la latencia y el consumo de tokens.
ReAct se presentó en la investigación ReAct: Synergizing Reasoning and Acting in Language Models .
ReWOO: planificación antes de la observación
ReWOO (Reasoning Without Observation) plantea una separación entre la planificación y la ejecución de las herramientas. En lugar de intercalar necesariamente una nueva llamada al modelo después de cada observación, el sistema genera un plan anticipado y posteriormente ejecuta los pasos previstos, aprovechando las dependencias que permitan resolver operaciones en secuencia o paralelo.
Su principal ventaja potencial es reducir llamadas redundantes al modelo y mejorar la eficiencia en tareas cuyo plan puede definirse con suficiente anticipación.
La limitación aparece cuando una acción produce un resultado inesperado que modifica los pasos posteriores. En esos casos, puede ser necesario volver a planificar o activar una estrategia de recuperación ante errores. Por tanto, ReWOO no garantiza menor latencia en todos los escenarios: el resultado depende del modelo, las herramientas, las dependencias y la complejidad del plan.
La propuesta original se describe en ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models .
ReAct frente a ReWOO
| Criterio | ReAct | ReWOO |
|---|---|---|
| Estrategia | Alterna decisiones y observaciones. | Separa la planificación de la ejecución. |
| Planificación | Se adapta durante el proceso. | Define anticipadamente los pasos previstos. |
| Uso del resultado de una herramienta | Puede determinar la siguiente acción. | Se utiliza para completar el plan y sintetizar la respuesta. |
| Ventaja principal | Flexibilidad ante resultados inesperados. | Posible reducción de llamadas al modelo. |
| Consideración principal | Las iteraciones pueden aumentar la latencia y el costo. | Un plan anticipado puede necesitar replanificación. |
| Escenario apropiado | Tareas en las que la siguiente acción depende de lo observado. | Tareas con pasos identificables antes de ejecutar las herramientas. |
No existe un enfoque universalmente superior. La elección depende de cuánto necesite el agente adaptar sus decisiones durante la ejecución. Además, ambos enfoques pueden incorporar límites de iteración, validación de herramientas y mecanismos de recuperación.

Routing: selección de la fuente o herramienta
Routing, o enrutamiento, es un patrón que permite seleccionar el flujo, la fuente de datos o la herramienta más adecuada para una consulta. La decisión puede basarse en reglas deterministas, un clasificador o un LLM.
En el caso de una aplicación comercial, una consulta sobre especificaciones técnicas puede dirigirse al índice vectorial de manuales, mientras que una pregunta sobre condiciones de garantía puede activar una consulta estructurada al repositorio de políticas.
El enrutamiento ayuda a evitar consultas innecesarias a fuentes que no pueden resolver el problema. No requiere obligatoriamente un agente autónomo: también puede implementarse dentro de un flujo tradicional cuando las condiciones de selección están definidas previamente.
Reflection: evaluación y revisión de resultados
Reflection, o reflexión, es un patrón que incorpora una evaluación de los resultados antes de finalizar la tarea. El sistema puede revisar si la respuesta responde a la pregunta, si existe evidencia suficiente o si es necesario corregir una recuperación.
En una implementación de RAG, esta evaluación puede activar una nueva búsqueda cuando faltan datos, solicitar una reformulación de la respuesta o indicar que no existe evidencia suficiente.
Sin embargo, la autoevaluación del modelo no constituye una garantía de veracidad. Para que sea útil, deben definirse criterios verificables, límites de iteración y condiciones de finalización. Siempre que sea posible, conviene contrastar las afirmaciones con los fragmentos recuperados y las reglas de negocio correspondientes.
Tool Calling: invocación de herramientas
Tool Calling es el mecanismo mediante el cual un modelo solicita ejecutar una función o herramienta utilizando argumentos estructurados. Por ejemplo, el agente puede solicitar la ejecución de una herramienta denominada
consultar_politicas_garantia con el identificador de un producto.La aplicación recibe esa solicitud, valida los argumentos y ejecuta la función si está autorizada. Después, devuelve el resultado al agente para que pueda continuar el proceso o generar la respuesta final.
Este mecanismo no implica que el modelo ejecute directamente cualquier operación ni que sus argumentos sean automáticamente seguros. La aplicación debe validar los esquemas de entrada, los permisos, los límites operativos y las acciones permitidas.
¿Cómo se combinan estos conceptos?
ReAct y ReWOO definen estrategias diferentes para organizar el razonamiento y la ejecución. Routing permite dirigir las consultas, Reflection ayuda a evaluar los resultados y Tool Calling habilita la interacción con las herramientas.
En una misma solución pueden combinarse varios de estos elementos. La clave es seleccionar los necesarios según las dependencias de la tarea, la incertidumbre de los resultados y los requisitos de latencia y costo.
Frameworks para implementar Agentic RAG
Los frameworks ayudan a construir la lógica de recuperación y orquestación sin tener que implementar cada mecanismo desde cero. La elección depende del nivel de control requerido, la complejidad del flujo, las capacidades de gestión de datos y las necesidades operativas.
| Framework | Enfoque principal | Cuándo evaluarlo |
|---|---|---|
| LangChain / LangGraph | Componentes para aplicaciones con LLMs y orquestación mediante grafos con estado. | Flujos con ciclos, ramificaciones, persistencia de estado y control explícito de la ejecución. |
| LlamaIndex | Herramientas para ingesta, indexación y recuperación sobre datos. | Aplicaciones centradas en consultas documentales, estructuras de datos y recuperación avanzada. |
| Strands Agents | SDK para construir agentes con modelos, herramientas y un bucle de ejecución. | Aplicaciones que necesitan definir agentes de forma modular y ejecutarlos en distintos entornos. |
LangChain y LangGraph
LangChain proporciona componentes para construir aplicaciones basadas en modelos de lenguaje, integrar herramientas y conectar fuentes de datos. LangGraph permite modelar flujos más explícitos mediante grafos, incorporando estado, ciclos y ramificaciones.
Esta separación resulta útil cuando las decisiones de orquestación deben controlarse de forma detallada. La flexibilidad adicional implica diseñar y probar con cuidado el estado, los límites de ejecución y la recuperación ante errores.
Documentación: LangChain y LangGraph .
LlamaIndex
LlamaIndex se centra en conectar aplicaciones de IA con datos. Proporciona componentes para procesar e indexar documentos, recuperar información y construir motores de consulta que pueden coordinar distintas fuentes.
Es una opción pertinente cuando la mayor parte del desafío está en la preparación de los datos y en la calidad de la recuperación. También permite implementar flujos más complejos, por lo que no debe entenderse exclusivamente como una herramienta de ingesta.
Documentación: LlamaIndex .
Strands Agents
Strands Agents ofrece un SDK para construir agentes que combinan un modelo con instrucciones, estado y herramientas. Permite definir funciones propias, conectar herramientas externas y configurar el comportamiento del agente mediante componentes modulares.
Strands se ejecuta dentro del proceso de la aplicación y no exige desplegar una plataforma independiente de orquestación. Puede utilizarse con distintos proveedores de modelos compatibles y desplegarse en entornos adecuados a las necesidades de la solución.
La biblioteca no elimina la necesidad de diseñar controles de seguridad, observabilidad, persistencia o gestión de errores. Estos elementos deben resolverse como parte de la arquitectura que ejecuta el agente.
Documentación: Strands Agents .
Criterios de selección
No existe un framework ganador para todos los proyectos. Para elegir, conviene evaluar la complejidad del flujo, las necesidades de recuperación, la gestión del estado conversacional, la integración con servicios de AWS, las capacidades de evaluación y el esfuerzo operativo.
Una implementación mínima de prueba permite comparar estas alternativas con métricas concretas: calidad de recuperación, precisión de las respuestas, latencia, costo por consulta y comportamiento ante errores. El objetivo es seleccionar la opción que resuelva los requisitos con el nivel de complejidad necesario.
Arquitectura de referencia en AWS
Una solución de Agentic RAG puede combinar servicios administrados para la autenticación, el procesamiento, la recuperación documental, la ejecución de herramientas y la observabilidad.
Entre las opciones disponibles se encuentran Amazon Bedrock para utilizar modelos fundacionales, AWS Lambda para la orquestación, Amazon S3 para almacenar documentos y Amazon Aurora PostgreSQL con
pgvector para realizar búsquedas semánticas. DynamoDB puede utilizarse para mantener información estructurada, como políticas de negocio, e historial conversacional.La combinación definitiva depende del caso de uso, los requisitos de rendimiento y las restricciones de costos. En particular, Aurora Serverless v2 puede pausar su capacidad de cómputo bajo determinadas condiciones, pero mantener RDS Proxy asociado impide esa pausa automática debido a las conexiones que conserva abiertas. Por ello, una arquitectura que priorice el auto-pause debe evaluar una alternativa de acceso a la base de datos compatible con ese requisito.
La referencia general para evaluar las decisiones de diseño es el AWS Well-Architected Framework .
Caso de estudio: propuesta de arquitectura para un asistente de ventas
Como aplicación práctica de los conceptos anteriores, se presenta una propuesta de estudio para una ferretería ficticia X que necesita ayudar a sus asesores comerciales a resolver consultas técnicas de sus clientes.
Problema y objetivo
Los asesores reciben preguntas que pueden requerir la consulta de diferentes fuentes. Por ejemplo:
«¿Qué broca necesita el taladro modelo X para perforar concreto y la garantía cubre ese uso?»
La solución debe recuperar las especificaciones del manual correspondiente, consultar las políticas formales de garantía y proporcionar una respuesta fundamentada. Además, se plantea una arquitectura serverless que se adapte a una demanda variable y reduzca los costos durante los periodos de inactividad.
Diagrama de arquitectura propuesto
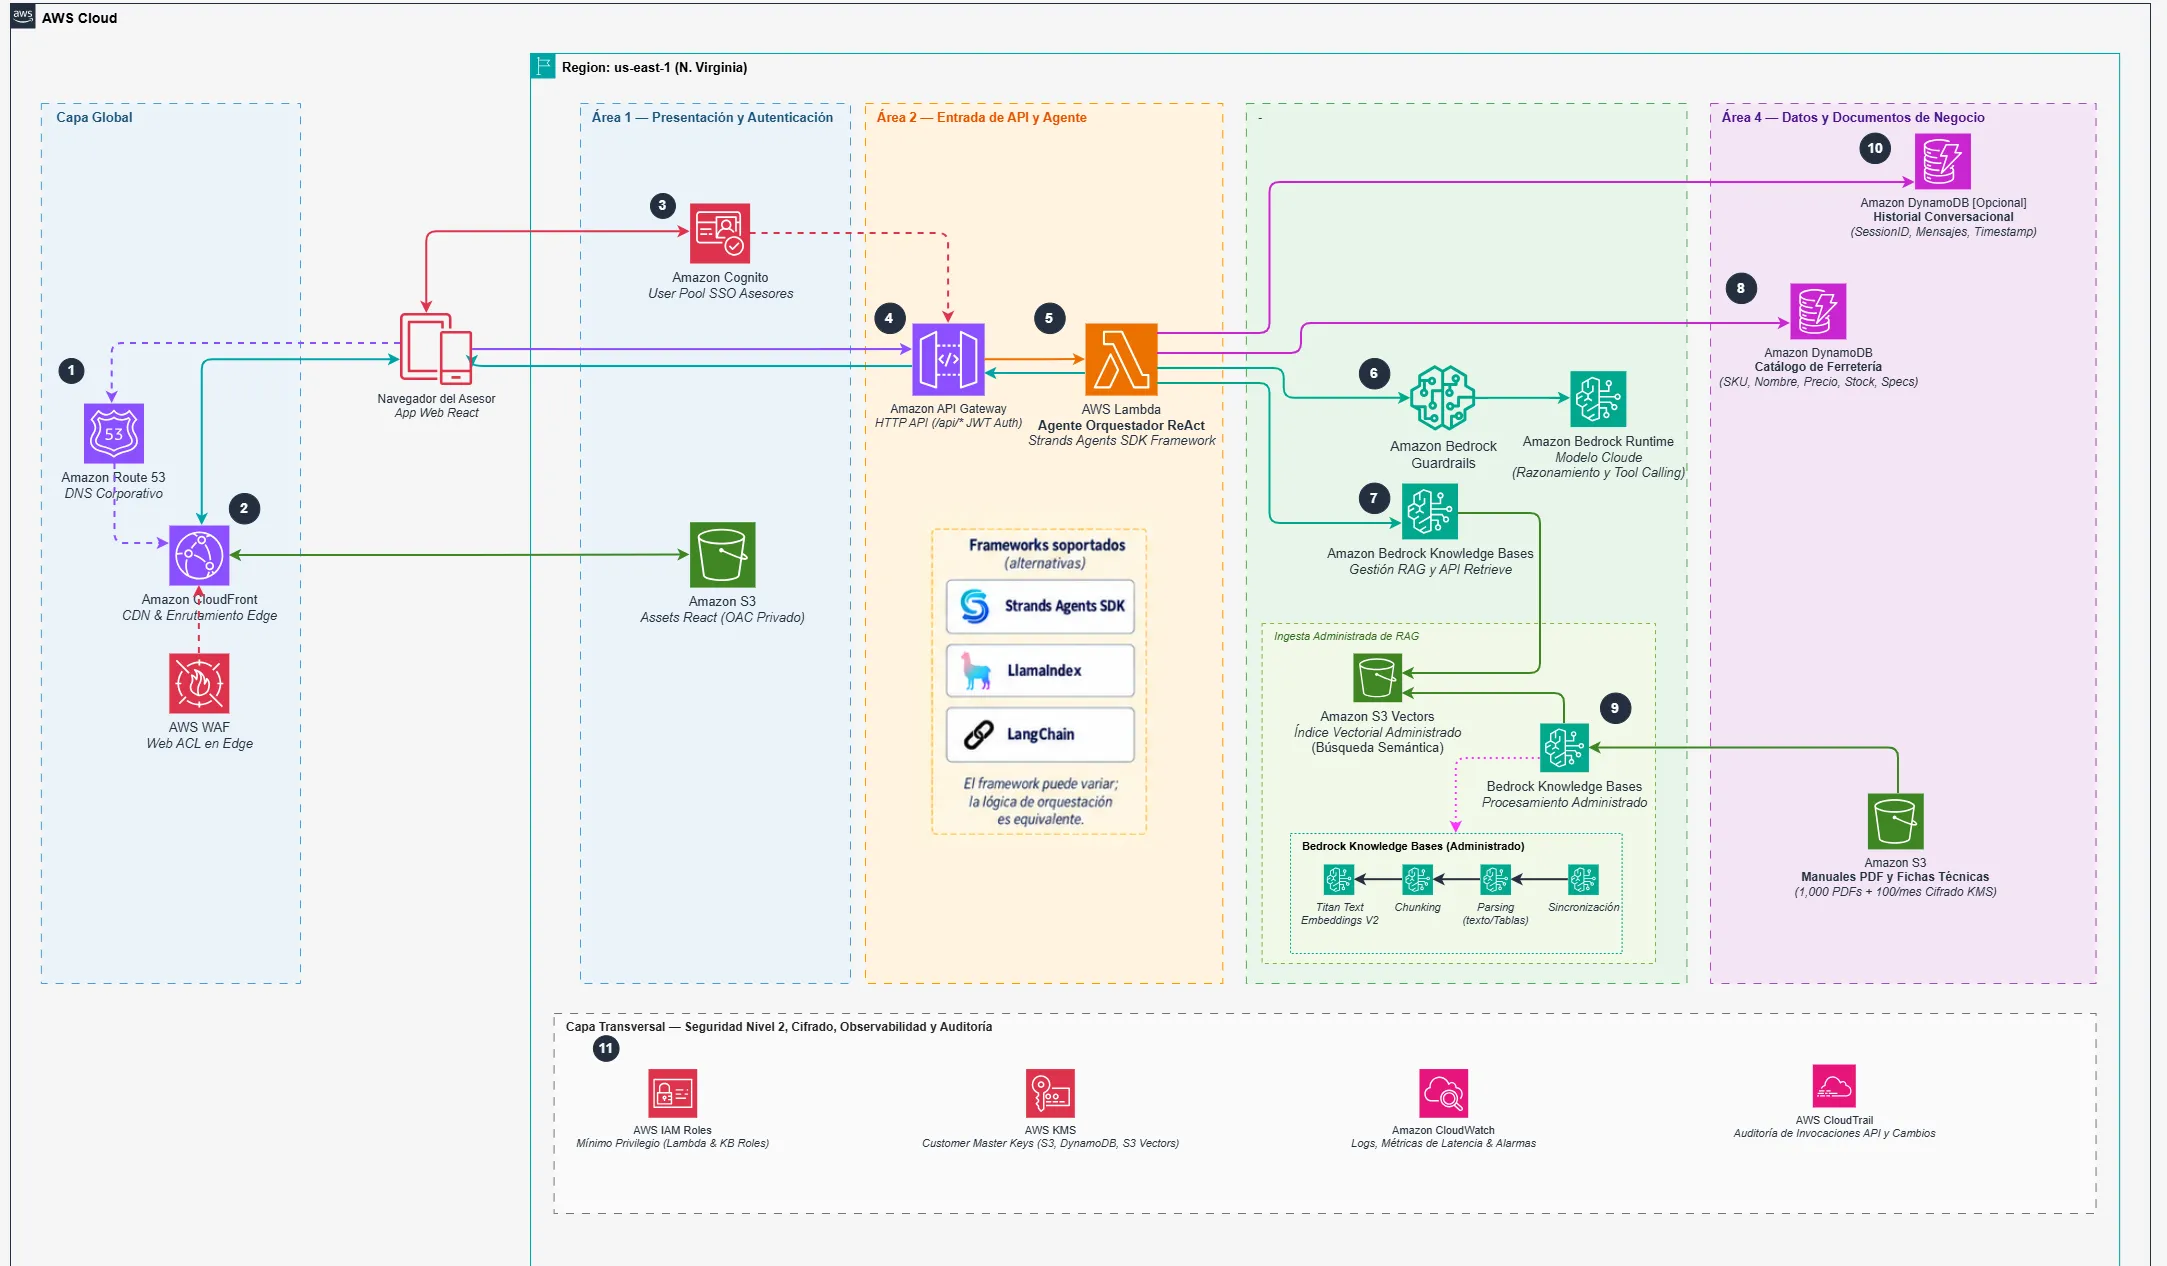
Explicación del diagrama:
- El asesor comercial accede a la plataforma desde su navegador web. Amazon Route 53 resuelve el dominio corporativo y canaliza el tráfico hacia Amazon CloudFront. En el borde (Edge), AWS WAF inspecciona y filtra el tráfico entrante bloqueando amenazas del OWASP Top 10, bots y peticiones maliciosas antes de llegar a la infraestructura.
- CloudFront distribuye la aplicación de página única (Single Page Application - SPA en React) alojada en un bucket privado de Amazon S3. La conexión S3-CloudFront está estrictamente protegida mediante Origin Access Control (OAC), impidiendo accesos públicos directos al bucket.
- El asesor autentica su identidad en Amazon Cognito User Pool mediante OAuth 2.0 / OIDC con soporte para Single Sign-On (SSO). Una vez validado, Cognito emite tokens de acceso y firma JWT (JSON Web Tokens) que el cliente adjunta en cada solicitud a la API.
- La SPA en React envía las peticiones conversacionales (
POST /api/chat) a Amazon API Gateway (HTTP API). API Gateway valida automáticamente la firma y vigencia del JWT contra Amazon Cognito antes de permitir el paso a la capa lógica. - API Gateway invoca de manera síncrona una función AWS Lambda que ejecuta el marco de orquestación agéntica (Strands Agents SDK / LangChain / LlamaIndex). Lambda inicializa el ciclo de razonamiento ReAct (Reason + Act), cargando las definiciones de las herramientas (tools) disponibles.
- Antes de evaluar la solicitud, Amazon Bedrock Guardrails evalúa la entrada para prevenir prompt injections, filtrar contenido inapropiado y proteger datos PII. Una vez validada, la consulta se envía a Amazon Bedrock Runtime (Anthropic Claude), el cual razona y decide de forma autónoma si debe invocar una herramienta (Tool Calling) o construir la respuesta final.
- Cuando el agente necesita responder sobre fichas técnicas, manuales o políticas de productos, Lambda llama a la API
Retrievede Amazon Bedrock Knowledge Bases. Este servicio ejecuta una búsqueda vectorial sobre el índice en Amazon S3 Vectors para recuperar los fragmentos (chunks) más relevantes. - Para consultas de datos estructurados e inventarios en tiempo real (precios, stock, SKU, especificaciones), la función Lambda consulta directamente la tabla Amazon DynamoDB (Catálogo de Ferretería), garantizando respuestas exactas y sin alucinaciones.
- Pipeline asíncrono en segundo plano: Los manuales y PDFs subidos al bucket de Amazon S3 son procesados por Bedrock Knowledge Bases. El sistema realiza la extracción de texto y tablas (parsing), segmentación (chunking) y vectorización mediante Amazon Titan Text Embeddings V2, guardando los vectores en Amazon S3 Vectors.
- La función Lambda lee y guarda el contexto de la conversación (preguntas del usuario, decisiones del agente y respuestas) en la tabla Amazon DynamoDB (Historial Conversacional), organizada por
SessionIDyTimestamppara mantener el contexto hilo a hilo. - Gobernanza Transversal, Cifrado y Observabilidad (Capa Transversal):
AWS IAM Roles: Control de acceso basado en el principio de mínimo privilegio para Lambda y Bedrock KB.
AWS KMS: Cifrado de datos en reposo y tránsito para buckets S3, tablas DynamoDB y vectores.
Amazon CloudWatch: Monitoreo centralizado de métricas de latencia, invocaciones de Lambda y logs de auditoría.
AWS CloudTrail: Registro continuo de eventos de API y cambios de configuración para auditoría y cumplimiento normativo.
Análisis de la propuesta
La principal decisión arquitectónica consiste en desacoplar la orquestación agéntica de los mecanismos de recuperación de información, mediante una arquitectura serverless en AWS. El agente, implementado con Strands Agents SDK sobre AWS Lambda, utiliza un enfoque iterativo compatible con ReAct para interpretar consultas, interactuar con modelos Claude mediante Amazon Bedrock y seleccionar dinámicamente herramientas (Tool Calling). Esto permite combinar la recuperación semántica de documentos mediante Bedrock Knowledge Bases y Amazon S3 Vectors, con consultas estructuradas a Amazon DynamoDB para obtener información de productos, precios y stock, además de gestionar el historial conversacional.
La ingesta documental se apoya en un proceso administrado de Amazon Bedrock Knowledge Bases, que permite procesar manuales PDF y fichas técnicas almacenados en Amazon S3 mediante parsing, chunking y generación de embeddings con Amazon Titan Text Embeddings V2, utilizando Amazon S3 Vectors como índice vectorial. Este enfoque reduce la necesidad de desarrollar infraestructura propia de indexación y recuperación. La arquitectura incorpora además Amazon Cognito, API Gateway, Bedrock Guardrails, IAM, KMS, CloudWatch y CloudTrail, proporcionando componentes para autenticación, protección de contenido, control de acceso, cifrado, observabilidad y auditoría, sujetos a su configuración.
Conclusiones
Agentic RAG amplía las capacidades del RAG tradicional al incorporar decisiones dinámicas y coordinación entre herramientas y fuentes de información. La propuesta demuestra, a nivel de diseño, cómo integrar recuperación semántica, datos estructurados y contexto conversacional mediante servicios administrados de AWS. Sin embargo, adoptar un enfoque agéntico no garantiza automáticamente mayor precisión, menor latencia o reducción de costos; estos beneficios requieren validación. El verdadero valor arquitectónico reside en seleccionar el patrón adecuado, desacoplar responsabilidades y equilibrar flexibilidad, seguridad, rendimiento y eficiencia operativa según las necesidades del negocio.
Referencias adicionales
- AWS Architecture Center:https://aws.amazon.com/architecture/
- AWS Prescriptive Guidance:https://docs.aws.amazon.com/prescriptive-guidance/
- AWS Machine Learning Blog:https://aws.amazon.com/blogs/machine-learning/
- Amazon Bedrock User Guide:https://docs.aws.amazon.com/bedrock/
- AWS Well-Architected Framework:https://aws.amazon.com/architecture/well-architected/
- Strands Agents Documentation:https://strandsagents.com/
- LangChain Documentation:https://docs.langchain.com/
- LlamaIndex Documentation:https://docs.llamaindex.ai/
- Amazon Titan Text Embeddings V2
- Pausa automática de Aurora Serverless v2
- AWS Well-Architected Framework
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article