
Never Down: failover multicloud AWS→GCP decidido por un agente de IA
Café Quetzal es una verdadera aplicación de pedido de café que se ejecuta en AWS, con GCP como un cálido standby. Cuando AWS falla, un agente de inteligencia artificial en Amazon Bedrock con Nova Lite recomienda una conmutación por error, pero el código decide. Este artículo cubre la arquitectura, los resultados reales de las pruebas y los costos de mantenerse siempre encendido.
Resumen ejecutivo
Construí Never Down alrededor de una aplicación real: Café Quetzal (Café Quetzal), un sistema de pedidos de cafeterías en línea. AWS normalmente sirve a la tienda y a la API; GCP se mantiene en espera, listo para seguir vendiendo si el principal deja de responder. DynamoDB replica los cambios en Firestore y un monitor consulta a Amazon Bedrock con Amazon Nova Lite para interpretar las señales de salud. La IA no tiene libertad sin restricciones: el código requiere dos ciclos poco saludables, una puntuación de confianza mínima, un GCP saludable y estados permitidos antes de que cambie la Ruta 53.
En la prueba del 5 al 6 de octubre de 2026, el agente decidió y ejecutó el cambio de DNS unos 61 segundos después de que desencadené la interrupción. La primera disponibilidad pública confirmada en Cloud Run apareció aproximadamente 97,5 segundos después del inicio. Esta diferencia importa: el tiempo de decisión no es el mismo que un RTO confirmado por el cliente. El experimento también me enseñó que mover el tráfico es solo una parte del trabajo; datos, observabilidad DNS y un retorno deliberado con límites explícitos completan la recuperación.
1
Actualización posterior al evento: Entregué esta charla en vivo en el Día de la Comunidad de AWS Guatemala 2026, incluida la verdadera demostración de conmutación por error frente a la audiencia. La carrera en vivo se comportó consistentemente con el ensayo documentado en este artículo.
El problema: una cafetería no puede dejar de vender
Me imaginé el incidente a partir de la orden, no del diagrama. Una persona toma un café, confirma la compra y espera una respuesta. Si el tiempo de ejecución principal falla en ese momento exacto, la empresa debe seguir aceptando operaciones con una experiencia reconocible. Un procedimiento puramente manual puede ser válido para muchos sistemas, pero para este ensayo quería detectar la degradación sostenida, validar un destino alternativo y cambiar el tráfico de forma automática y auditable.
Elegí un cálido standby porque equilibra la continuidad y el costo. GCP mantiene la aplicación desplegada, TLS lista, una IP global y datos replicados; tampoco recibe tráfico normal, pero tampoco comienza desde cero durante el incidente. Una configuración activa-activa habría agregado resolución de conflictos, observabilidad y costos que no necesitaba demostrar. Un modo de espera frío habría reducido el gasto fijo, a costa de la construcción o el arranque de componentes durante la emergencia y el aumento del tiempo de recuperación.
1
Decisión de diseño: El standby está preparado y direccionable antes de que ocurra la interrupción. No intento improvisar infraestructura mientras el servicio ya está degradado.
Café Quetzal como escenario observable
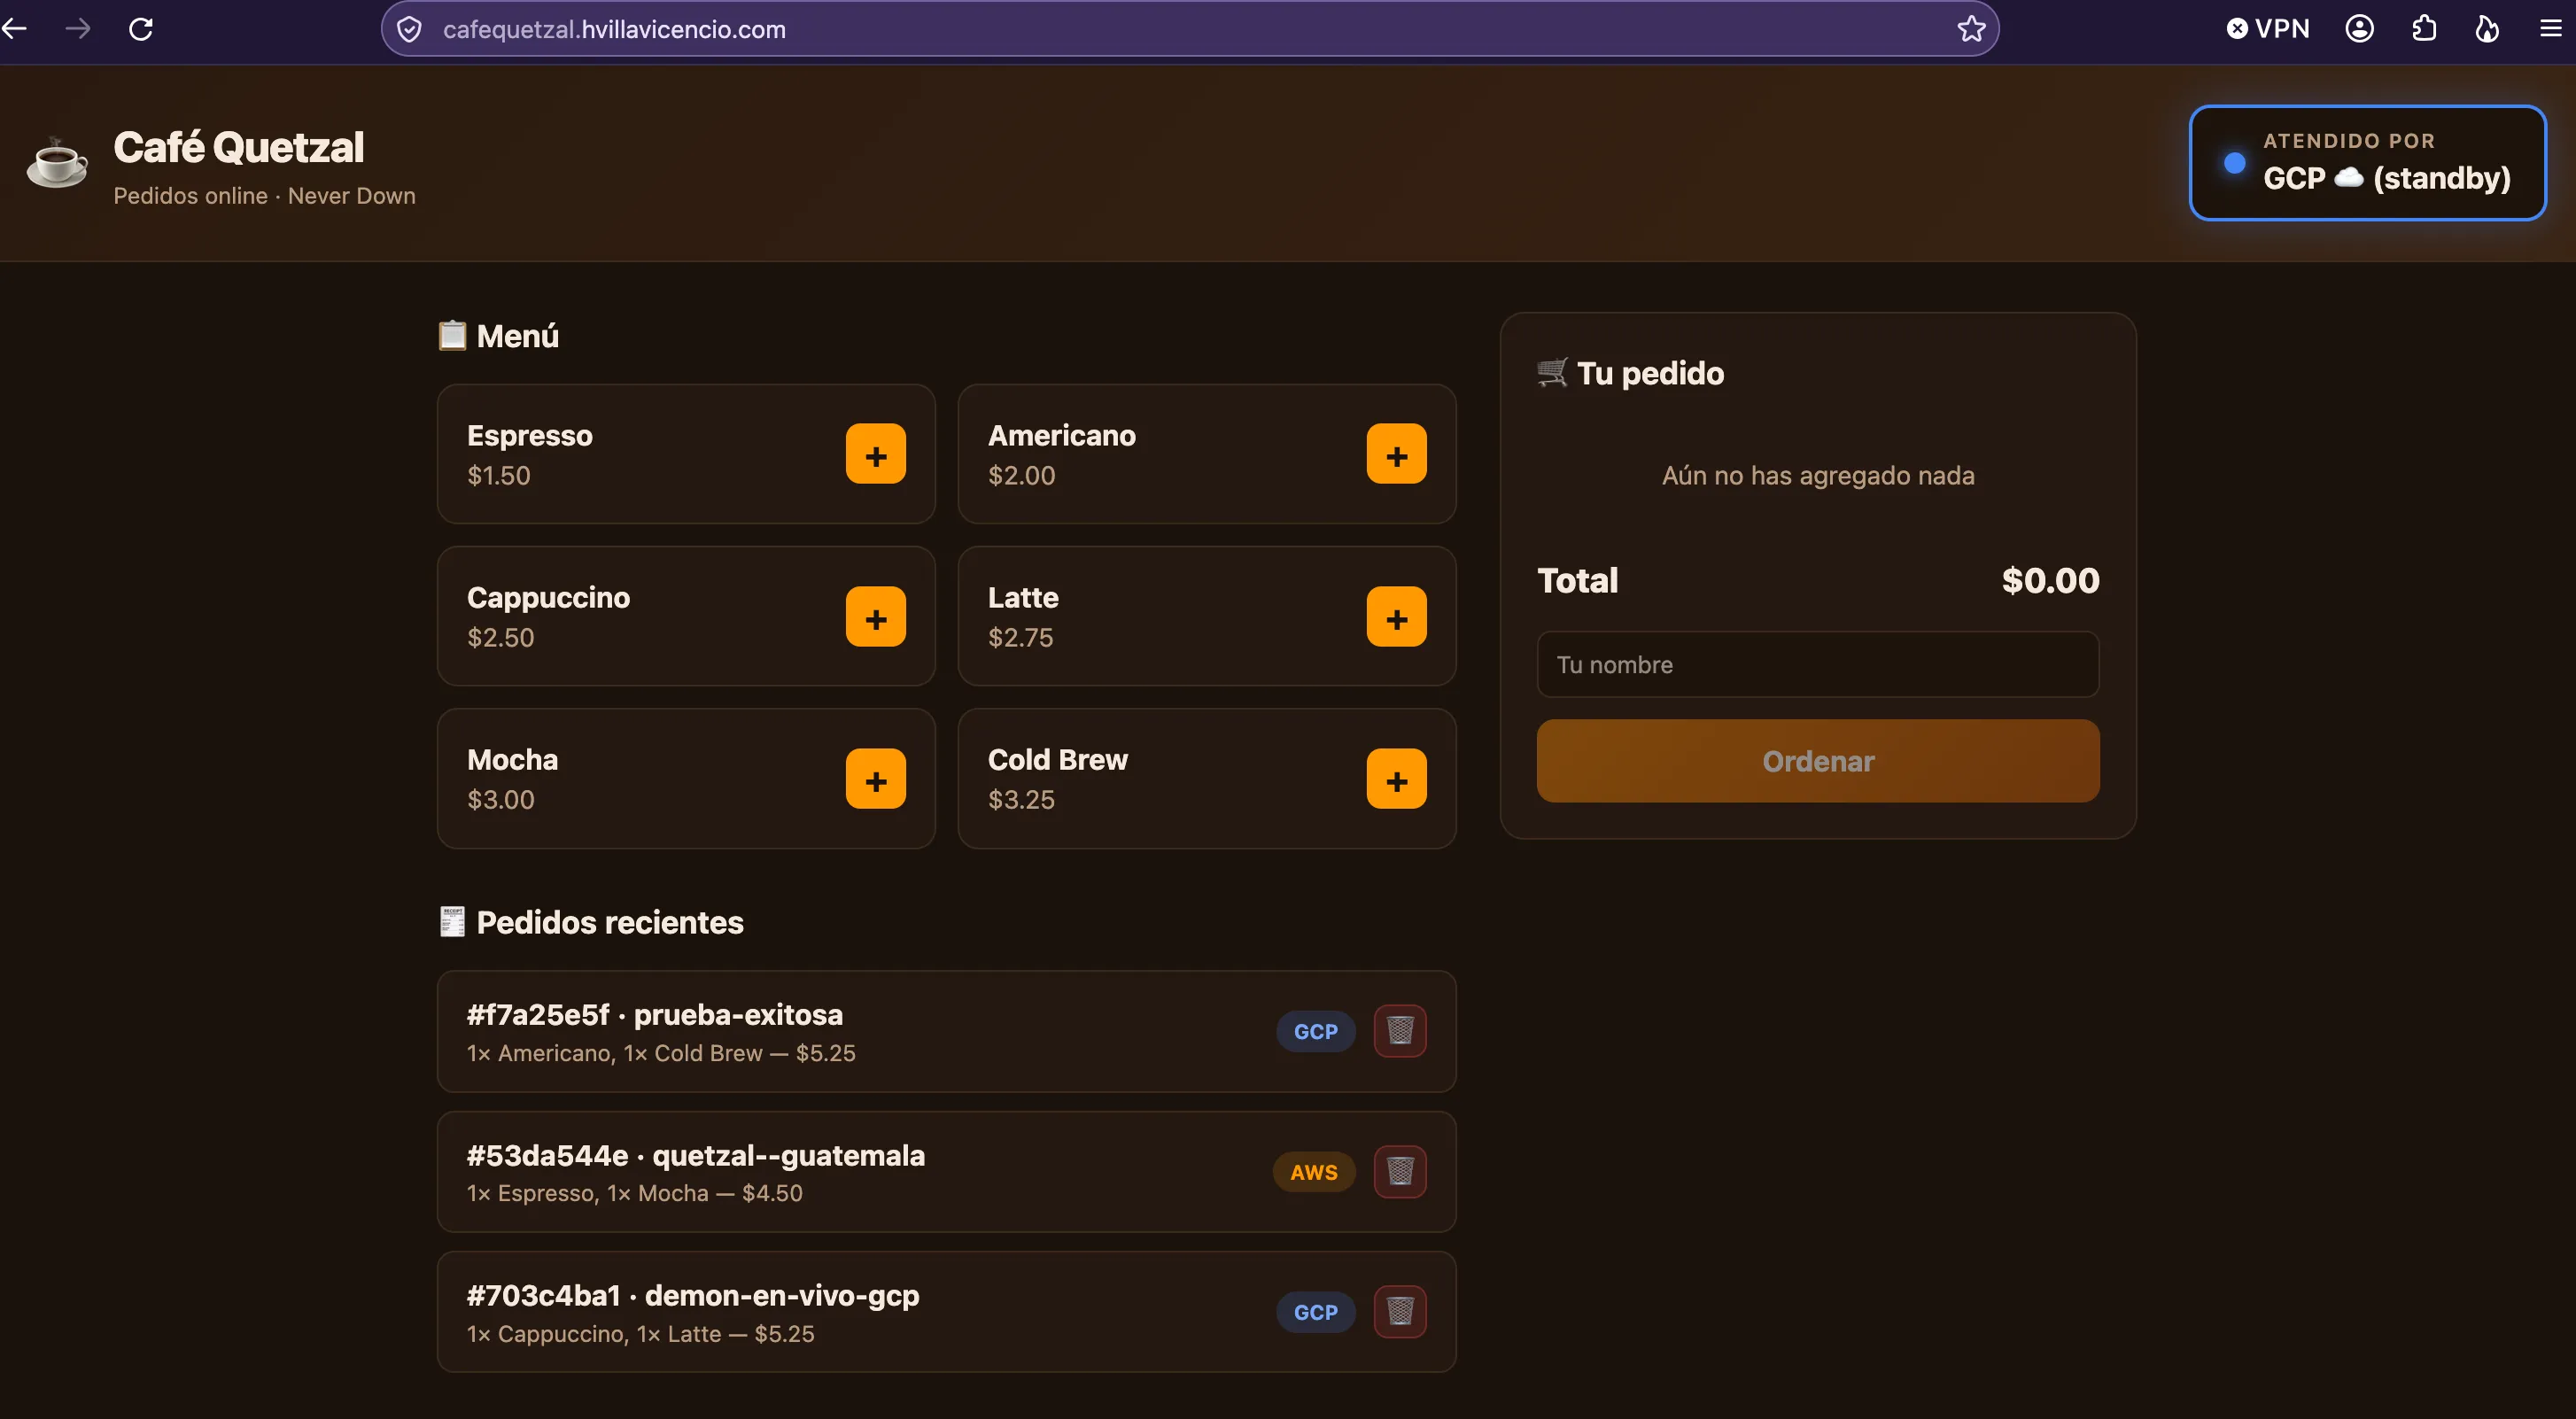
Café Quetzal tiene una tienda, menú, carrito y una API para crear, leer y eliminar pedidos. Las implementaciones de AWS y GCP exponen las mismas rutas funcionales. En /health y en respuestas exitosas JSON de las principales rutas funcionales, como /menu y /orders, el campo served_by hace visible la transición aws-lambda -> gcp-cloud-run; cada orden creado también almacena ese origen. Los controladores de API agregan un encabezado X-Served-By, y el escaparate servido por Cloud Run también incluye ese encabezado, mientras que el escaparate de AWS proviene directamente de CloudFront/S3. Es por eso que no trato ambos marcadores como si estuvieran presentes en cada respuesta: el observador usa /health específicamente para comparar el encabezado, el cuerpo JSON y el tiempo de ejecución sin cambiar la URL pública.
Las dos URL de la demo son https://cafequetzal.hvillavicencio.com para la tienda y https://apicafequetzal.hvillavicencio.com para la API. Presentarlos como URL de prueba no significa una disponibilidad permanente prometedora. Observar serve_by tampoco es suficiente para probar la consistencia de los datos: necesito verificar por separado que los pedidos se replican y reconocer la ventana de escritura que existe durante el regreso a AWS.
1
Advertencia: La API pública de la demo es una simplificación para el escenario: no implementa autenticación ni autorización, y permite CORS desde cualquier origen. No reutilizaría esa postura en producción. Una implementación real debe hacer cumplir la identidad, la autorización por operación, los orígenes restringidos, la minimización de datos, la limitación de la tasa y los controles de abuso. Las capturas de pantalla para su publicación también deben evitar mostrar /pedir respuestas o pedir datos.
Arquitectura: AWS activo, GCP cálido standby

En AWS, CloudFront sirve a la tienda almacenada en un depósito privado de S3. La API utiliza una API de API Gateway HTTP y Lambda, mientras que DynamoDB almacena pedidos en modo bajo demanda y expone Streams. CloudWatch proporciona registros y métricas. EventBridge activa otro Lambda cada minuto, el monitor AI, que consulta Bedrock, persiste en una pista de auditoría, puede actualizar la ruta 53 y publica una notificación a SNS.
En GCP, un balanceador de carga HTTPS global mantiene una IP estática. Certificate Manager prepara TLS para ambos nombres, y un NEG sin servidor conecta el backend a Cloud Run. Un solo servicio de Cloud Run sirve tanto al escaparate como a la API dependiendo de la ruta; Firestore almacena los pedidos. Terraform del proyecto gestiona los recursos de AWS, DNS y los componentes del equilibrador/certificado de carga GCP, pero hace referencia a un servicio Cloud Run y una base de datos de Firestore existentes. Es por eso que no afirmo que una sola terraforma se aplique crea toda la solución.
La ruta 53 mantiene registros ponderados para ambos dominios. En funcionamiento normal, los pesos son AWS=100 y GCP=0; durante la conmutación por error se conmutan a AWS=0 y GCP=100. El peso cero mantiene el destino alternativo descrito, pero no elimina los efectos de TTL y cachés recursivas cuando el interruptor realmente ocurre.
Los datos son más difíciles que los DNS
DynamoDB Streams activa una Lambda de sincronización para cada lote de cambios. Los eventos INSERT y MODIFY producen anuncios en Firestore; REMOVE elimina el documento correspondiente. El Lambda obtiene acceso a Google Cloud a través de la Federación de Identidad de Carga de Trabajo (WIF), sin credenciales de GCP de larga duración. Esta elección reduce los secretos operativos: la identidad de AWS intercambia confianza de corta duración en lugar de almacenar una clave de cuenta de servicio.
La replicación es asíncrona y unidireccional durante el funcionamiento normal. En esta demostración describo su RPO como del orden de los segundos, con eventual coherencia, no con cero RPO, y no un compromiso contractual. No midí un retraso exacto durante la prueba de failover. Un sistema que no puede tolerar la pérdida o retraso de una sola escritura necesitaría un diseño diferente: replicación de base de datos con garantías explícitas, escrituras duales cuidadosamente coordinadas o una estrategia transaccional capaz de resolver conflictos.
La dirección de replicación también crea una obligación: después del cambio, GCP puede aceptar órdenes que nunca existieron en DynamoDB. Voltear DNS sin abordar esos datos produciría una recuperación aparente, pero esos pedidos desaparecerían de la vista del usuario una vez que el tráfico regrese a AWS.
1
Advertencia: Cambiar DNS no es lo mismo que completar una estrategia de recuperación. Hay que diseñar tanto el interruptor de salida como la reconciliación de retorno.
Un agente de IA delimitado por barandillas
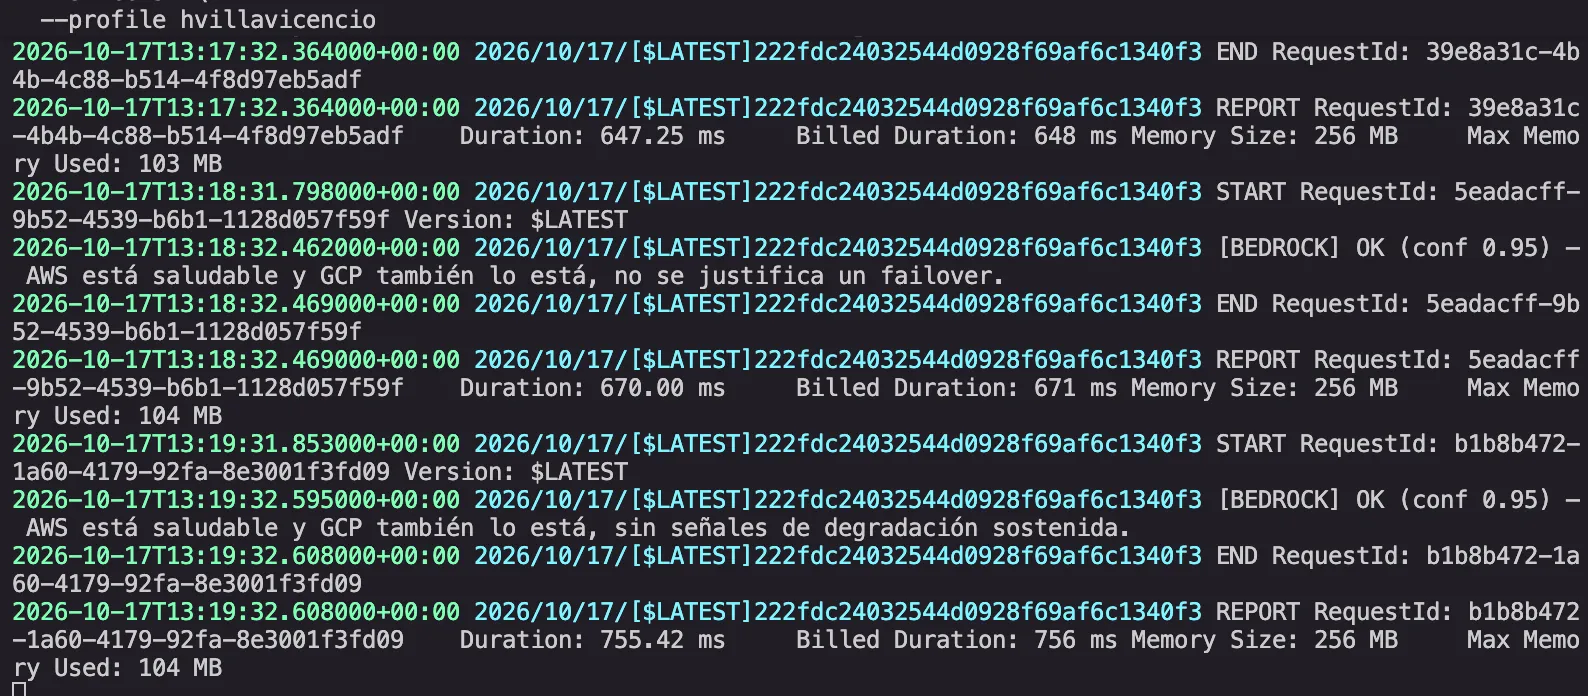
Cada minuto, EventBridge invoca health_monitor.py. El monitor ejecuta sondas directas contra /health tanto en AWS como en GCP, registrando el estado HTTP, la latencia y serve_by. También consulta las métricas de CloudWatch para Invocations, Errors, and Throttles Lambda en una ventana de cinco minutos, y calcula el porcentaje de error. Con esas señales, el estado actual y la historia reciente, construye contexto para Amazon Bedrock.
El modelo activo es Amazon Nova Lite, identificado como amazon.nova-lite-v1:0. Se invoca con la temperatura cero y se le pide una salida JSON estructurada con decisión, confianza y razonamiento. Las decisiones válidas están bien, DEGRADADAS o FALLA. El contexto incluye cuántos ciclos consecutivos han sido poco saludables y las minutas desde el último cambio, por lo que la recomendación explica la persistencia y evita el aleteo prematuro.
El modelo recomienda; el código autoriza. Para que el sistema actúe, todos estos deben alinearse: FALLADO, confianza de al menos 0,8, dos ciclos poco saludables, un GCP saludable, un estado actual distinto de GCP, y AUTO_FAILOVER=true. Solo entonces se han cambiado ambos pares de registros de la Ruta 53, se actualizan el estado y la pista de auditoría en DynamoDB y se publica una notificación de SNS.
1
2
3
4
5
6
7
8
9
10
every minute:
aws, gcp = probe(/health)
metrics = CloudWatch(Invocations, Errors, Throttles, window=5 min)
decision = NovaLite(context, JSON output)
if decision == FAILOVER and confidence >= 0.8
and bad_streak >= 2 and gcp.ok
and current_state != gcp and auto_failover:
Route53(AWS=0, GCP=100)
save_state_and_audit()
publish_SNS()
Este diseño me permite combinar señales heterogéneas y mantener una breve lógica, pero no convierte el LLM en una autoridad infalible. Una regla rígida sería más simple: por ejemplo, dos sondas fallidas más un modo de espera saludable. La IA agrega valor cuando quiero sopesar métricas, historial y degradaciones parciales sin multiplicar las ramas manuales; las barandillas mantienen explícito el radio de la explosión.
No usaría un LLM como el único árbitro para pagos, sistemas críticos para la seguridad, requisitos de cero RPO, entornos regulados o decisiones con criterios totalmente deterministas. Tampoco asumiría que el plano de control sobrevive si el dominio de falla afecta a Lambda, CloudWatch o Bedrock en la misma región. Para esos escenarios, consideraría los controles de estado gestionados, las reglas determinísticas, la aprobación humana, un plano de control independiente o, primero, una arquitectura de múltiples regiones dentro de AWS.
1
Decisión de diseño: La confiabilidad no proviene de "dejar que la IA decida". Proviene de limitar lo que recibe, con lo que puede responder y qué condiciones deterministas deben tener antes de que pueda actuar.
El momento de la interrupción, y lo que realmente midío
La ventana controlada comenzó con una comprobación previa al vuelo en ambas ramas y un observador de solo lectura. El script de interrupción estableció la concurrencia reservada de la aplicación Lambda en cero, simulando la falta de disponibilidad de computación primaria sin destruir la infraestructura. Estos comandos son un resumen del runbook de demostración, no una receta para ejecutar sin aprobación en la producción:
1
2
3
4
5
6
7
8
# Terminal 1: watch the public path
./scripts/watch.sh

# Terminal 2, only during an approved window
./scripts/simulate-failure.sh

# After validating data and primary recovery
./scripts/failback.sh
Me puse a T0 a las 02:09:31Z el 6 de octubre. Un segundo más tarde, el primer ciclo no saludable registró bad_streak=1; Nova Lite respondió bien con confianza 0.95, porque todavía era una sola muestra. A las 02:10:32.461Z, el segundo ciclo produjo FAILOVER, confianza 0.95, y bad_streak=2; el monitor ejecutó el cambio de Ruta 53 aproximadamente 61 segundos después de T0.
El observador local informó primero HTTP 503 y luego respuestas opacas, por lo que la ejecución se clasificó inicialmente como fallida desde el punto de vista de ese cliente. El diagnóstico posterior cambió esa interpretación con la evidencia del lado del servidor: Cloud Run registró la tienda pública con HTTP 200 a las 02:11:08.548Z, y la publicidad / salud con HTTP 200 a las 02:11:08.799Z. La primera evidencia apareció alrededor de 97,5 segundos después de T0 y 36,1 segundos después de la acción DNS. Durante esa ventana hubo 154 solicitudes GET públicas a `/salud', todas HTTP 200.
Es por eso que publico dos números separados: ~61 s para detectar, decidir y ejecutar el switch; ~97.5 s hasta la primera disponibilidad pública confirmada en Cloud Run. El RTO percibido por un cliente debe medirse desde ese cliente, y puede variar según los solucionadores, la red y la caché. Este resultado pertenece a una carrera de prueba; no es un SLA universal.


Lo que el observador me enseñó sobre el DNS
El observador anterior corrió a cavar y rizar por separado. Incluso si la excavación mostraba la IP de GCP, eso no probó que curl hubiera usado esa respuesta: curl podría consultar el solucionador del sistema, obtener una entrada diferente o pasar por una ruta local transitoria. Además de eso, ocultaba stderr y no grababa la IP remota, los tiempos o el código de salida. La causa raíz confirmada fue una observabilidad insuficiente; el almacenamiento en caché o la resolución local es una hipótesis probable, no una certeza retroactiva.
Arreglé el observador para consultar un solucionador de DNS público configurable, elegir un registro A y forzar esa misma solicitud para conectarse allí usando curl --resolve. Esto conserva el nombre de host, el encabezado Host, el SNI y la validación TLS. Cada muestra ahora registra el dispositivo de resolución, las respuestas DNS y TTL, seleccionado, remote_ip, estado HTTP, código de salida, connect/TLS/TTFB/total timings, serve_by tanto desde el encabezado como desde el cuerpo JSON, y el verdadero stderr. La igualdad entre selected y remote_ip convierte el camino real utilizado en evidencia en lugar de una suposición.
La prueba forzada contra GCP, junto con los registros, confirmó que el Load Balancer, TLS, NEG sin servidor y Cloud Run funcionaban correctamente. Aprendí a no confundir una búsqueda de DNS separada con la conexión real, ni un proceso de rizo recién generado con una resolución necesariamente nueva.
1
Lección aprendida: Un RTO creíble necesita una definición de T0, una señal T1 observada por el cliente, y suficiente evidencia para explicar el camino entre los dos puntos.
Volviendo a AWS: reconciliación deliberada y los límites de la demostración
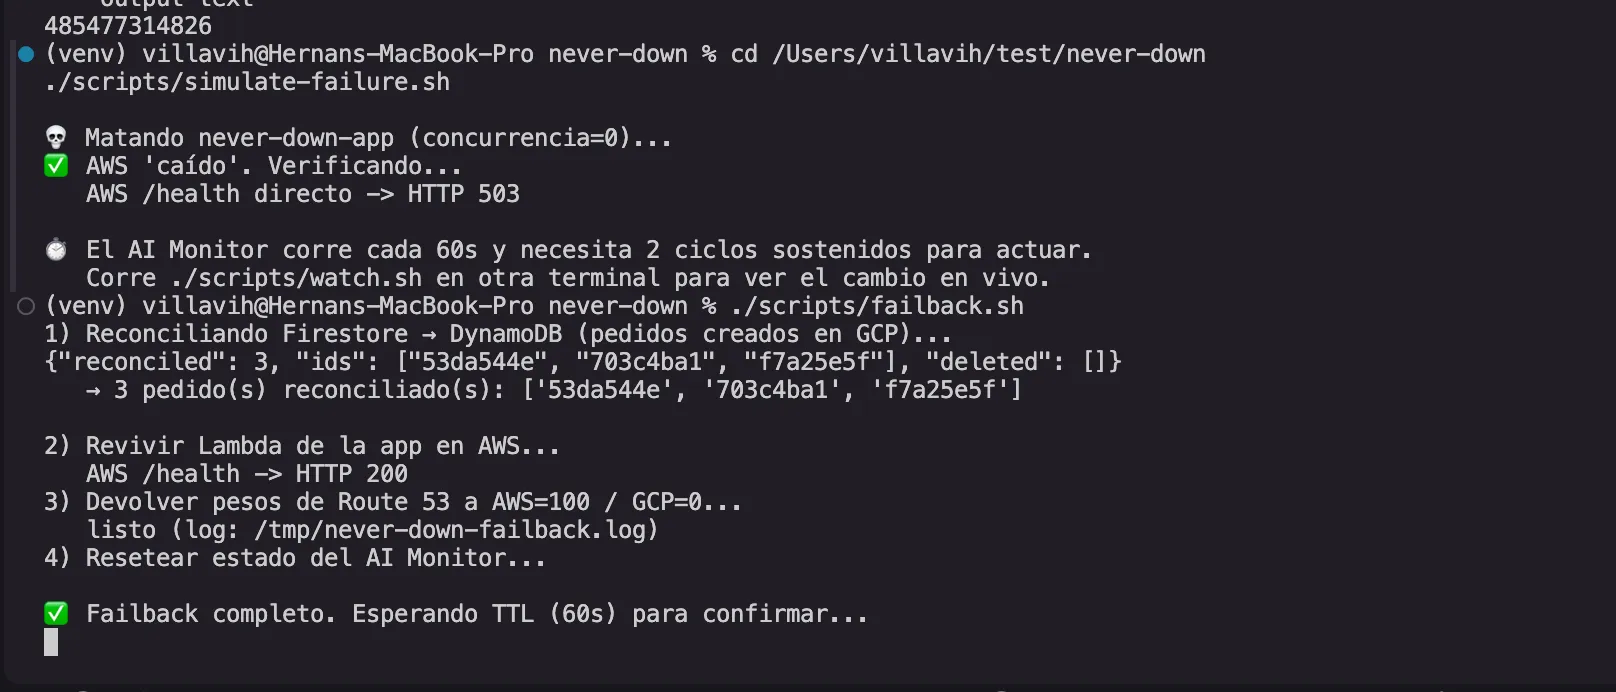
La conmutación por error AWS->GCP es automática; la failback es manual y deliberada. Mientras que GCP actúa como el principal, Firestore puede contener nuevos pedidos. Las deleciones también crean lápidas en una colección separada, por lo que el paso de reconciliación también puede aplicar esas eliminaciones a DynamoDB.
failback.sh primero invoca la reconciliación Lambda. Realiza un solo barrido de pedidos en vivo de Firestore y realiza anuncios en DynamoDB; luego procesa lápidas, aplica las eliminaciones y elimina cada marcador usado. Después de eso, vuelve a activar la aplicación Lambda, devuelve los pesos a AWS = 100/GCP=0 y restablece el estado del monitor. Este orden recupera los datos observados durante ese barrido, pero es el mejor esfuerzo: el script no bloquea las escrituras en GCP, y no mantiene un punto de control incremental.
Hay una ventana entre el barrido y el último cliente que deja GCP debido a la propagación o el almacenamiento en caché de DNS. Una orden creada o eliminada en ese intervalo podría terminar viviendo solo en Firestore. Para cerrar esa ventana en la producción, drenaría o congelaría temporalmente las escrituras, capturaría una marca de agua, reconciliaría gradualmente y ejecutaría un pase final verificado antes de declarar el failback completo. También probaría ese procedimiento de extremo a extremo en concurrencia.
No automato el retorno de la primera señal verde, porque una primaria recuperada no prueba que sea estable o que sus datos estén completos. Prefiero verificar el estado, controlar las escrituras, conciliar y abrir el tráfico conscientemente. restore.sh tiene un propósito diferente: un restablecimiento de emergencia o un reinicio después de una prueba sin datos de GCP que valgan la pena rescatar. Usarlo después de recibir pedidos reales en GCP se saltaría incluso la reconciliación de mejor esfuerzo que está disponible.
Cuánto cuesta quedarse nunca abajo
Separé el costo incremental de ejecutar la demostración del costo mensual de mantener un modo de espera direccionable. Las cifras a continuación son estimaciones, no una factura, y deben verificarse con respecto a los precios actuales, región, moneda, nivel libre y configuración antes de la publicación.
| Component | Type | Publishable assumption | What stays variable |
|---|---|---|---|
| Route 53 hosted zone | Shareable fixed monthly cost | About USD 0.50/month; the zone can serve other systems | DNS queries and applicable policies |
| GCP global forwarding rule | Fixed while it exists | About USD 0.025/h, roughly USD 18.25 per 730 h before traffic | Processing, networking, and other LB components |
| AI Monitor | Recurring, usage-based | One cycle/minute equals about 43,200 cycles in 30 days | Tokens, Lambda duration, metrics, logs, and requests |
| Application and data | Variable | Pay for actual usage | API Gateway, DynamoDB, SNS, S3, CloudFront, Cloud Run, Firestore, storage, and egress |
El costo incremental de una demo corta puede ser pequeño, porque muchos servicios cobran por uso, pero eso no representa el costo mensual del standby. La regla de reenvío global introduce una base aproximada de USD 18.25/mes antes del tráfico, y la zona DNS funciona alrededor de USD 0.50/mes, incluso si se puede compartir. Nova Lite es facturado por tokens; sin medir la entrada, la salida y la facturación real, no debería inventar un total. Las solicitudes, los registros, el almacenamiento y la salida también varían en ambas nubes.
1
Advertencia: Estas cifras son estimaciones basadas en los precios públicos en el momento en que se escribió este artículo. Verifique siempre las páginas de precios oficiales antes de tomar decisiones presupuestarias, ya que los precios pueden cambiar con el tiempo, por región o por configuración.
Cuándo usar este patrón y cuándo no
Consideraría este patrón para cargas de trabajo que toleran la consistencia eventual, donde el impacto del tiempo de inactividad justifica el funcionamiento de dos nubes, y donde el equipo puede probar la identidad, los datos, el DNS y los libros de runbooks en ambos proveedores. También exige observabilidad compartida y propietarios claros para el failback. El diagrama multinube es la parte fácil; mantenerlo ejercido es el compromiso real.
No comenzaría con multicloud si AWS multi-AZ o multi-región ya cubre los objetivos con menos complejidad. Tampoco lo usaría si no puedo probar el camino alternativo de manera recurrente, si el RPO exige cero pérdida, o si una regla determinista ya expresa completamente la decisión. En esos casos, agregar un LLM puede aumentar las dependencias sin mejorar el control.
Lecciones que estoy llevando conmigo
Voy a tomar cinco lecciones de este juicio. En primer lugar, medir la decisión y la disponibilidad como hitos separados. En segundo lugar, mantenga la evidencia tanto del cliente como del servidor. En tercer lugar, pruebe el failback y sus datos con la misma seriedad que la conmutación por error. En cuarto lugar, separar el precio de una carrera del costo fijo de mantenerse listo. En quinto lugar, utilice la IA dentro de los límites verificables: salida estructurada, estados permitidos, confianza mínima y condiciones deterministas.
Cómo reproducir el enfoque de forma segura
El orden que recomiendo es: desplegar ambas ramas, ejecutar un prevuelo directo y público, probar la replicación, validar la ruta GCP con curl --resolve, abrir una ventana aprobada, observar sin escrituras innecesarias, medir T0/T1 y terminar con un failback reconciliado. Nunca empezaría por desencadenar el apagón. Antes de compartir el código, también comprobaría que la documentación y las salidas no exponen los identificadores, secretos o datos de pedido.
Repositorio: https://github.com/VillaviH/never-down
Conclusión
Never Down comenzó con una simple pregunta: ¿puedo seguir aceptando un pedido de café cuando falla el primario? La respuesta requería mucho más que cambiar de DNS. Necesitaba datos preparados, una decisión limitada, evidencia del camino público y un failback que reconciliara lo que observaba sin ocultar su ventana de escritura pendiente. Amazon Nova Lite ayuda a interpretar el contexto, pero la confiabilidad proviene de barandillas, mediciones y runbooks probados. En la recuperación, una transición visible es útil; una transición explicable, verificable y reversible es mejor.
Referencias oficiales
1. Amazon Route 53 — weighted routing: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/routing-policy-weighted.html
2. Amazon Route 53 — pricing: https://aws.amazon.com/route53/pricing/
3. Amazon Bedrock — InvokeModel: https://docs.aws.amazon.com/bedrock/latest/APIReference/API_runtime_InvokeModel.html
4. Amazon Nova on Amazon Bedrock: https://docs.aws.amazon.com/nova/latest/userguide/what-is-nova.html
5. Amazon Bedrock — pricing: https://aws.amazon.com/bedrock/pricing/
6. AWS Lambda: https://docs.aws.amazon.com/lambda/latest/dg/welcome.html
7. DynamoDB Streams with AWS Lambda: https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/Streams.Lambda.html
8. Route 53 weighted routing: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/routing-policy-weighted.html
9. EventBridge scheduled rules: https://docs.aws.amazon.com/eventbridge/latest/userguide/eb-run-lambda-schedule.html
10. Google Cloud Run: https://cloud.google.com/run/docs/overview/what-is-cloud-run
11. Google Cloud Firestore: https://cloud.google.com/firestore/docs/overview
12. Google Cloud Workload Identity Federation with AWS: https://cloud.google.com/iam/docs/workload-identity-federation-with-other-clouds
13. Google Cloud serverless NEGs: https://cloud.google.com/load-balancing/docs/negs/serverless-neg-concepts
14. HTTPS Load Balancing with Cloud Run: https://cloud.google.com/load-balancing/docs/https/setting-up-https-serverless
15. Google Cloud Load Balancing — pricing: https://cloud.google.com/load-balancing/pricing
16. Terraform AWS provider: https://registry.terraform.io/providers/hashicorp/aws/latest/docs
17. Terraform Google provider: https://registry.terraform.io/providers/hashicorp/google/latest/docs
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article