
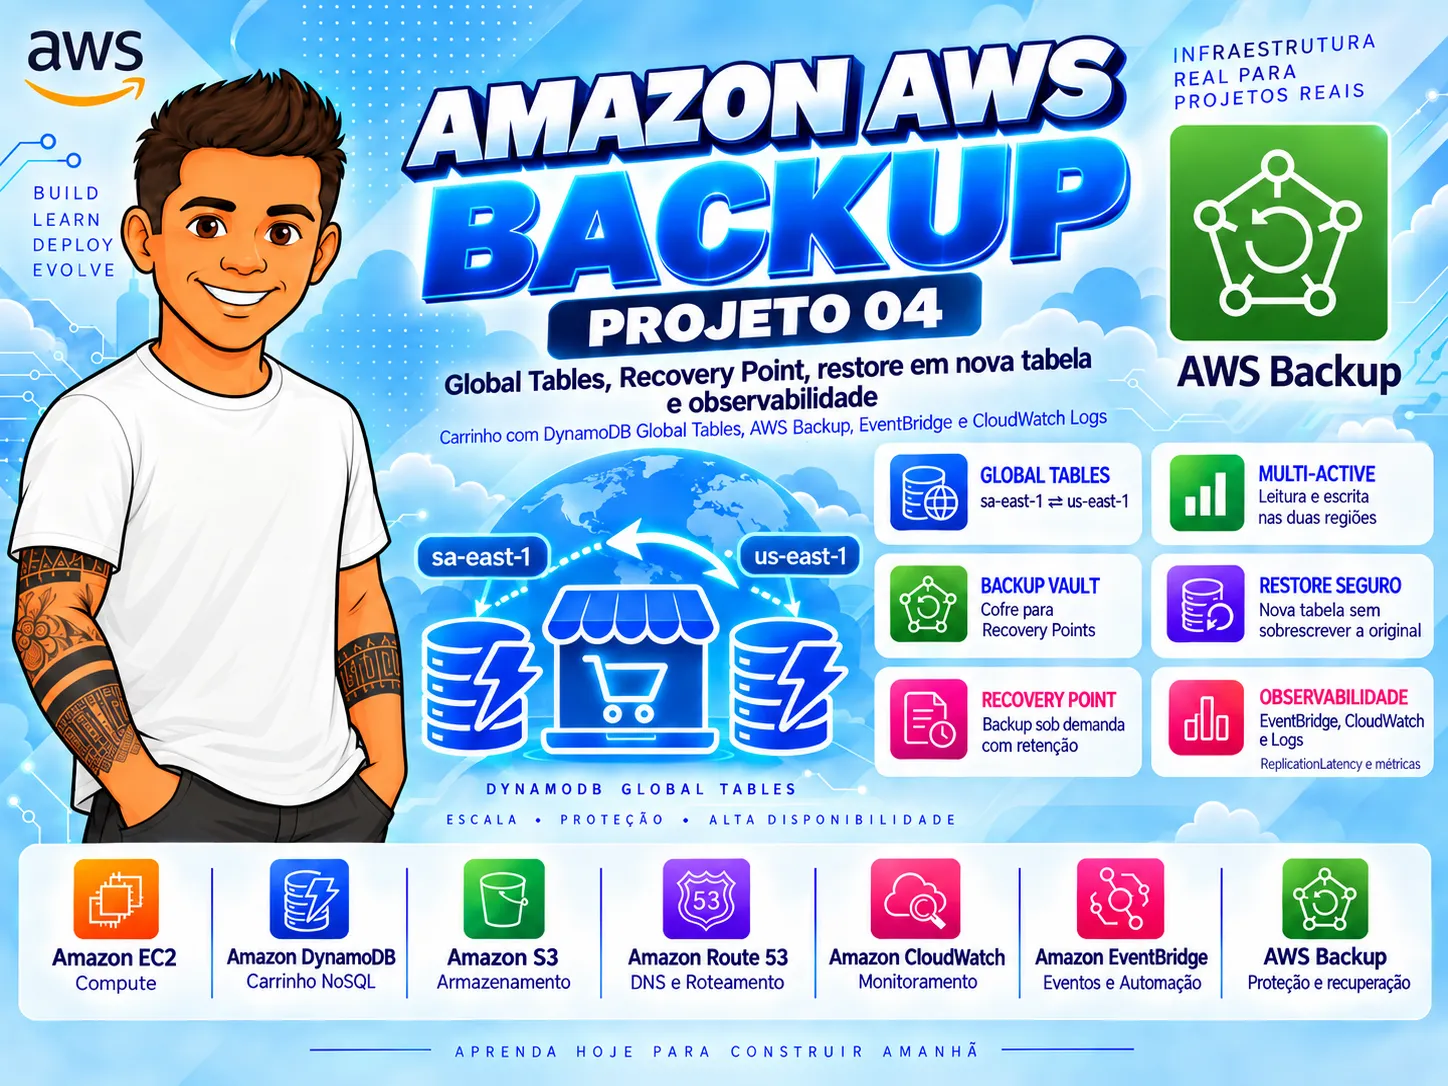
Backup Sem Fronteiras — AWS Backup e DynamoDB replicação multi-região
Projeto 04 — AWS Global Database & Backup Lab DNS: dynamodb-lab.inhesta.net (reaproveitado do Projeto 03 — mesma aplicação, mesma EC2)
Estratégia de reaproveitamento (Projeto 01 é a fonte de verdade)
Este projeto não cria nova aplicação (Requisito 10.1). Ele reaproveita integralmente a aplicação já implantada nos Projetos 01, 02 e 03 e documenta apenas o delta — o que muda ao evoluir a tabela carrinho-lab para DynamoDB Global Tables e ao adicionar AWS Backup (Requisitos 10 e 13.7).
O delta do Projeto 04 é infraestrutura, não código: a aplicação continua a mesma do Projeto 03 (carrinho no DynamoDB), e a evolução acontece fora do app (uma segunda região para a tabela e um serviço de backup gerenciado).
Regiões deste projeto: origem us-east-1 — Norte da Virgínia (onde tudo foi criado) e réplica us-east-2 — Ohio (segunda região da Global Table).
O que é reaproveitado dos projetos anteriores

Onde está o código: a pasta 04-global-database-backup/app/ não contém cópia do código. Ela traz apenas um README.md apontando para a fonte de verdade em 01-rds-resilience/app/. Isso evita duplicação e mantém um único lugar para manter o código (Req. 13.7). Nenhum código novo é necessário para as Global Tables — é configuração de infraestrutura; o app apenas continua usando a tabela carrinho-lab (agora global) na região configurada.

Ver credenciais de conteúdo
O que é o delta do Projeto 04
O que efetivamente muda em relação ao Projeto 03:
- DynamoDB Global Tables: a tabela carrinho-lab ganha uma réplica em us-east-2 (origem us-east-1), operando multi-região e multi-active (escrita e leitura em qualquer região). Métrica de interesse: ReplicationLatency.
- Replicação bidirecional: escrita em us-east-1 replica em us-east-2, e escrita em us-east-2 replica em us-east-1 (Tarefa 44).
- AWS Backup (ciclo completo): criação manual de Backup Vault, Backup Plan, Backup Rule, seleção de recursos, geração de Recovery Point e Restore — não termina ao só criar o backup; executa BACKUP → VALIDAR → RESTORE → VALIDAR DADOS (Tarefas 45-46).
- EventBridge + AWS Backup: regra para Backup Job State Change e Restore Job State Change, com fluxo AWS Backup → EventBridge → CloudWatch Logs e o Log Group /aws/events/db-lab-04-backup (Tarefa 47).
- DNS: continua dynamodb-lab.inhesta.net (mesma EC2, mesma aplicação) — não há novo DNS.
A aplicação não muda. Produtos, clientes e pedidos permanecem no banco relacional; o carrinho permanece no DynamoDB. A evolução é de infraestrutura (segunda região + backup gerenciado).
Problema
O carrinho no DynamoDB (Projeto 03) roda em uma única região (us-east-1). Isso deixa duas lacunas para um cenário de produção:
- Resiliência e latência regional: uma falha de região deixaria o carrinho indisponível, e usuários distantes da Virgínia teriam latência maior. Não há presença em outra região.
- Backup auditável e centralizado: o PITR do Projeto 03 protege contra erro de dados dentro da janela, mas queremos também um mecanismo de backup/restore gerenciado, agendável e auditável (com pontos de recuperação retidos por política e trilha de eventos).
Objetivo
Evoluir o dado do carrinho para multi-região e adicionar backup gerenciado, reaproveitando toda a aplicação:
- DynamoDB Global Tables: adicionar réplica em us-east-2 (origem us-east-1), estudando Multi-Region, Multi-Active e ReplicationLatency;
- replicação bidirecional: comprovar que a escrita em qualquer região aparece na outra;
- AWS Backup: montar Vault + Plan + Rule + seleção e executar o ciclo completo BACKUP → VALIDAR → RESTORE → VALIDAR DADOS;
- observabilidade: ReplicationLatency no CloudWatch e o fluxo AWS Backup → EventBridge → CloudWatch Logs.
Arquitetura (ANTES → DEPOIS)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
ANTES (Projeto 03, arquitetura final) — carrinho no DynamoDB single-region
Usuário → Route 53 (dynamodb-lab.inhesta.net) → EC2 (Flask)
                                                 ├── banco relacional (produtos, clientes, pedidos)
                                                 ├── Amazon DynamoDB (carrinho-lab)  [us-east-1, PITR]
                                                 └── imagens no Amazon S3

DEPOIS (Projeto 04) — Global Tables multi-região + AWS Backup
Usuário → Route 53 (dynamodb-lab.inhesta.net) → EC2 (Flask)  [MESMA EC2, MESMA APLICAÇÃO]
                                                 ├── banco relacional (produtos, clientes, pedidos)
                                                 ├── Amazon DynamoDB Global Tables (carrinho-lab)
                                                 │        us-east-1  ⇄  us-east-2   (multi-active)
                                                 │        métrica: ReplicationLatency
                                                 ├── AWS Backup
                                                 │        Vault → Plan → Rule → Seleção
                                                 │        → Recovery Point → Restore → validar dados
                                                 └── imagens no Amazon S3  [MESMO BUCKET]

Observabilidade:
   AWS Backup (Backup/Restore Job State Change) → EventBridge → CloudWatch Logs
   Log Group: /aws/events/db-lab-04-backup
O único bloco que evolui é o dado do carrinho (single-region → global) e a adição do AWS Backup. A camada de computação (EC2), o front-end, as imagens (S3), o relacional e o DNS continuam iguais.

Ver credenciais de conteúdo
Serviços utilizados
- Novo no Projeto 04: DynamoDB Global Tables (réplica em us-east-2), AWS Backup (Backup Vault, Backup Plan, Backup Rule, Recovery Point, Restore).
- Reaproveitados dos projetos anteriores: Amazon DynamoDB (carrinho-lab), Amazon EC2, Amazon S3, banco relacional (RDS ou Aurora), Amazon Route 53, Amazon CloudWatch, Amazon EventBridge, CloudWatch Logs.
Controle de custo (Requisitos 10.2 e 12)
ATENÇÃO DE CUSTO — recursos multi-região e Backup Vault geram cobrança.
- Global Tables (segunda região): ao adicionar a réplica em us-east-2, passa a haver armazenamento na segunda região e gravações replicadas (rWCU) cobradas em cada região. A cobrança começa ao criar a réplica e dura enquanto ela existir. Detalhes e passo a passo em IMPLANTACAO.md.
- AWS Backup: cobra por armazenamento de Recovery Points (por GB) e por restore. A cobrança começa ao gerar o primeiro Recovery Point.
- Quando remover: ao concluir os testes, remover a réplica de us-east-2, excluir os Recovery Points e o Backup Vault (consolidado na Tarefa 48). Nunca manter, sem necessidade, recursos multi-região e backups acumulados (Req. 12.2, 12.3).
Testes
Ver TESTES.md: replicação bidirecional entre us-east-1 e us-east-2 (escrever em uma região e verificar na outra), observação de ReplicationLatency e o ciclo completo de backup (BACKUP → VALIDAR → RESTORE → VALIDAR DADOS), sem encerrar ao apenas criar o backup (Req. 10.7).
Observabilidade
- Métrica de replicação: ReplicationLatency (CloudWatch).
- Fluxo AWS Backup → EventBridge → CloudWatch Logs para Backup Job State Change e Restore Job State Change, com o Log Group /aws/events/db-lab-04-backup.
Resultados e aprendizados
Com o delta de infraestrutura concluído (Tarefas 43-47) e a limpeza final documentada (Tarefa 48), o Projeto 04 comprovou:
Resultados (evidências em evidencias/, resultados observados em TESTES.md):
- Réplica em us-east-2 ativa e validada por operação real — não apenas pelo status "Ativa" (Req. 14.4): gravação em us-east-1 e leitura confirmada em us-east-2.
- Replicação bidirecional comprovada nos dois sentidos: us-east-1 → us-east-2 (Multi-Region) e us-east-2 → us-east-1 (Multi-Active — a região "secundária" aceita escrita e replica de volta).
- ReplicationLatency medida no CloudWatch (AWS/DynamoDB, dimensões TableName + ReceivingRegion), tipicamente entre centenas de ms e ~1s.
- Ciclo completo de AWS Backup BACKUP → VALIDAR → RESTORE → VALIDAR DADOS (Req. 10.7): Recovery Point gerado e validado, restaurado numa nova tabela (carrinho-lab-restore) e dados conferidos contra os itens conhecidos, com a tabela de origem intacta.
- Eventos de Backup/Restore localizados no Log Group /aws/events/db-lab-04-backup, com backupJobId/restoreJobId correlacionados aos jobs do Console (fluxo AWS Backup → EventBridge → CloudWatch Logs, Req. 10.8).
- Custo controlado e encerramento da série: a seção "Limpeza final (zerar custo — Tarefa 48)" do IMPLANTACAO.md consolida a limpeza final de todos os 4 projetos para zerar o custo (Req. 12.2/12.3).
Aprendizados-chave:
- Multi-Region ≠ Multi-AZ ≠ Read Replica. Multi-AZ e réplicas de leitura resolvem disponibilidade e escala dentro de uma região; Global Tables resolve entre regiões, com escrita em todas as réplicas (multi-active) e replicação assíncrona (consistência eventual, ~1s; conflito resolvido por last writer wins).
- AWS Backup ≠ PITR. AWS Backup entrega Recovery Points discretos, cofre centralizado, retenção por política e auditoria (governança/compliance, retenção longa, múltiplos serviços). PITR entrega backup contínuo com RPO de segundos, dentro da região. Os dois se complementam conforme o RPO/RTO exigido.
- RTO/RPO na prática: o RPO do AWS Backup é limitado pela frequência do plano; o RTO de ambos depende do tempo de restore + redirecionar a aplicação para a nova tabela.
- Um backup só é confiável depois de restaurado — daí o ciclo obrigatório terminar em VALIDAR DADOS, não em "criar o backup".
Narrativa técnica completa na seção "Artigo técnico do projeto" mais abaixo (incluindo a relação com o AWS SAA).
Nota sobre reaproveitamento (Req. 13.7)
Os Projetos 02, 03 e 04 reaproveitam o máximo possível do Projeto 01, sem recriar aplicação, layout ou componentes reutilizáveis. O Projeto 01 (01-rds-resilience/) é a fonte de verdade do código-fonte, do schema SQL, do layout e da documentação base. Cada projeto seguinte documenta apenas o delta em relação ao anterior:
- Projeto 02 (Aurora): muda apenas o backend relacional (RDS → Aurora) e a configuração de endpoints; mesmo código.
- Projeto 03 (DynamoDB): move o carrinho para DynamoDB alterando a implementação de cart.py (CART_MODE=dynamodb); produtos/clientes/pedidos permanecem no relacional.
- Projeto 04 (Global Tables + AWS Backup): evolui o DynamoDB para multi-região e adiciona backup gerenciado; não cria nova aplicação (Req. 10.1). O delta é de infraestrutura; o código da aplicação não muda. Se um dia for preciso ler/gravar explicitamente em us-east-2, isso seria um delta opcional feito na fonte de verdade (ver app/README.md), mas não é essencial.
Documentos relacionados
- ARQUITETURA.md — evolução ANTES vs. DEPOIS (DynamoDB single-region us-east-1 → Global Tables us-east-1 ⇄ us-east-2 + AWS Backup).
- IMPLANTACAO.md — passo a passo no Console AWS (Português-Brasil): Global Tables, AWS Backup e EventBridge (origem us-east-1, réplica us-east-2).
- TESTES.md — passo a passo de como executar os testes do delta (replicação bidirecional entre us-east-1 e us-east-2, e ciclo de backup/restore).
- app/README.md — por que a pasta não contém código, onde está a fonte de verdade e por que nenhum código novo é necessário para as Global Tables.
Artigo técnico do projeto
Narrativa técnica do quarto e último laboratório da série AWS Database Evolution Labs. Diferente da visão geral acima, aqui o foco é o raciocínio por trás da evolução — por que a arquitetura mudou, o que foi comprovado e como isso cai numa questão do AWS Certified Solutions Architect – Associate (SAA-C03).
Problema inicial
Ao final do Projeto 03, o carrinho da loja já vivia num serviço NoSQL gerenciado — a tabela Amazon DynamoDB carrinho-lab, em modo On-Demand, com PITR habilitado para recuperar dentro de uma janela. Foi um grande avanço em relação ao carrinho relacional original, mas restavam duas fraquezas típicas de um cenário real de produção:
- Região única. Toda a tabela vivia em uma única região. Se essa região tivesse um incidente, o carrinho ficaria indisponível — e usuários distantes teriam latência maior para ler e gravar. Não havia presença em outra região.
- Backup disperso e não auditável. O PITR protege contra erro de dados dentro de sua janela, mas é específico do DynamoDB, fica "dentro" da tabela e não oferece um catálogo centralizado, com retenção definida por política e trilha de eventos dos jobs. Faltava um mecanismo de backup gerenciado, agendável e auditável, do tipo que um time de governança/compliance espera ter.
O tema deste laboratório, portanto, foi: resiliência regional e backup gerenciado.
Limitação
Um dado em uma única região tem dois limites estruturais que não se resolvem com ajuste de código: disponibilidade regional (a falha da região derruba o dado) e latência geográfica (quem está longe da região paga o custo da distância em cada leitura/escrita). Além disso, o PITR sozinho não cobre a necessidade de governança de backup — retenção por política, cofre centralizado e auditoria de quem/quando fez backup e restore. São problemas de arquitetura, e a resposta da AWS para eles é justamente o que este projeto explora.
Decisão arquitetural
Duas evoluções complementares, ambas fora do código da aplicação:
- DynamoDB Global Tables (v2, 2019.11.21): transformar carrinho-lab numa tabela multi-região e multi-active, adicionando uma réplica numa segunda região. Em Global Tables v2, todas as réplicas aceitam escrita e leitura — não existe "região primária" nem "réplica só de leitura". A replicação é assíncrona (consistência eventual entre regiões, tipicamente ~1s), com resolução de conflito por "a última escrita vence" (last writer wins).
- AWS Backup: adicionar um serviço de backup gerenciado com Backup Vault (cofre), Backup Plan e Backup Rule (política de frequência e retenção), gerando Recovery Points discretos e permitindo Restore auditável.
Um ponto de projeto importante: o AWS Backup para DynamoDB é regional. Ele protege a réplica da tabela na região onde o backup é configurado, não a Global Table como um todo. Por isso a estrutura de backup é configurada na região de origem, sobre a réplica local.
Implementação
O delta foi todo de infraestrutura, feito manualmente no Console AWS (Português-Brasil), sem tocar em app.py/cart.py:
- Réplica multi-região: na tabela carrinho-lab, aba Tabelas globais → Criar réplica na segunda região. O Console habilita automaticamente o DynamoDB Streams (visão "nova e antiga imagem"), pré-requisito da replicação v2 — não é preciso configurá-lo à mão.
- AWS Backup: criar o Backup Vault db-lab-04-vault, o Backup Plan db-lab-04-plano com a regra db-lab-04-regra-diaria (retenção curta, 7 dias, de propósito, para limitar custo) e a seleção de recursos db-lab-04-carrinho apontando para carrinho-lab, usando a role de serviço padrão AWSBackupDefaultServiceRole.
- EventBridge: criar o Log Group /aws/events/db-lab-04-backup e a regra db-lab-04-backup-eventos (padrão source = aws.backup, detail-type = Backup Job State Change + Restore Job State Change, alvo = o Log Group).
Teste e falha simulada
A comprovação seguiu o princípio da série: não basta o status "Ativa" (Req. 14.4). A replicação bidirecional foi testada nos dois sentidos:
- Origem → Réplica (Multi-Region): put-item na origem, aguardar ~5s, get-item na réplica — o item aparece na segunda região.
- Réplica → Origem (Multi-Active): put-item diretamente na réplica, aguardar ~5s, get-item na origem — o item aparece de volta. Este é o teste que prova o comportamento multi-active: a "região que seria só réplica" aceita escrita normalmente e replica de volta.
Para o AWS Backup, o ciclo completo — nunca encerrando ao apenas criar o backup (Req. 10.7): BACKUP (Recovery Point on-demand) → VALIDAR (Recovery Point Concluído, origem correta, tamanho > 0) → RESTORE (nova tabela carrinho-lab-restore) → VALIDAR DADOS (os itens conhecidos gravados antes do backup reaparecem na tabela restaurada, e a origem permanece intacta). A "falha" simulada é a de perda/erro de dados: comprovar que, ao restaurar, os dados voltam exatamente como no momento do backup. O detalhe conceitual mais importante — igual ao PITR — é que o restore do DynamoDB cria uma NOVA tabela; ele nunca sobrescreve a origem. Por isso a validação é sempre uma comparação entre original e restaurada.
Observabilidade
- ReplicationLatency (CloudWatch, namespace AWS/DynamoDB, dimensões TableName + ReceivingRegion): mede, em milissegundos, o atraso entre a escrita numa região e sua aplicação na região que recebe a réplica. Valores baixos e estáveis indicam replicação saudável; picos indicam atraso.
- Eventos de Backup/Restore: o fluxo AWS Backup → EventBridge → CloudWatch Logs grava cada Backup Job State Change e Restore Job State Change no Log Group /aws/events/db-lab-04-backup. Localizando os eventos no CloudWatch Logs Insights e correlacionando o backupJobId/restoreJobId do evento com o job do Console, fecha-se a prova de ponta a ponta. É o mesmo padrão do Projeto 01 (failover do RDS) e do Projeto 03 (DynamoDB); muda apenas o source/detail-type.
Resultado
- Réplica na segunda região ativa e validada por operação real (leitura/escrita cruzada), não apenas por status.
- Replicação bidirecional comprovada nos dois sentidos, demonstrando Multi-Region e Multi-Active.
- ReplicationLatency medida no CloudWatch, na casa de centenas de ms a ~1s.
- Ciclo completo de AWS Backup executado, com dados restaurados validados contra os itens conhecidos e a origem intacta.
- Eventos de Backup/Restore localizados no Log Group /aws/events/db-lab-04-backup, correlacionados aos jobs do Console.
- Ao final, a limpeza da série inteira documentada (Tarefa 48) para zerar o custo (Req. 12.2/12.3).
O que aprendi
- Multi-Region não é o mesmo que Multi-AZ nem que Read Replica. Multi-AZ (RDS, Projeto 01) e réplicas de leitura resolvem disponibilidade e escala dentro de uma região; Global Tables resolve entre regiões, e ainda por cima com escrita em todas as réplicas (multi-active).
- Consistência eventual entre regiões é o preço da replicação assíncrona. Para o carrinho (um usuário por vez) o last writer wins é aceitável; com escrita concorrente do mesmo item em regiões diferentes, é preciso desenhar o modelo pensando nisso.
- Backup gerenciado ≠ PITR. AWS Backup entrega Recovery Points discretos, cofre centralizado, retenção por política e auditoria (ideal para governança/compliance e retenção longa entre múltiplos serviços). PITR entrega backup contínuo com RPO de segundos, dentro da região. Os dois se complementam; a escolha depende do RPO/RTO e da necessidade de auditoria.
- RTO/RPO na prática. O RPO do AWS Backup é limitado pela frequência do plano (backup diário ⇒ RPO de até ~24h); o PITR chega a segundos. O RTO de ambos depende do tempo de restore mais o redirecionamento da aplicação para a nova tabela.
- Um backup só é confiável depois de restaurado. Por isso o ciclo obrigatório BACKUP → VALIDAR → RESTORE → VALIDAR DADOS: um backup que nunca foi testado é uma promessa, não uma garantia.
Conclusão
O Projeto 04 fecha a série levando o dado a um patamar de resiliência multi-região e backup gerenciado auditável, mantendo intactas a aplicação, a EC2, o S3, o relacional e o DNS. Mais do que criar recursos, o laboratório reforçou o hábito de comprovar (leitura cruzada real, ciclo completo de restore, eventos correlacionados) e de encerrar com responsabilidade de custo — a limpeza final consolidada na Tarefa 48. Da EC2 monolítica do Projeto 01 até as Global Tables com AWS Backup, a jornada foi sempre a mesma: um problema real justifica cada serviço, e cada serviço é comprovado antes de ser dado como pronto.
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article