
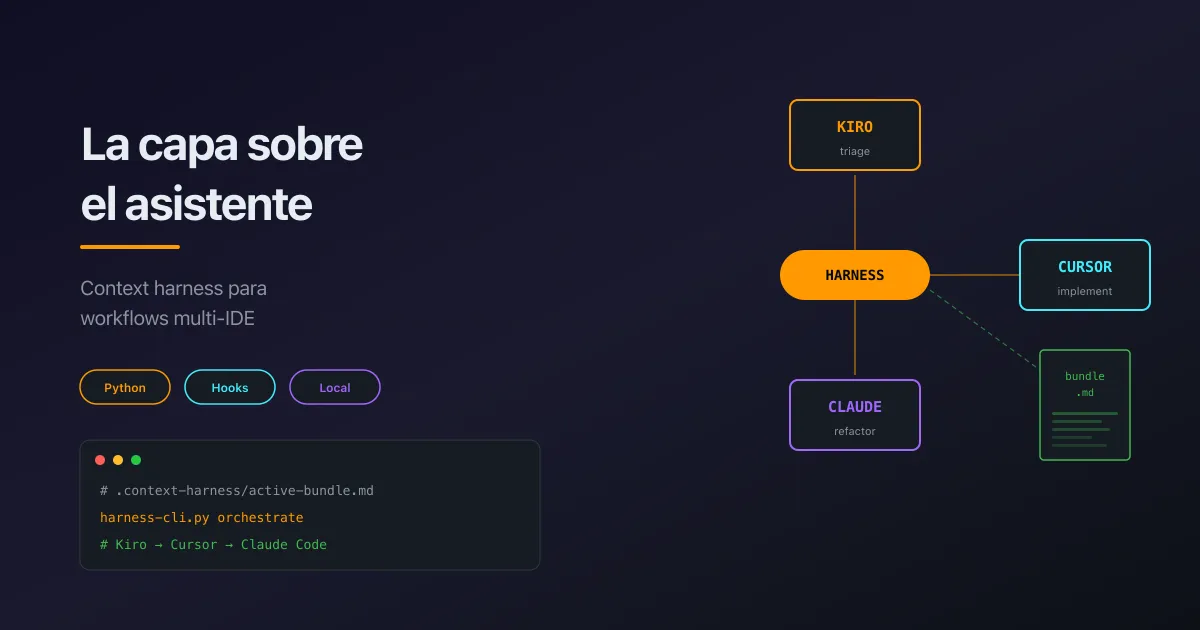
La capa sobre el asistente: por qué tu contexto muere entre IDEs y cómo construir el puente
El problema de los workflows multi-IDE no es la calidad del modelo, es que cada sesión empieza desde cero
Tienes tres asistentes de IA en tu flujo de trabajo. Kiro para triage y razonamiento sobre el codebase, Cursor para implementación rápida, y Claude Code para sesiones largas de refactor donde necesitas un modelo con ventana de contexto grande. Cada uno hace bien su parte.
El problema está en el medio.
Kiro encuentra el bug, analiza el stack trace, entiende el contexto. Cambias a Cursor o a Claude Code, pegas el stack trace de nuevo, explicas el contexto de nuevo, y tres mensajes después el segundo asistente tiene suficiente para empezar. Duplicaste el trabajo, quemaste tokens, y si el proyecto tiene código propietario lo enviaste a APIs cloud distintas sin necesidad.
Este artículo explica qué patrón resuelve eso y cómo implementarlo, ya sea construyendo tu propio harness desde cero o usando uno existente como punto de partida.
El costo real de empezar desde cero
Haz la cuenta. Tres prompts de contexto por sesión, dos cambios de IDE por bug, un equipo de cuatro personas. Son tokens quemados en repetir lo que ya se dijo, y minutos perdidos esperando que el segundo asistente "entienda" lo que el primero ya resolvió.
La solución no es reemplazar ninguno de los tres. Es construir un puente que pase el contexto de uno a otro.
Qué es un context harness
Un script que se sienta entre tus IDEs y les pasa el contexto que acumulaste en el otro. Lee error logs, diffs y archivos que tú configuras por globs, filtra lo relevante para la tarea actual, y lo deja en
.context-harness/active-bundle.md para que cualquier IDE lo lea directo.
Sin servidor central, sin base de datos, sin cuenta externa. Solo archivos en tu repo.
Veamos cada pieza.
Cómo funciona por dentro: las tres piezas
1. Colección de contexto ( collect.py )
¿Qué incluir en el bundle? Si metes todo el codebase, es ruidoso. Si metes poco, le falta contexto al asistente. La solución: configuración por proyecto.
Python
# .context-harness/config.json{"orchestrator": "mock","context_sources": {"error_logs": ["logs/error.log", "logs/app.log"],"source_files": ["src/**/*.py", "src/**/*.ts"],"recent_diffs": true,"max_files": 10}}
El colector lee los archivos que matchean los globs, el diff reciente y los logs:
Python
# src/shared/collect.pydef collect_context(config: dict) -> dict:context = {}for log_path in config.get("error_logs", []):if os.path.exists(log_path):context["errors"] = read_recent_lines(log_path, n=50)if config.get("recent_diffs", True):context["diff"] = run_command("git diff HEAD~1 --stat")context["files"] = collect_files_by_glob(config.get("source_files", []))return context
Python leyendo archivos y corriendo
git diff . Vive en tu repo y lo ajustas cuando el proyecto lo necesite.2. Orquestación ( orchestrator.py )
El orquestador toma el contexto crudo y lo reduce a lo relevante para el prompt. Tiene tres implementaciones con la misma interfaz:
Python
# src/shared/orchestrator.pyclass Orchestrator:def orchestrate(self, prompt: str, context: dict) -> dict:raise NotImplementedErrorclass MockOrchestrator(Orchestrator):"""Reglas determinísticas. Zero dependencias. Instantáneo."""def orchestrate(self, prompt: str, context: dict) -> dict:agent = self._route_by_keywords(prompt)bundle = self._filter_context(prompt, context)return {"agent": agent, "bundle": bundle, "latency_ms": 0}class OllamaOrchestrator(Orchestrator):"""LLM local. El código nunca sale de tu máquina."""def orchestrate(self, prompt: str, context: dict) -> dict:response = requests.post("http://localhost:11434/api/generate", json={"model": "llama3.2","prompt": build_orchestration_prompt(prompt, context),"stream": False})return parse_orchestration_response(response.json())class BedrockOrchestrator(Orchestrator):"""Cloud. Para equipos que quieren API compartida."""def orchestrate(self, prompt: str, context: dict) -> dict:client = boto3.client("bedrock-runtime")response = client.invoke_model(modelId="amazon.nova-lite-v1:0",body=json.dumps({"prompt": build_orchestration_prompt(prompt, context)}))return parse_orchestration_response(response)
Lo importante: cambias el orquestador en
config.json y el resto del sistema no se entera. El mismo patrón que en ORMs o drivers de bases de datos.Python
def get_orchestrator(config: dict) -> Orchestrator:mode = config.get("orchestrator", "mock")if mode == "ollama":return OllamaOrchestrator()elif mode == "bedrock":return BedrockOrchestrator()return MockOrchestrator()
3. Los hooks: el punto de integración con los IDEs
Los hooks son la pieza que conecta el harness con Kiro, Cursor y Claude Code. Cuando escribes
/harness en el chat del IDE, el hook intercepta el prompt, corre la orquestación, y el asistente recibe el contexto reducido antes de procesar tu mensaje.Kiro usa un hook de tipo
promptSubmit :JSON
// .kiro/hooks/context-harness.json{"name": "context-harness-orchestrate","version": "1.0.0","when": {"type": "promptSubmit"},"then": {"type": "runCommand","command": "bash integrations/hooks/kiro-orchestrate.sh"}}
El script del hook captura el prompt, corre
harness-cli.py orchestrate , y escribe el bundle orquestado. Kiro lo recibe como contexto adicional al prompt original vía stdout.Cursor usa un hook de
sessionStart combinado con una rule:JSON
// .cursor/hooks.json{"sessionStart": {"command": "python3 scripts/harness-cli.py init --assistant cursor"}}
Markdown
// .cursor/rules/context-harness.mdcAntes de responder cualquier prompt que contenga `/harness`,lee el archivo `.context-harness/active-bundle.md`.Ese bundle contiene el contexto reducido y el handoff de la sesión anterior.
Cursor no puede inyectar texto en el prompt directamente como lo hace Kiro, esa es una limitación real de la API de Cursor. El workaround es file-based: el bundle se escribe a disco y la rule le dice al agente que lo lea. Funciona, aunque es un paso más indirecto.
Claude Code usa un archivo
CLAUDE.md en la raíz del repo como steering document, combinado con un comando slash personalizado:Markdown
<!-- CLAUDE.md — Claude Code lo lee automáticamente al inicio de cada sesión -->## Context HarnessEste proyecto usa Context Harness para compartir contexto entre IDEs.Antes de responder cualquier prompt que contenga `/harness`,lee `.context-harness/active-bundle.md`.Ese archivo contiene el contexto reducido y el handoff de la sesión anterior.
Bash
# .claude/commands/harness.md — define el comando /harness en Claude CodeCorre: python3 scripts/harness-cli.py orchestrate --assistant claude-code --prompt "$ARGUMENTS"Luego lee `.context-harness/active-bundle.md` y úsalo como contexto para tu respuesta.
Claude Code tiene una ventaja sobre Cursor en este aspecto:
CLAUDE.md se carga automáticamente en cada sesión sin configuración adicional, así que el harness se convierte en parte del contexto base del proyecto desde el primer mensaje.Ahora que sabes cómo cada IDE consume el bundle, hablemos de cuándo usar cada orquestador.
Cuándo usar cada orquestador
Orquestador | Cómo funciona | Cuándo usarlo |
|---|---|---|
mock | Reglas de keywords + filtrado por globs | Empezar, CI, proyectos sin reqs de privacidad |
ollama | LLM en localhost, sin salida de red | Codebases propietarios |
bedrock | LLM en cloud vía AWS | Equipos con API compartida |
Reducción de ~44-67% por filtrado de globs, sin LLM, sin latencia. Para muchos proyectos es suficiente.
Ollama
Bash
ollama pull llama3.2# config.json → "orchestrator": "ollama"python3 scripts/harness-cli.py doctor
El prompt de orquestación nunca sale de tu máquina. La reducción sube a ~96% a cambio de ~7 segundos de latencia. Y si Ollama no está corriendo, cae a mock sin romper nada:
Python
# Fallback automático en orchestrator.pytry:return self._call_ollama(prompt, context)except requests.exceptions.ConnectionError:return MockOrchestrator().orchestrate(prompt, context)
Bedrock
CDK deploy con Nova Lite como modelo por defecto. Útil cuando el equipo necesita una API compartida y la latencia cloud (~1-2s) es aceptable.
El handoff en la práctica: Kiro → Cursor → Claude Code

Secuencia real del desarrollo del harness en
demo-app/UserList.tsx :En Kiro — triage:
Plain text
/harness debug the crash in demo-app/UserList.tsx — API now returns { items: [] }
El hook intercepta el prompt.
harness-cli.py corre con el orquestador configurado. Resultado en .context-harness/session.json :JSON
{"sessionId": "sess-001","assistantsUsed": ["kiro"],"contextReductionPct": 96,"recommendedAgent": "debugger","handoffMessage": "Kiro analizó el error. El problema está en UserList.tsx línea 34: API cambió de array a objeto con key 'items'."}
En
.context-harness/active-bundle.md queda solo el error, el diff relevante y el fragmento del archivo con el bug.En Cursor — implementación rápida:
Plain text
/harness fix demo-app/UserList.tsx using the orchestrated bundle — use data?.items
Cursor lee
active-bundle.md y sabe que Kiro ya ingresó el contexto, así que implementa el fix sin re-paste del stack trace.En Claude Code — si el fix requiere refactor más amplio:
Plain text
/harness review the fix and refactor UserList.tsx for consistency with the rest of the data layer
Claude Code lee
active-bundle.md via CLAUDE.md , ve lo que Kiro diagnosticó y Cursor implementó, y continúa desde ahí.JSON
{"assistantsUsed": ["kiro", "cursor", "claude-code"]}
Tres IDEs, una sesión de contexto continua.
Un bug real que encontramos en el proceso
El hook de Kiro original hacía
cat en stdin para capturar el prompt:Bash
# ❌ Esto cuelga el procesoPROMPT=$(cat)
El problema: en zsh,
cat sin argumento espera input interactivo del tty. El hook se quedaba colgado indefinidamente. El fix fue usar read con timeout:Bash
# ✅ Portable, no bloqueaPROMPT=""while IFS= read -r -t 1 line; doPROMPT="$PROMPT$line\n"done
Lo mencionamos porque es el tipo de detalle que no aparece en los tutoriales pero sí aparece cuando usas las cosas de verdad.
Construirlo tú mismo vs usar el repo de referencia
Opción A: desde cero
Si quieres control total o adaptar el harness a tu caso de uso, la estructura mínima es:
Plain text
tu-proyecto/└── .context-harness/├── config.json # globs, orquestador├── session.json # estado entre sesiones└── active-bundle.md # el bundle que los IDEs leensrc/shared/├── collect.py # colección de contexto├── config.py # lectura de config└── orchestrator.py # mock / ollama / bedrockscripts/└── harness-cli.py # CLI: init, orchestrate, handoff, doctorintegrations/hooks/├── kiro-orchestrate.sh # hook de Kiro├── cursor-refresh.py # refresh de bundle para Cursor└── claude-code.md # CLAUDE.md steering + comando /harness
El módulo más importante para empezar es
orchestrator.py . Ahí defines la interfaz base y la implementación mock, y con eso ya tienes un harness funcional. Ollama y Bedrock los agregas cuando los necesites.Opción B: instalar el repo de referencia
Bash
git clone https://github.com/hsaenzG/The-Layer-Above-the-Assistant.gitbash The-Layer-Above-the-Assistant/scripts/install-harness.sh .
Crea la estructura, instala los hooks para los tres IDEs y genera un
config.json con defaults razonables.Bash
python3 scripts/harness-cli.py doctor# ✅ config.json found# ✅ Kiro hook installed# ✅ Cursor rule installed# ✅ CLAUDE.md steering installed# ⚠️ Ollama not running (using mock fallback)
La diferencia entre ambas opciones es cuánto tiempo quieres invertir en el andamiaje versus en los conceptos.
Límites honestos
No es full air-gap. El harness orquesta con Ollama en local, pero los IDEs siguen usando sus modelos cloud para la generación. Si necesitas que toda la inferencia sea local, esto no alcanza por sí solo.
Repos vacíos no tienen mucho que orquestar: El patrón brilla con error logs reales, diffs recientes y archivos con historia. En un repo nuevo la reducción de contexto no aporta gran cosa.
La inyección de contexto es asimétrica entre IDEs: Kiro inyecta directamente en el prompt vía stdout. Cursor lo hace via rule que lee un archivo, y Claude Code via
CLAUDE.md . Los tres funcionan, pero con diferente grado de integración.La latencia de Ollama (~7s) puede molestar: Para respuestas rápidas, mock es suficiente. Ollama compensa cuando la privacidad del código pesa más que la velocidad.
Lo que quiero que te lleves: el cuello de botella en un workflow multi-IDE no es el modelo, es la amnesia entre sesiones. Un archivo
.md en tu repo, un par de hooks y un orquestador que puede ser tan simple como un filtro de keywords resuelven eso sin instalar nada fuera de tu máquina.Si ya usas más de un IDE en tu flujo de trabajo, pruébalo en un bug real. Un solo handoff exitoso te va a convencer más que todo este artículo.
"Kiro triage. Cursor o Claude Code implementa. El harness recuerda, localmente si quieres."
¿Cómo manejas el handoff de contexto entre IDEs hoy? ¿Pegas el prompt completo, usas archivos compartidos, o simplemente empiezas de cero cada vez? Los comentarios están abiertos.
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article