
FinOps na prática: otimizando pipelines de dados na AWS
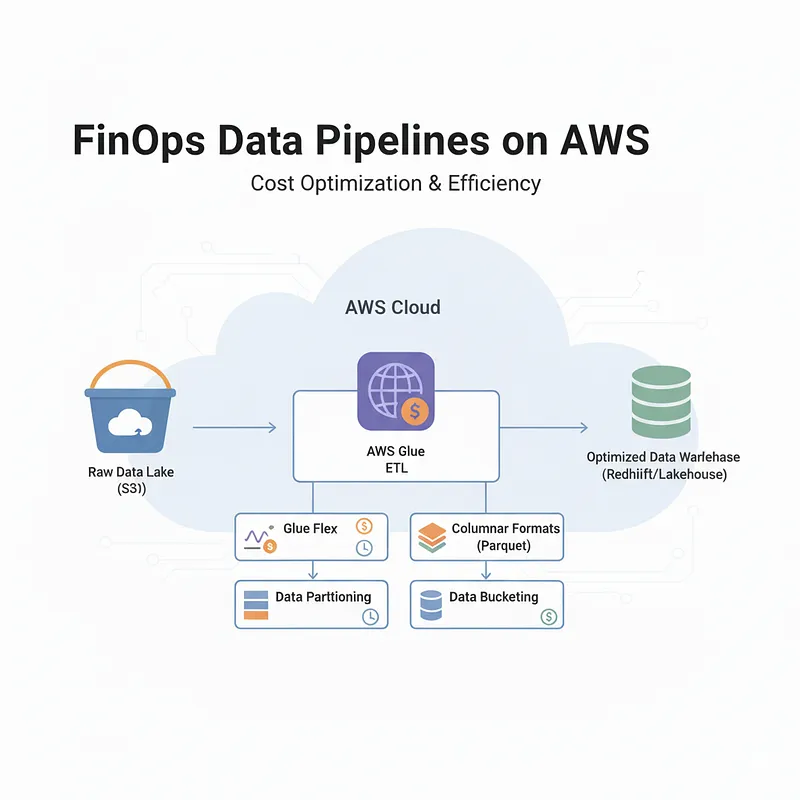
Este artigo compartilha práticas de FinOps aplicadas em engenharia de dados na AWS para reduzir custos e melhorar a eficiência operacional das pipelines de dados. São apresentadas ações simples, como otimizações no Glue, S3 e no formato dos dados, que geram ganhos relevantes sem exigir mudanças complexas na arquitetura.
Nos últimos meses tenho trabalhado bastante com FinOps no contexto de engenharia de dados na AWS. Durante esse período, tive algumas práticas em conjunto do time que ajudaram a reduzir custos sem complicar a arquitetura. Resolvi escrever este artigo para compartilhar essas experiências de forma prática.
São pequenas ações que, somadas, fazem diferença no custo e na eficiência das pipelines.
Glue Flex em ambientes de desenvolvimento e homologação
Uma das ações que pode fazer diferença é usar Glue Flex para jobs de DEV e HOMOL ou pipelines não críticas.
Essa classe permite rodar jobs em capacidade ociosa da AWS, com custo menor, e funciona bem quando a latência não é crítica. Em produção, para jobs com SLA rigoroso vale manter a execução padrão.
Essa classe permite rodar jobs em capacidade ociosa da AWS, com custo menor, e funciona bem quando a latência não é crítica. Em produção, para jobs com SLA rigoroso vale manter a execução padrão.
O ganho vem sem precisar mudar a lógica do pipeline, apenas alterando o tipo de execução.
Link: AWS Glue Flex Jobs
Atualização para Glue 5.0
Migrar para Glue 5.0 também traz melhorias de performance e redução de custo. A versão roda Spark 3.5 e Python 3.11, com otimizações que reduzem o tempo de execução e o consumo de DPUs.
Além disso, a atualização melhora compatibilidade com formatos modernos de dados como Iceberg, Hudi e Delta.
Além disso, a atualização melhora compatibilidade com formatos modernos de dados como Iceberg, Hudi e Delta.
Link: AWS Glue 5.0
Combate a small files
Small Files no S3 acaba sendo um problema frequente. Eles aumentam o número de requisições GET, tornam leituras mais lentas e aumentando o custo de getObject das nossas consultas. O custo pode ficar elevado também pelo KMS, que precisa decriptar um volume maior de arquivos.
Para reduzir o impacto:
- Reagrupamos os arquivos históricos usando
.repartition()e.coalesce(). - Para novas ingestões, ajustamos a escrita para manter arquivos entre 128 e 256 MB.
O resultado foi menos overhead no Glue e mais eficiência nas consultas.
Formatos e layout de dados: Parquet, Partitioning e Bucketing
Parquet
Para reduzir custo de processamento e leitura, sempre garantir a escrita dos dados em Parquet com compressão Snappy. O formato colunar reduz I/O e acelera consultas, trazendo ganhos de custo e performance.
Particionamento
Particionei os dados com base em filtros de uso real, como
ano, mes e dia. Isso reduz o volume lido nas consultas e acelera execuções. Importante garantir que os filtros sejam feitos principalmente nos campos particionados.Link: Data Partitioning
Bucketing
Em tabelas que sofrem muitos joins, usar bucketing por colunas de alta cardinalidade. Isso diminui shuffle no Spark e acelera joins complexos.
Link: Bucketing with Glue and Athena
Link: Bucketing with Glue and Athena
Ciclo de vida no S3
Configurar o ciclo de vida dos objetos no S3 gera impacto direto no custo:
- Dados acessados com frequência ficam em Standard.
- Após um período, mover para Standard‑IA.
- Dados antigos ou sem valor, como logs obsoletos, foram programados para exclusão automática.
Link: S3 Lifecycle
Ajuste de frequência de execução
Nem todos os dados precisam ser processados em tempo real ou com alta frequência. Otimizar a quantidade de execuções ajuda a reduzir custos desnecessários e mantém as pipelines alinhadas à necessidade do negócio.
Conclusão
Mesmo ajustes pequenos podem impactar o custo na cloud. Ações como Glue Flex em DEV/HOMOL, atualização para Glue 5.0, combate a small files, gravar os dados em Parquet, aplicar políticas de ciclo de vida no S3 e ajustar a frequência de execução ajudam a reduzir custos e aumentar eficiência.
O mais importante é desenvolver a disciplina de pensar no custo sempre que projetar uma pipeline.
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article