
Contexto y memoria en agentes de IA: por qué olvidan y cómo hacer que recuerden
Descubre por qué los agentes de IA olvidan cosas entre sesiones, qué es la ventana de contexto y cómo darles memoria a corto y largo plazo con ejemplos en Python.
Te ha pasado que cuando trabajas con un agente de IA y cambias entre chats tienes que volver a explicarle cosas que ya habías explicado en otro chat. Personalmente a mi me ha llegado a parecer frustrante, muchas veces dije "oye ya te había explicado eso", y es una de esas cosas que confunden al inicio porque uno esperaría que algo tan "inteligente" (o al menos así es como venden a la IA) al menos hiciera eso que es tan natural para nosotros los humanos.
Para entender por qué pasa esto y cómo encontrar una solución, tenemos que hablar de dos conceptos que suelen mezclarse, el contexto y la memoria. Antes de entrar a profundidad me gustaría mencionar que un modelo de IA , muy en el fondo no es más que un programa que predice texto basándose en patrones, y un agente es ese mismo modelo, conectado a herramientas para que pueda actuar y resolver tareas. Hoy te voy a mostrar qué es el contexto, por qué un agente olvida, y cómo darle memoria.
1. El contexto, el espacio de trabajo de un agente
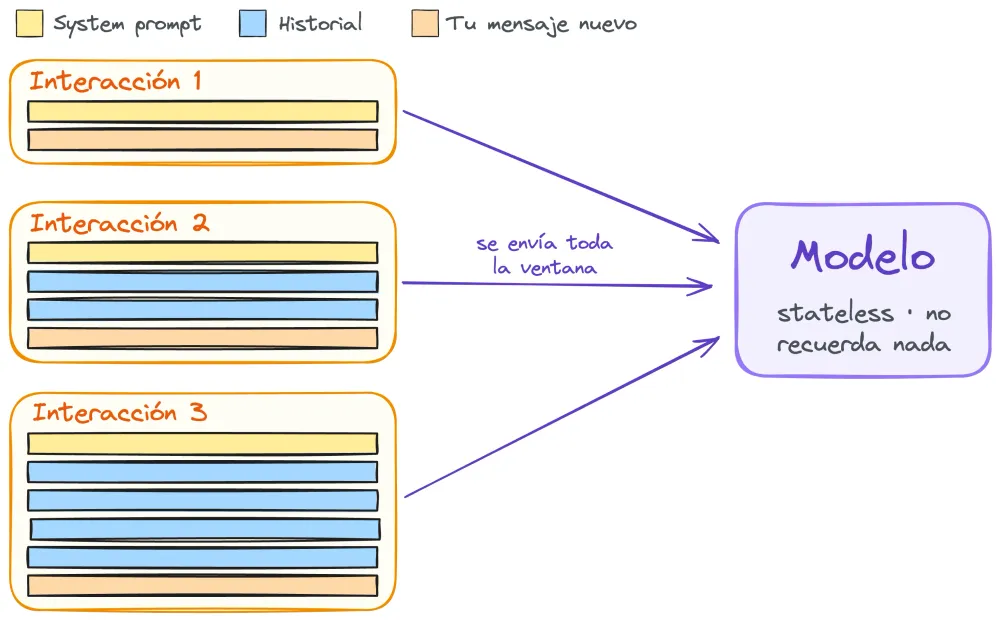
Cuando le hablas a un modelo, todo lo que "ve" o "recuerda" en ese momento lo toma de algo llamado ventana de contexto, y la manera más fácil de pensarla es como su espacio de trabajo, parecido a esa memoria a corto plazo que usas tú cuando alguien te dicta un número de teléfono y lo vas repitiendo en voz alta hasta que logras marcarlo. Dentro de esa ventana está todo lo que el modelo necesita para razonar en este instante, desde el system prompt que define cómo debe comportarse, tus mensajes, las respuestas anteriores de la conversación y los resultados de las herramientas que haya usado.
Y aquí está la idea más importante de todo el artículo, así que quiero que te quedes con ella. El modelo es lo que en inglés se llama stateless, o sin estado, lo que significa que no guarda absolutamente nada entre una pregunta y otra, cada vez que lo llamas es como si fuera la primera vez que te escucha. Entonces, ¿cómo es que parece que sigue el hilo de la conversación? Pues porque en cada interacción, el agente le vuelve a enviar toda la ventana de contexto completa, el system prompt, el historial entero, los resultados de las herramientas, tu mensaje nuevo y el modelo lee todo eso. Es por eso que pensamos que el modelo está recordando cosas, cuando en realidad le reenviamos el historial una y otra vez.

Y si algo no está dentro de esa ventana, para el modelo simplemente no existe, por eso lo que decides incluir en ella importa tanto, una idea a la que vamos a volver más adelante.
2. Por qué la ventana de contexto se queda corta
Si todo vive en el contexto, lo lógico sería meter ahí todo lo que el agente pueda llegar a necesitar y dejarlo para siempre, pero el problema es que la ventana de contexto es finita, y se mide en tokens.
¿Y qué es un token? Es una de las piezas pequeñas en las que el modelo parte el texto antes de procesarlo. No siempre es una palabra completa, porque una palabra común como "casa" puede ser un solo token, mientras que una más larga o más rara se parte en varios pedazos, y hasta los espacios y los signos de puntuación cuentan. El modelo lo hace así porque no lee letras como nosotros, sino números, así que primero convierte tu texto en estas piezas para poder operar con ellas.

Y como cada modelo solo puede manejar un número máximo de tokens a la vez, esa ventana tiene un tope que no puedes pasar.
Una conversación corta cabe sin problema, pero una conversación larga, o una tarea compleja donde el agente va leyendo archivos, ejecutando herramientas y acumulando resultados, empieza a llenar esa ventana mucho más rápido de lo que uno cree. Y acuérdate que, en cada interacción que tienes con el modelo se reenvía la ventana completa, así que mientras más larga sea la conversación más tokens mandas en cada una de tus preguntas.
¿Y qué pasa cuando se llena? Pues empieza a perderse lo más viejo para hacerle espacio a lo nuevo, sube el costo porque pagas por token procesado y estás mandando cada vez más texto, y también sube la latencia porque procesar más tokens toma más tiempo. Y aquí conviene separar bien dos cosas que es fácil confundir. El contexto es el espacio finito que el modelo ve en cada interacción, mientras que la memoria es la información que el agente conserva, y esa memoria puede vivir dentro del contexto, que sería la de corto plazo, o fuera de él, que sería la de largo plazo.

3. Memoria a corto plazo, recordar dentro de la conversación
La memoria a corto plazo es la que mantiene viva la conversación que tienes ahorita, y es lo que te permite pedirle a un agente "créame una función que valide correos" y luego decirle "ahora agrégale unas pruebas" sin tener que recordarle de qué función estás hablando. La buena noticia es que esto casi no lo tienes que programar tú, porque los frameworks de agentes ya lo manejan por defecto.
4. Memoria a largo plazo, recordar entre sesiones
Ahora ya podemos explicar por qué cuando nos movemos entre chats el agente "olvida" cosas. Lo que sucede es que cuando cierras el programa y lo vuelves a abrir se crea un agente completamente nuevo, con el historial vacío, y toda esa conversación anterior que estaba en la memoria temporal del contexto se va cuando cierras el proceso.
La memoria a largo plazo existe precisamente para resolver esto, y la idea es persistir la información fuera del modelo, como una base de datos o un servicio de almacenamiento, para después volver a cargarla cuando el agente arranca de nuevo.
5. Gestión del contexto, qué meter en una ventana limitada
Ya quedamos en que el contexto es finito, así que cuando una conversación crece surge una pregunta que vale oro, ¿qué conservas y qué dejas ir? A esto se le llama gestión del contexto, y es una decisión de diseño mucho más importante de lo que parece, porque un contexto lleno de cosas que ya no importan no solo te cuesta más caro, también le quita enfoque al modelo y lo hace responder peor.
Existen dos estrategias muy comunes para esto, y la mayoría de los frameworks de agentes ya las traen listas para que no tengas que implementarlas a mano. La primera es Sliding Window, que es la opción por defecto, y lo que hace es mantener los mensajes más recientes e ir descartando los más viejos cuando se llena, algo simple y suficiente para la mayoría de las conversaciones. La segunda es el resumen, que en lugar de tirar los mensajes viejos los condensa en un resumen y conserva ese resumen, de modo que el agente no pierde del todo lo que pasó al inicio pero ocupa mucho menos espacio.

Como el espacio es limitado lo que metes importa bastante, así que solo conserva lo relevante, resume o suelta lo que ya no aporta, y evita llenar la ventana de información innecesaria.
6. Manos a la obra, dale memoria a un agente
Todo suena bonito en la teoría pero ¿qué tal en la práctica? Voy a usar un SDK para crear agentes llamado Strands Agents . Por defecto strands utiliza Amazon Bedrock , si quieres seguirme tendrás que iniciar sesión en la cli usando aws login . Vamos a crear un agente muy simple con estas pocas líneas de código y en el primer intento no vamos a poner nada de memoria. Le diré mi nombre y le pediré que lo recuerde, a ver qué pasa.
1
2
3
4
from strands import Agent

agent = Agent()
agent("Me llamo Ramsés, recuérdalo")
Ahora vuelvo a correr el programa, y le preguntaré por mi nombre.
1
2
3
4
from strands import Agent

agent = Agent()
agent("¿Cómo me llamo?")
Obviamente no tiene idea de quién soy y no porque le pedí que lo recuerde lo va a hacer, y ya sabemos por qué. En cada ejecución arranca un agente nuevo con la memoria en blanco. Ahora vamos a agregarle un session manager, y lo voy a usar desde el momento en que le digo mi nombre, para que lo guarde en esa sesión.
1
2
3
4
5
6
7
from strands import Agent
from strands.session.file_session_manager import FileSessionManager

session_manager = FileSessionManager(session_id="ramses", storage_dir="./sesiones")
agent = Agent(session_manager=session_manager)

agent("Me llamo Ramsés, recuérdalo")
Vuelvo a correr el programa usando el mismo
session_id, y le pregunto mi nombre.1
2
3
4
5
6
7
from strands import Agent
from strands.session.file_session_manager import FileSessionManager
session_manager = FileSessionManager(session_id="ramses", storage_dir="./sesiones")
agent = Agent(session_manager=session_manager)
agent("¿Cómo me llamo?") # "Te llamas Ramsés"
Esta vez, aunque sea un proceso totalmente nuevo, el agente recupera la sesión que se guardó antes y recuerda mi nombre. Y lo que me gusta es que lo hicimos en una línea de código, el resto sigue casi igual. Esto es en lo que nos ayudan las herramientas para construir agentes y hacen que los tiempos de desarrollo se reduzcan.
Preguntas frecuentes
¿El modelo recuerda mis mensajes anteriores?
No, el modelo es stateless y no recuerda nada por sí mismo, quien le reenvía todo el historial en cada interacción es el agente o el framework que estás usando. Por eso, si ese historial no se guarda en ningún lado, al reiniciar el programa se pierde por completo.
¿Contexto y memoria son lo mismo?
No. El contexto es el espacio finito que el modelo ve y sobre el que razona en cada interacción, mientras que la memoria es la información que el agente conserva y cómo la conserva, y viene en dos tipos, la de corto plazo que vive dentro del contexto mientras dura la conversación, y la de largo plazo que se guarda fuera y se vuelve a cargar al contexto cuando hace falta.
¿Una ventana de contexto más grande reemplaza a la memoria?
No del todo, porque aunque una ventana más grande te deja conservar más historial a la vez, sigue siendo finita, te cuesta más por token y de todas formas no sobrevive a un reinicio. La memoria a largo plazo resuelve un problema distinto, que es persistir la información fuera del modelo para que no se pierda.
¿Dónde se guarda la memoria a largo plazo?
En cualquier almacenamiento que sobreviva al reinicio del programa, ya sea un archivo local, Amazon S3 o una base de datos, y muchos frameworks de agentes ya te dan esta persistencia lista, así que no tienes que implementarla desde cero.
¿Esto funciona con cualquier modelo?
Sí, porque el contexto y la memoria se manejan a nivel del agente y del framework, no del modelo, así que da igual si usas un modelo local con Ollama o uno en la nube con Amazon Bedrock , el patrón termina siendo el mismo.
Conclusión
Recapitulemos lo que aprendimos:
- El contexto es el espacio de trabajo del modelo, lo que "ve" para razonar ahora mismo, y es efímero y limitado
- Los agentes "olvidan" porque por defecto solo existe lo que cabe en la ventana de contexto, y esa ventana desaparece al reiniciar
- La memoria a corto plazo vive dentro del contexto y mantiene viva la conversación actual
- La memoria a largo plazo se persiste por fuera, en un archivo, en S3 o en una base de datos, y le da continuidad al agente entre sesiones
- En una ventana finita lo que eliges incluir es una decisión de diseño, así que conserva lo relevante y resume o suelta lo demás
Si te interesa este tipo de contenido y eres más de videos síguenos en nuestro canal de YouTube AWS Developers LATAM , te estaremos esperando por allá.
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article