
AgentCore Runtime V2でStrands Decider 2Bの作成が失敗した原因は、Graviton2のbf16だった
判定専用の小さなモデルStrands Decider 2Bを、AgentCore RuntimeのV1とV2に同じコンテナで載せ、東京リージョンでコールドスタートを比べました。V2は作成時にbf16命令を持たないCPUでも起動処理を走らせるため作成に失敗し、V1はモデルをS3に置くことで安定して動いた、その過程と対策を紹介します。
1. はじめに
こんにちは!松延(まつのぶ) です!
2026年10月1日、AWSのStrands Labsから判定専用の小さなオープンソースモデル「Strands Decider 2B」が公開されました 。文章は生成せず、あらかじめ渡した選択肢から1つを選ぶ、Yes/Noの確率を返す、段階で評価する、の3つの形式だけで答えるモデルです。「この問い合わせはどの窓口に回すか」「このツールを今呼んでよいか」といった、エージェントの中にある細かな判断を、大きなLLMを使わずに済ませられるのが特徴です。
その少し前の2026年9月18日には、Amazon Bedrock AgentCore Runtimeの新しいプラットフォームバージョン(V2)が一般提供(GA)されました 。エージェントの起動時の処理を一度だけ行い、その状態をスナップショットとして保存し、新しいセッションはそこから復元して始める方式です。AWSの測定では、200MB〜2GBのコンテナイメージで、コールドスタートがP75で1.9〜2.0秒(従来のV1では5.4〜30秒)とされています。
この2つを組み合わせたいと考えたのには理由があります。Deciderは小さなモデルとはいえ、ベースモデルの重み(学習で得られたパラメータ。モデル本体のデータ)だけで約4.5GBあります。この記事では、重みに設定ファイルやトークナイザー(文章を数値に変換するための辞書)を加えたファイル一式を、「モデルのファイル」と呼びます。モデルのファイルは、Amazon Bedrock AgentCore(以下、AgentCore)のRuntimeのイメージの上限(2GB)には収まらないため、起動のたびに取得して、重みをメモリに読み込む必要があります。V1では、この重い処理が新しいセッションが始まるたびに走ることになるはずです。
V2の仕組みどおりなら、モデルのファイルの取得や重みの読み込みも含めて、起動時の処理はスナップショットに入るはずです。では、本当に新しいセッションの立ち上がりは数秒まで縮むのか。「設定を1つ変えるだけで、起動の重い自前モデルがどこまで速くなるのか」を、実際に測ってみることにしました。
今回は、同じコンテナをV1とV2の2つのランタイムに載せて、東京リージョンでコールドスタートを比べた結果をシェアしていきたいと思います。
先に結論を書くと、V2では、Deciderのランタイムを作ることができませんでした。その原因を追いかけるうちに、「V2は作成時に、Graviton2とGraviton3という世代の違うCPUのそれぞれで、並行して起動処理を走らせている(おそらく、復元時の互換性のため)」こと、そして「microVMには、bf16の命令を持たない旧世代のGraviton2が、一定の割合(今回は約6台に1台)で混ざっている」という、公式ドキュメントには書かれていないサーバーレスの裏側の挙動が見えてきました。期待どおりの結果ではありませんでしたが、AgentCore Runtimeに自前のモデルを載せるときに知っておきたいことが詰まった検証になったので、その過程も含めて紹介します。
注意:本記事の内容は筆者個人の見解であり、所属する組織およびAWSの公式な見解を示すものではありません。検証は、筆者個人のAWSアカウントで行っています。
対象読者とこの記事でわかること
本記事は、次のような方を対象としています。
- AgentCore Runtimeに、LLM以外の自前のモデルを載せることを検討している方
- V2に切り替えると何が変わるのかを、具体的な例で知りたい方
- Strands DeciderをAWS上で使う方法を検討している方
そして、この記事を読み終えると、次のことがわかります。
- V2で、bf16のモデルのランタイムの作成が失敗する理由(種類の違うCPUで起動処理が走ること)と、その確かめ方
- V1の新しいセッションの立ち上がりの実際(待機中のmicroVM、同時に呼び出したときの挙動)
- モデルのファイルをS3に置いて、インターネットに出ないVPCの中でエージェントを動かす構成と、その効果
先行記事と、この記事の位置づけ
AgentCore RuntimeのmicroVMでDeciderを動かす記事は、AWS Builder Centerですでに公開されています。この記事は、次の2本の内容を土台にしています。
| 記事 | 内容(筆者の要約) |
|---|---|
| Running Strands Decider 2B on Amazon Bedrock AgentCore: microVMs vs GPU Instances (Akshay_Bさん、eu-west-1) | microVM、GPUのRuntime instances、Amazon SageMaker AIなど、複数の環境で速度とコストを比較。microVMでは、fp32への変換を1層ずつ行い、埋め込みの表だけbf16のまま残すことで8GBに収めている。新しいセッションが速く応答したことから、起動済みのmicroVMが使われていると推測している |
| Serving Strands Decider on Amazon Bedrock AgentCore Runtime (Vivek Raja P Sさん、us-east-1) | AgentCore CLIでのデプロイ手順。線形の層をint8に量子化して、8GBのmicroVMに収めている。microVMのCPUがArm Neoverse N1(Graviton2)で、bf16の命令がないことにも触れている |
どちらも、プラットフォームバージョンV1での検証で、V2は扱っていません。この記事では、その続きとして、V2で何が起きるかを東京リージョンで確かめます。
注意:先行記事の数値は、それぞれの記事の条件(リージョン、数値の形式、モデルのファイルの取得方法など)で測られたものです。この記事の数値とは直接比べず、傾向をつかむための参考としてご覧ください。
2. 今回利用するAWSサービス
1. Amazon Bedrock AgentCore Runtimeとは
AgentCore Runtimeは、AIエージェントやツールをホストするための実行環境です。エージェントのコードをコンテナなどでデプロイすると、呼び出しの受け口、セッションの管理、認証、オブザーバビリティといった周辺をAgentCoreが引き受けます。
AgentCore Runtimeには、サーバーレスなmicroVMと、EC2インスタンスで動かすRuntime instancesの2つのコンピュートタイプがあります。今回使うのはmicroVMです。microVMでは、セッションごとに専用のmicroVMが割り当てられ、CPU・メモリ・ファイルシステムがセッション単位で分離されます。1セッションに割り当てられるのは最大2vCPU・8GBで、GPUは使えません。
2. Platform version V2とは
Platform version(以下、プラットフォームバージョン)は、AgentCore Runtimeがエージェントをどう起動するかを決める設定です。
platformVersionにV1かV2を指定し、省略するとV1になります。V2では、ランタイムの作成時や更新時に、エージェントの起動時の処理を一度だけ実行し、その状態をスナップショットとして保存します。新しいセッションは、毎回コンテナを一から起動するのではなく、このスナップショットを復元して始まります。公式ドキュメントでは、モデルの重みの読み込みのような重い処理は起動時に済ませておくよう案内されています。
V1との主な違いは、次のとおりです。
| 観点 | V1 | V2 |
|---|---|---|
| 新しいセッションの起動 | 毎回コンテナを起動し、起動時の処理を実行 | スナップショットから復元 |
| ランタイムの作成・更新 | 数秒でREADY | スナップショットの準備のため数分かかる |
| 起動時のヘルスチェック | 新しいセッションの初期化が120秒を超えると、呼び出しがエラーになる(今回の検証で確認) | 起動から120秒以内に/pingが成功しないと作成に失敗 |
| 環境変数の合計サイズ | 4KB | 2.5KB(コンテナの場合) |
| 課金 | CPU・メモリの消費量ベース | CPU・メモリの消費量ベース。使わなくなったメモリは回収される |
| 対応リージョン | AgentCore Runtimeの対応リージョン | バージニア北部、オハイオ、オレゴン、アイルランド、東京 |
AgentCoreのコンソールでも、V1は「Your container image is downloaded and installed at session start.」、V2は「Container image is pre-loaded. New sessions start in seconds.」と説明されています。
起動時に行った処理の結果は、スナップショットを通じてすべてのセッションに引き継がれます。そのため、乱数や現在時刻のように「セッションごと・リクエストごとに違うべき値」は、起動時ではなくリクエストの処理の中で作る必要があります。今回の検証では、この性質を逆に利用して、スナップショットから復元されたかどうかを確かめます(詳しくはハンズオンで説明します)。
3. Strands Decider 2Bとは
Strands Decider 2B(以下、Decider)は、Strands Labsが公開した判定専用のオープンソースモデルです。AWSのサービスではありませんが、今回の主役なのでここで紹介します。
Qwen3.5-2B-Baseをベースに、文章を生成する部分を取り除き、渡された選択肢を採点する小さなヘッド(約100万パラメータ)とLoRAアダプターを組み合わせています。答え方は、次の3つの形式に限られます。
| 形式 | 返すもの | 例 |
|---|---|---|
| choice | 選択肢のうち1つ | 「この問い合わせはbilling・sales・retailのどれに回すか」 |
| noul | Yes/Noの確率(0〜1) | 「この文章は緊急性を伝えているか」 |
| score | 段階評価 | 「書き手の苛立ちはcalm・frustrated・depressedのどれか」 |
公式ブログでは、RTX 3090(GPU)で中央値約115msとされています。一方、CPUで動かすと、ベースモデルが16bit浮動小数点(bf16)から32bit浮動小数点(fp32)に自動で変換されます。ソースコードのコメントによると、変換後の重みは約7GiB(bf16なら約3.5GiB)で、8GBのmicroVMでは変換の途中でメモリが足りなくなるおそれがあります。そこで今回は、この変換を止めてbf16のまま動かします。fp32より推論は遅くなりますが、今回の目的は推論の速さではなく、コールドスタートの比較なので割り切ります。ただ、この判断が、あとで思わぬ結果につながりました(5章で紹介します)。
3. 【アーキテクチャ解説】VPC内のmicroVMで、S3からモデルのファイルを取得する
今回の構成は、次のとおりです。1つのコンテナイメージを、プラットフォームバージョンだけが違う2つのランタイム(V1とV2)に載せて、同じ条件で呼び出します。ランタイムはVPCモードで動かし、インターネットへの出口(NATゲートウェイ)は作りません。
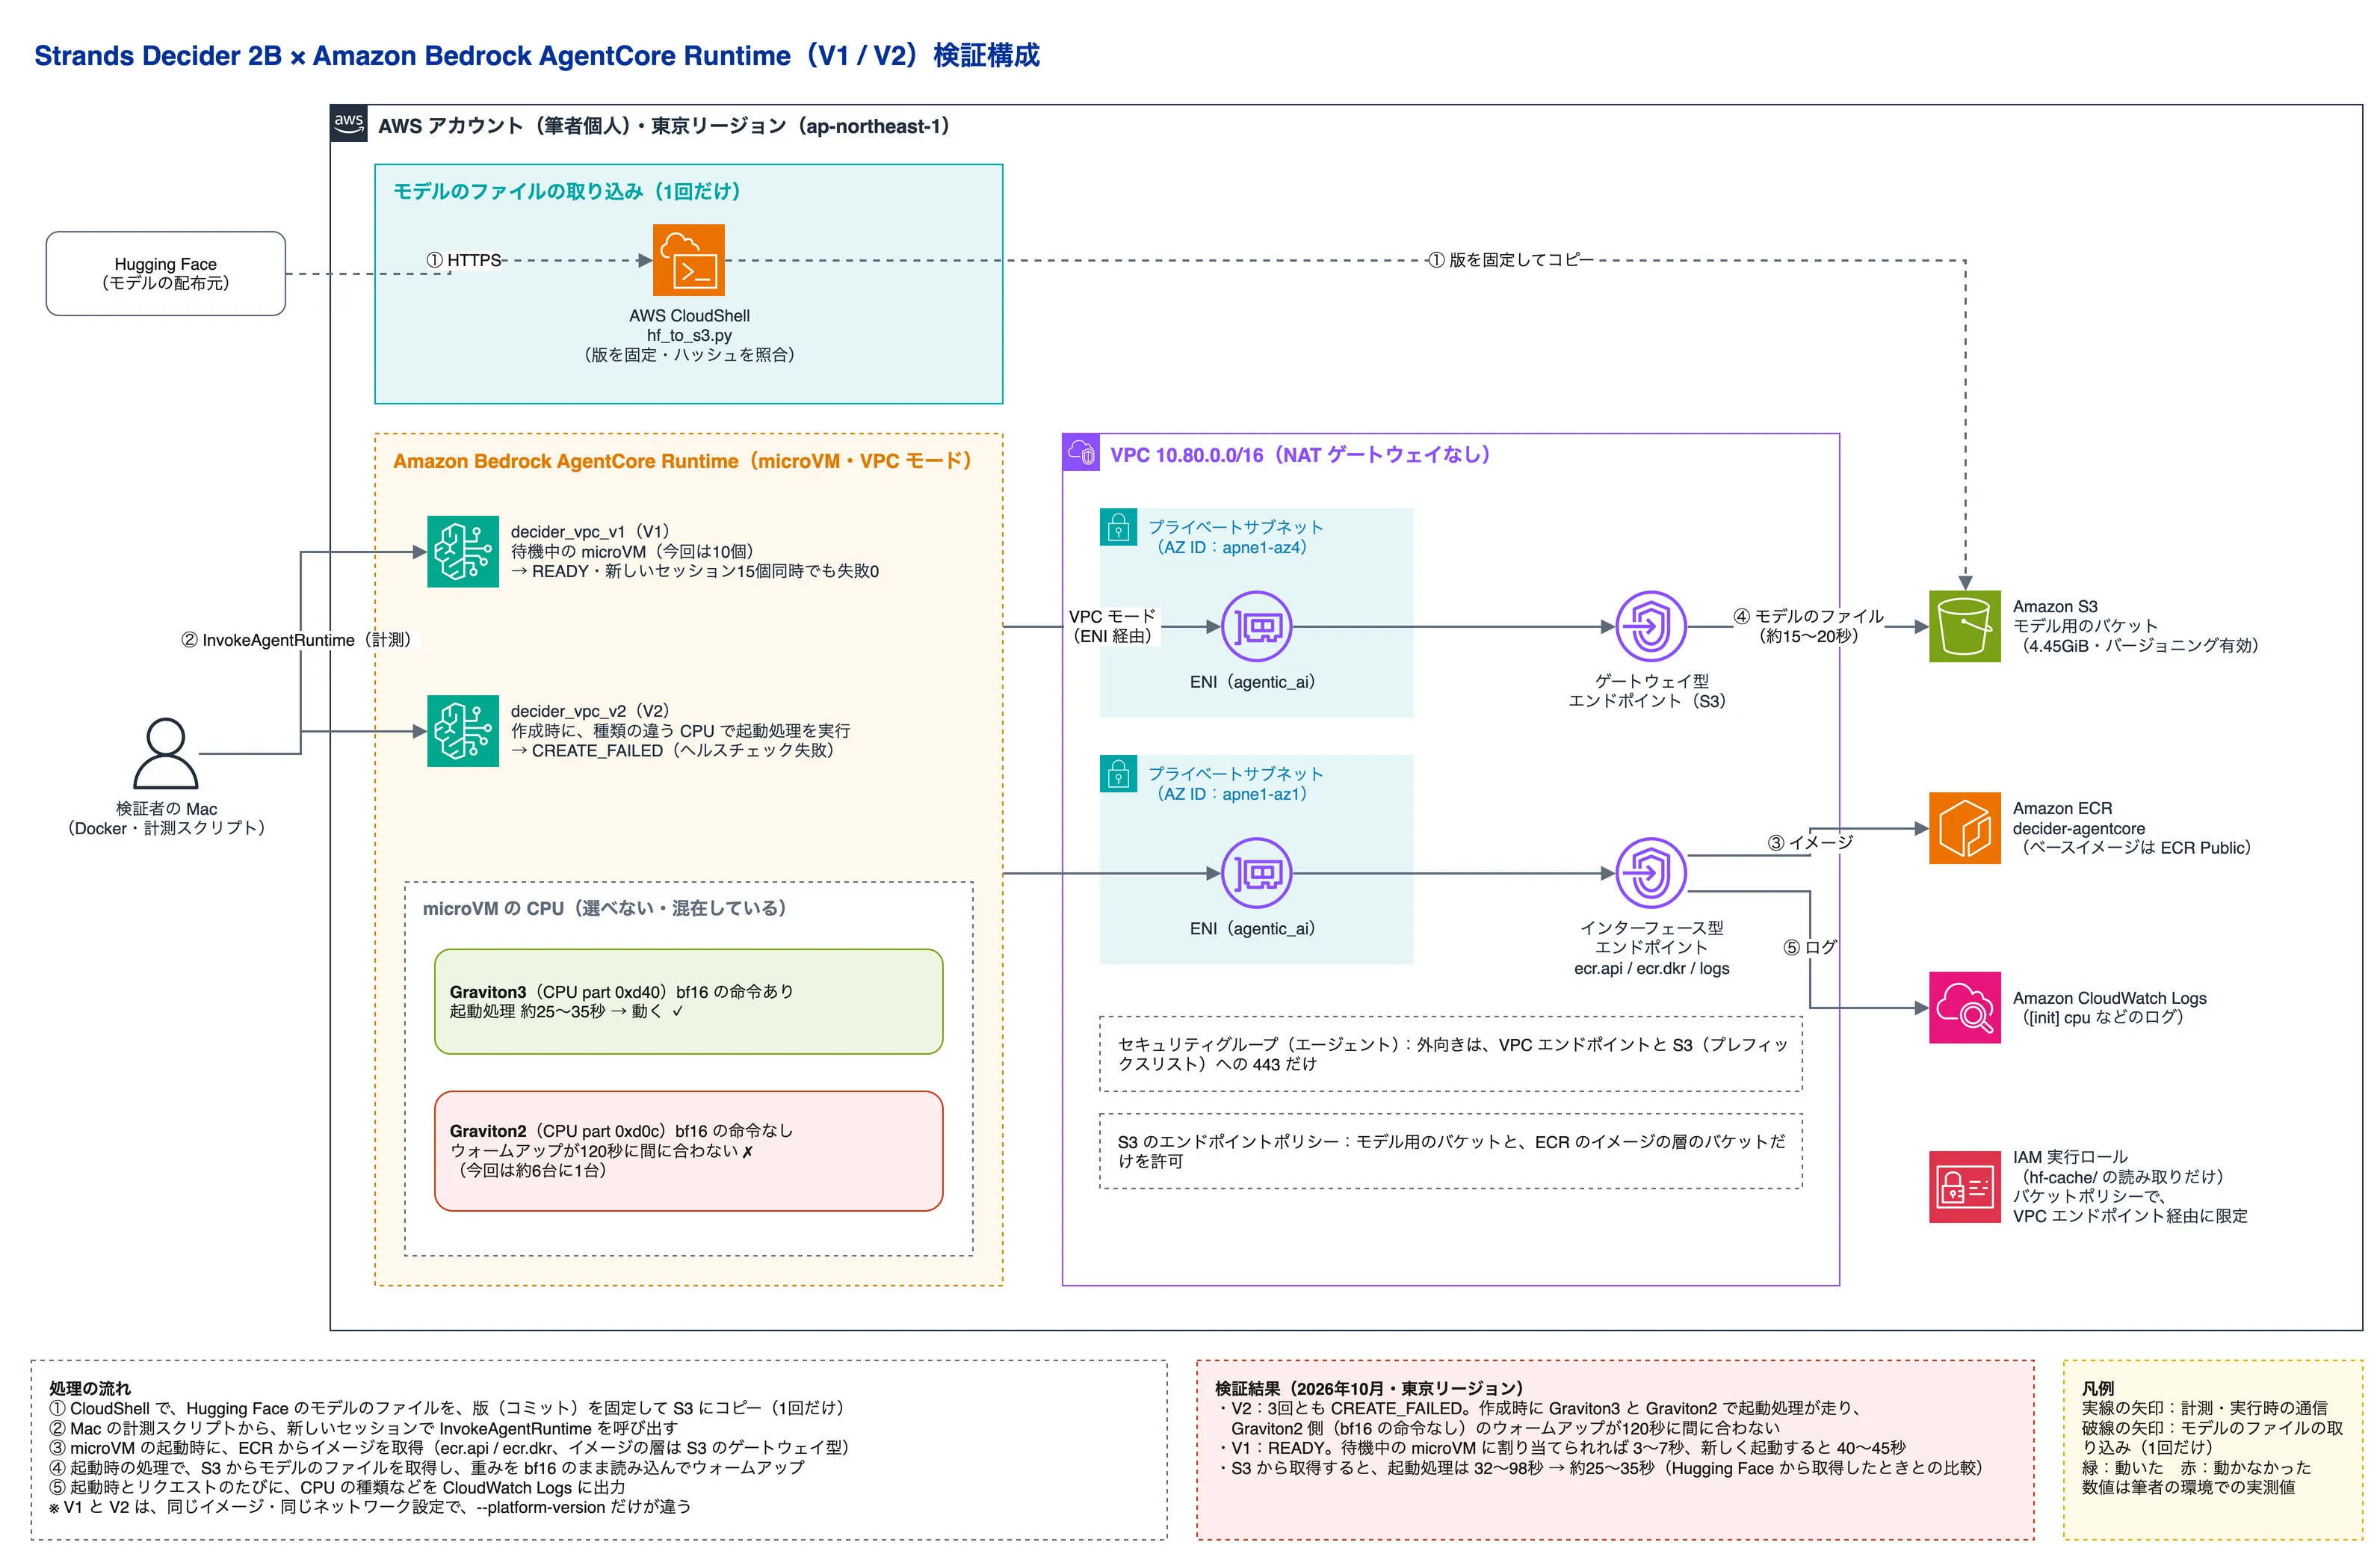
処理の流れは、次のとおりです。
- 事前に、AWS CloudShellからHugging Faceのモデルのファイルを、版(コミット)を固定したままAmazon S3にコピーしておきます
- ランタイムがAmazon ECRからコンテナイメージを取得して、コンテナを起動します。イメージの取得は、VPCエンドポイント(ecr.api / ecr.dkr、イメージの層はS3のゲートウェイ型)を通ります
- 起動時の処理として、S3からモデルのファイル(約4.45GiB)を取得し、重みをbf16のままメモリに読み込みます。Hugging Faceには接続しません
- 続けて、ウォームアップとして推論を1回実行します。ここまで終わってから、
/pingに応答し始めます - V2では、この時点の状態がスナップショットとして保存されます
- 計測スクリプトが、新しいセッションIDで
InvokeAgentRuntimeを呼び出します - エージェントは、判定結果と一緒に、起動時の処理にかかった時間・メモリ使用量・CPUの種類などの計測値を返します
この構成では、比べたい条件以外をそろえています。イメージ・IAMロール・ネットワーク設定はまったく同じで、ランタイムの作成時に
--platform-versionをV1にするかV2にするかだけが違います。アプリケーションのコードにも、V1用・V2用の分岐はありません。補足:モデルのファイルをイメージに入れず、起動時に取得しているのは、AgentCore Runtimeのイメージの上限が2GBだからです。今回のイメージは、モデルのファイルを含まない状態で1.83GB(圧縮後は393MB)でした。
なぜモデルのファイルをAmazon S3に置くのか
Deciderのモデルのファイルは、Hugging Faceで配布されています。Decider本体(約224MB)は
StrandsAgents、ベースモデルのQwen3.5-2B-Base(約4.2GB)はQwenのリポジトリにあり、Deciderの読み込み処理は、ベースモデルをHugging Faceから自動でダウンロードします。ただ、ランタイムが起動するたびに外部のサービスからモデルのファイルを取得する形には、本番運用では気になる点が3つあります。
- 起動にかかる時間が、外部のサービスや回線の状況に左右される(AgentCore Runtimeには、120秒以内に初期化が終わらないと失敗する制限があります)
- 外部のサービスが止まっていると、新しいセッションを起動できない
- エージェントの実行環境から、インターネットへ出る経路が必要になる
そこで今回は、外部の配布元は「モデルのファイルを取り込むとき」だけ使い、実行時は自分のアカウントの中だけで完結させる形にしました。ベースイメージをDocker HubではなくAmazon ECR Publicから取得しているのと、同じ考え方です。「実行時に依存する外部サービスを減らす」ことは、可用性の面でもセキュリティの面でも効果があります。
実際に、Hugging Faceから取得していたときと比べて、起動時の処理は大きく短くなりました(詳しくは5章で紹介します)。
補足:Deciderの公式リポジトリにある、Amazon SageMaker AIへのデプロイ手順も、モデルをプライベートなS3バケットにコピーしてからエンドポイントを作る流れになっています。
通信と権限の絞り方
エージェントがインターネットに出られない前提で、通信と権限を次のように絞りました。
| 層 | 設定 | ねらい |
|---|---|---|
| ネットワーク | プライベートサブネットのみ、NATゲートウェイなし | インターネットへ出る経路を作らない |
| セキュリティグループ(エージェント) | 外向きは、VPCエンドポイントとS3(プレフィックスリスト)への443だけ | 既定の「外向きはすべて許可」を消す |
| S3のゲートウェイ型エンドポイント | エンドポイントポリシーで、モデル用のバケットとECRのイメージの層のバケットだけを許可 | VPCから読めるS3を絞る |
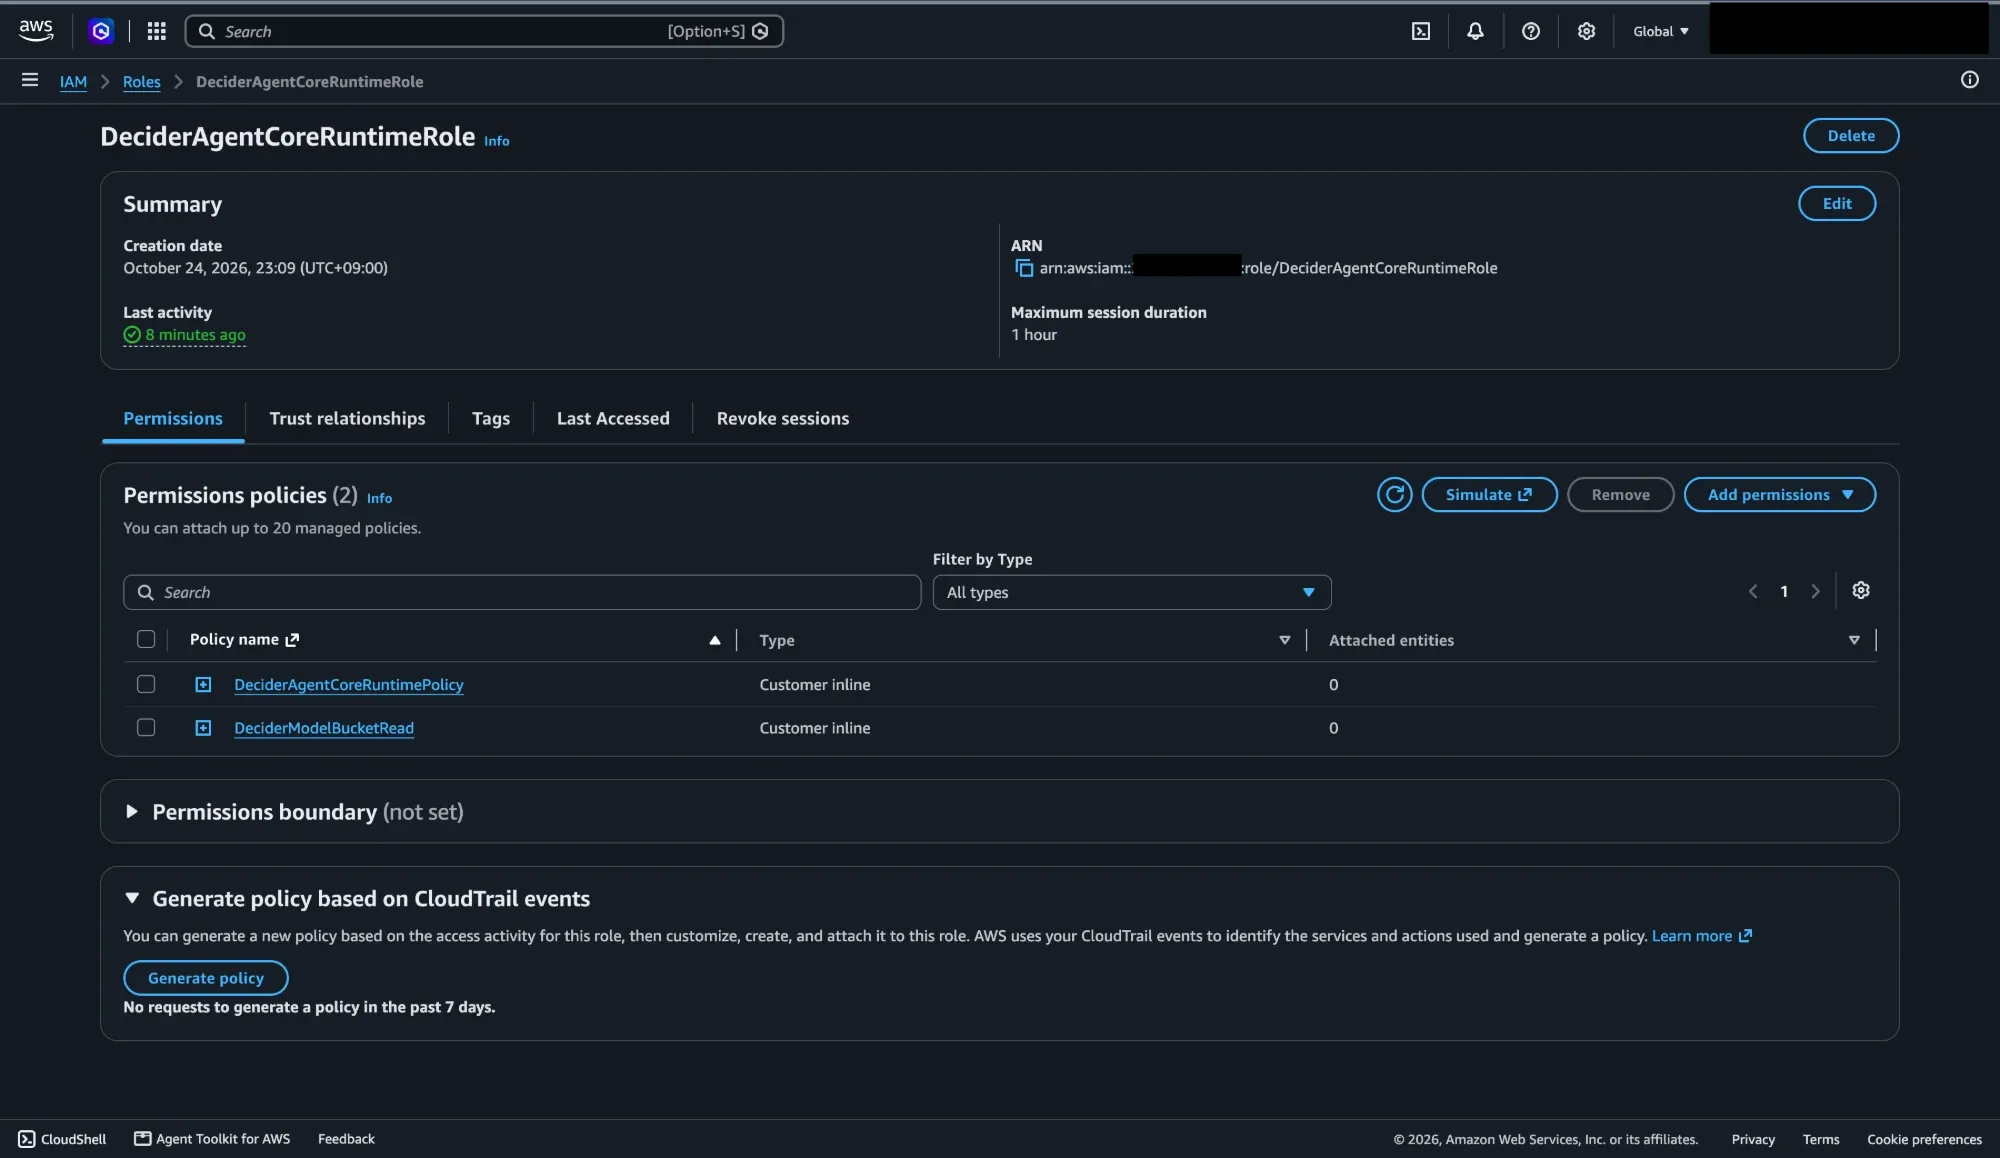
| 実行ロール | モデル用のバケットのhf-cache/配下の読み取りだけを追加 | 書き込みや他のパスは不可 |
| バケットポリシー | 実行ロールは、S3のVPCエンドポイント経由のときだけ読める | 実行ロールの認証情報が漏れても、VPCの外からは読めない |
4. 【ハンズオン】VPC内のV1とV2に同じコンテナを載せて比べてみる
コードと、すべてのコマンドを含む手順は、GitHubのリポジトリにまとめています。この章では、手順の流れと、押さえておきたいポイントを紹介します。
リポジトリ:strands-decider-on-agentcore-runtime (MIT-0)
前提条件
- Mac OSで作業します(Apple siliconを想定しています)
- AWS CLIの
create-agent-runtimeが--platform-versionに対応していること(今回はAWS CLI 2.38.5を使用) - Docker Desktopがインストールされていること。ローカルで動作確認する場合は、Settings → Resources → Memoryを10GB以上にしておきます(コンテナに8GBを割り当てるため)
- Python 3.12と、boto3(1.43.116で確認)がインストールされていること
- リージョンは東京(ap-northeast-1)を使います
- 角括弧の部分(例:[アカウントID])は、ご自身の環境の値に置き換えてください
AWS CLIが
--platform-versionに対応しているかは、次のコマンドで確認できます。1
aws bedrock-agentcore-control create-agent-runtime help | col -b | grep -A2 platform-version--platform-versionの説明が表示されれば対応しています。何も表示されない場合は、AWS CLIを最新版に更新してください。手順の全体像
| ステップ | やること | 場所 |
|---|---|---|
| 1 | モデルのファイルを、版を固定してS3にコピーする | AWS CloudShell |
| 2 | エージェントのコードを確認する | ― |
| 3 | イメージをビルドして、ローカルで動作確認する | Mac |
| 4 | Amazon ECRにpushする | Mac |
| 5 | VPC・VPCエンドポイント・IAMロール・バケットポリシーを作る | Mac(AWS CLI) |
| 6 | V1とV2のランタイムを作る | Mac(AWS CLI) |
| 7 | 新しいセッションを同時に呼び出して計測する | Mac |
ステップ1:モデルのファイルをS3にコピーする
モデルのファイルを置くS3バケット(以下、モデル用のバケット)を作り、バージョニングを有効にします(上書きや削除をしても、前の版が残るようにするため)。
1
aws s3api create-bucket --bucket decider-models-[アカウントID]-apne1 --region ap-northeast-1 --create-bucket-configuration LocationConstraint=ap-northeast-1
1
aws s3api put-bucket-versioning --bucket decider-models-[アカウントID]-apne1 --versioning-configuration Status=Enabledモデルのファイルのコピーは、AWS CloudShell(東京リージョン)で行います。CloudShellなら、Hugging FaceからS3へ、AWSの中で直接コピーできます。CloudShellでリポジトリを取得して、コピー用のスクリプトを実行します。
1
git clone https://github.com/KoheiMatsunobu/strands-decider-on-agentcore-runtime.git && cd strands-decider-on-agentcore-runtime
1
python3 scripts/hf_to_s3.py --bucket decider-models-$(aws sts get-caller-identity --query Account --output text)-apne1以下のような出力結果が表示されます。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
OK Qwen/Qwen3.5-2B-Base/LICENSE 0.0MiB 0.2s (0MiB/s)
OK Qwen/Qwen3.5-2B-Base/config.json 0.0MiB 0.2s (0MiB/s)
OK Qwen/Qwen3.5-2B-Base/model.safetensors-00001-of-00001.safetensors 4337.5MiB 126.2s (34MiB/s)
OK Qwen/Qwen3.5-2B-Base/model.safetensors.index.json 0.1MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/.gitattributes 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/LICENSE.md 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/MANIFEST.sha256 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/README.md 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/chat_template.jinja 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/internal/eval.log 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/internal/recipe_heldout.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/health.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/manifest.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/paired.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/paired.txt 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/results.jsonl 0.2MiB 0.3s (1MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/run_meta.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/jevbench-w4096/summary.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/eval/summary.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/head.safetensors 12.0MiB 2.1s (6MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/lora/adapter_config.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/lora/adapter_model.safetensors 192.5MiB 7.6s (25MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/provenance.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/strands_decider_config.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/tokenizer.json 19.1MiB 2.4s (8MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/tokenizer_config.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/train_config.json 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/training/configs/v1-qwen3.5-2b-s0.yaml 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/training/configs/v1-qwen3.5-2b-s1.yaml 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/training/configs/v1-qwen3.5-2b-s2.yaml 0.0MiB 0.3s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/training/data_sha256.txt 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/training/sources.md 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610/training/stages.jsonl 0.0MiB 0.2s (0MiB/s)
OK StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 refs/main -> 216d1ccb46a9e9b036eb9187b248db98480f77d4

完了: 4.45GiB、146秒
4.45GiBを、約2分半でコピーできました。スクリプト(
scripts/hf_to_s3.py)のポイントは3つです。- 版を固定する:Hugging Faceのコミットを指定して取得し、S3にはHugging Faceのキャッシュと同じ構成(
models--[モデル名]/snapshots/[コミットID]/...)で置きます。エージェント側は、これをそのままキャッシュとして読み込めます - ディスクを使わない:Hugging Faceから読んだデータを、そのままS3に流し込みます。CloudShellのディスク容量(1GB)を気にしなくて済みます
- ハッシュを照合する:コピーしながら、LFSのファイルはsha256、それ以外はgitのハッシュを計算し、Hugging Faceが公開している値と照合します。結果はS3のメタデータ(
hf-repo、hf-revision、hf-oid)にも残します
ステップ2:エージェントのコードを確認する
エージェントのコードは、リポジトリの
app/agent.py です。ポイントは4つです。以下のコードは、説明に必要な部分だけを抜き出したものです(途中を省略しています)。ポイント①:起動時の処理は、すべてapp.run()の前に書く
S3からの取得、モデルの読み込み、ウォームアップの推論は、関数の外(モジュールの読み込み時)に書いています。
1
2
3
4
5
6
7
8
9
10
11
12
ENGINE = load_engine(MODEL_ID, device="cpu")
# スナップショットの前に1回推論して、推論で使うメモリやコードを温めておく
ENGINE.evaluate(SystemOneRequest.model_validate(WARMUP))
app = BedrockAgentCoreApp()
def invoke(payload):
...
if __name__ == "__main__":
app.run() # ここから先で /ping に応答できるようになるAgentCore Pythonの
BedrockAgentCoreAppは、app.run()を呼ぶまでポート8080で待ち受けを始めません。つまり、起動時の処理が終わるまで/pingは成功せず、V2のスナップショットは「読み込みもウォームアップも済んだ状態」で取られます。これは、公式ドキュメントで案内されている書き方に沿っています。ポイント②:S3からモデルのファイルを取得して、Hugging Faceには接続しない
1
2
3
4
5
6
7
8
MODEL_S3_URI = os.environ.get("MODEL_S3_URI")  # 例: s3://[バケット名]/hf-cache/hub/
if MODEL_S3_URI:
    # huggingface_hub は import 時にこの環境変数を読むので、import より前に設定する
    os.environ.setdefault("HF_HUB_OFFLINE", "1")
    download_hf_cache_from_s3(MODEL_S3_URI, HF_HUB_DIR)

import torch
from strands_decider.infer import SystemOneEngine, load_engine
環境変数
MODEL_S3_URIがあれば、S3からHugging Faceのキャッシュと同じ構成でファイルを取得し、HF_HUB_OFFLINE=1で読み込みます。huggingface_hubはimportするときにこの環境変数を読むので、importより前に設定しているのがポイントです。ポイント③:CPUでのfp32への変換を止めて、bf16のまま動かす
1
2
# CPU では torso が fp32 に変換される(約7GiB)。8GB の microVM に収めるため bf16 のまま動かす。
SystemOneEngine._upcast_torso_for_cpu = lambda self: None
Deciderは、CPUで動かすとベースモデルを自動でfp32に変換しますが、そうすると重みだけで約7GiBになり、8GBのmicroVMでは余裕がありません。bf16のままなら約3.5GiBで済みます。
ポイント④:init_idとCPUの情報で、何が起きたかを確かめる
1
2
3
4
5
6
7
# わざと起動時に作る値。V2 ではスナップショットに入るので、全セッションで同じ値になる(V1 ではセッションごとに違う)
INIT_ID = os.urandom(8).hex()

# 起動時とリクエストのたびに、/proc/cpuinfo の CPU part と Features(bf16 / sve)をログに出す
INIT_CPU = {**cpu_info(), "torch_capability": torch.backends.cpu.get_cpu_capability(),
            "mkldnn": torch.backends.mkldnn.enabled}
print(f"[init] cpu {INIT_CPU}", flush=True)INIT_IDは、起動時に1回だけ作る乱数です。V1では新しいセッションのたびに起動時の処理が走るので、セッションごとに違う値になります。V2では、起動時の処理の結果がスナップショットごと引き継がれるので、すべてのセッションで同じ値になるはずです。本来、乱数は起動時に作ってはいけない値の代表例ですが(公式ドキュメントでも、リクエストの処理の中で作るよう案内されています)、今回はその性質を逆手に取って、復元されたかどうかの目印にしています。あわせて、
/proc/cpuinfoから、CPUコアの種類を表す番号(CPU part)と、bf16の命令に対応しているかをログに出しています。この仕掛けが、5章で紹介する原因の特定に決め手になりました。ステップ3:イメージをビルドして、ローカルで動作確認する
Macでリポジトリを取得して、イメージをビルドします。torchのダウンロードを含むため、10分前後かかります。
1
git clone https://github.com/KoheiMatsunobu/strands-decider-on-agentcore-runtime.git && cd strands-decider-on-agentcore-runtime
1
docker build -t decider-agentcore:latest .イメージは、モデルのファイルを含まない状態で1.83GB(圧縮後393MB)で、AgentCore Runtimeの上限である2GBに収まっています。
AWSに載せる前に、microVMと同じ2vCPU・8GB(スワップなし)、かつネットワークなしの条件で、手元で動くかを確かめておきます。S3にコピーしたモデルのファイルをMacにダウンロードしてから(約4.5GB)、ネットワークを切った状態(
--network none)で起動します。1
aws s3 sync s3://decider-models-[アカウントID]-apne1/hf-cache/ ~/.cache/decider-offline/1
docker run --rm --network none --cpus 2 --memory 8g --memory-swap 8g -e HF_HUB_OFFLINE=1 -v "$HOME/.cache/decider-offline:/root/.cache/huggingface" decider-agentcore:latest以下のような出力結果が表示されます。
1
2
3
4
5
[] cpu {'cpu_part': '0x000', 'bf16': True, 'sve': False, 'torch_capability': 'DEFAULT', 'mkldnn': True}
Loading weights: 100%|██████████| 320/320 [00:00<00:00, 1741.97it/s]
[] `chunk_gated_delta_rule` is falling back to its reference PyTorch implementation because `flash-linear-attention` is not installed. This is correct but much slower; install `flash-linear-attention` for the optimized kernel.
[] load=3.7s warmup=13.0s total=21.1s {'rss_gib': 3.42, 'mem_available_gib': 13.97}
[] app.run at 05:34:29 (process +21.1s)ネットワークなしでも読み込めて、メモリ(RSS)は3.42GiBと、8GBに十分収まっています。確認できたら
Ctrl + Cで止めます。ステップ4:Amazon ECRにpushする
Amazon ECR(以下、ECR)にリポジトリを作り、イメージをpushします(コマンドはリポジトリのREADMEを参照)。pushでは、ベースイメージ(Python)の層も含めて、すべての層がECRに送られます。AgentCore RuntimeはECRからイメージを取得するので、起動のたびに外部のレジストリへ取りに行くことはありません。
ステップ5:VPC・VPCエンドポイント・IAMロール・バケットポリシーを作る
3章の「通信と権限の絞り方」の構成を作ります。すべてのコマンドは、リポジトリのREADMEにあります。
| 作るもの | 内容 |
|---|---|
| VPC | 10.80.0.0/16。DNSホスト名を有効にする |
| プライベートサブネット ×2 | 10.80.1.0/24(AZ ID:apne1-az4)、10.80.2.0/24(AZ ID:apne1-az1) |
| セキュリティグループ ×2 | エージェント用(外向きはVPCエンドポイントとS3への443だけ)、VPCエンドポイント用(エージェントからの443だけ) |
| ゲートウェイ型エンドポイント | S3(エンドポイントポリシーで、モデル用のバケットとECRのイメージの層のバケットだけを許可) |
| インターフェース型エンドポイント | ecr.api、ecr.dkr、logs |
| IAMロール(実行ロール) | ECRからの取得、ログ、トレース、メトリクス。加えて、モデル用のバケットのhf-cache/配下の読み取りだけ |
| バケットポリシー | 実行ロールは、S3のVPCエンドポイント経由のときだけ読める |
注意:AgentCore RuntimeをVPCで使えるAZは決まっています。東京リージョンでは、AZ IDがapne1-az1、apne1-az2、apne1-az4のサブネットを使います。AZ名(ap-northeast-1aなど)とAZ IDの対応はアカウントごとに違うので、AZ IDで指定するのが確実です。
いちばんのポイントは、バケットポリシーです。実行ロールの認証情報が万一外に漏れても、VPCの外からはモデルのファイルを読めないようにします。自分(管理者)やCloudShellからの操作は制限しません。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
{
  "Version": "2012-10-17",
  "Statement": [{
    "Sid": "RuntimeRoleOnlyViaVpce",
    "Effect": "Deny",
    "Principal": "*",
    "Action": ["s3:GetObject", "s3:ListBucket"],
    "Resource": ["arn:aws:s3:::[モデル用のバケット]", "arn:aws:s3:::[モデル用のバケット]/*"],
    "Condition": {
      "ArnEquals": {"aws:PrincipalArn": "arn:aws:iam::[アカウントID]:role/DeciderAgentCoreRuntimeRole"},
      "StringNotEquals": {"aws:SourceVpce": "[S3のゲートウェイ型エンドポイントのID]"}
    }
  }]
}
注意:インターフェース型エンドポイントは、置いておくだけで「エンドポイントの数 × AZの数 × 時間」で課金されます。検証が終わったら、必ず消してください。
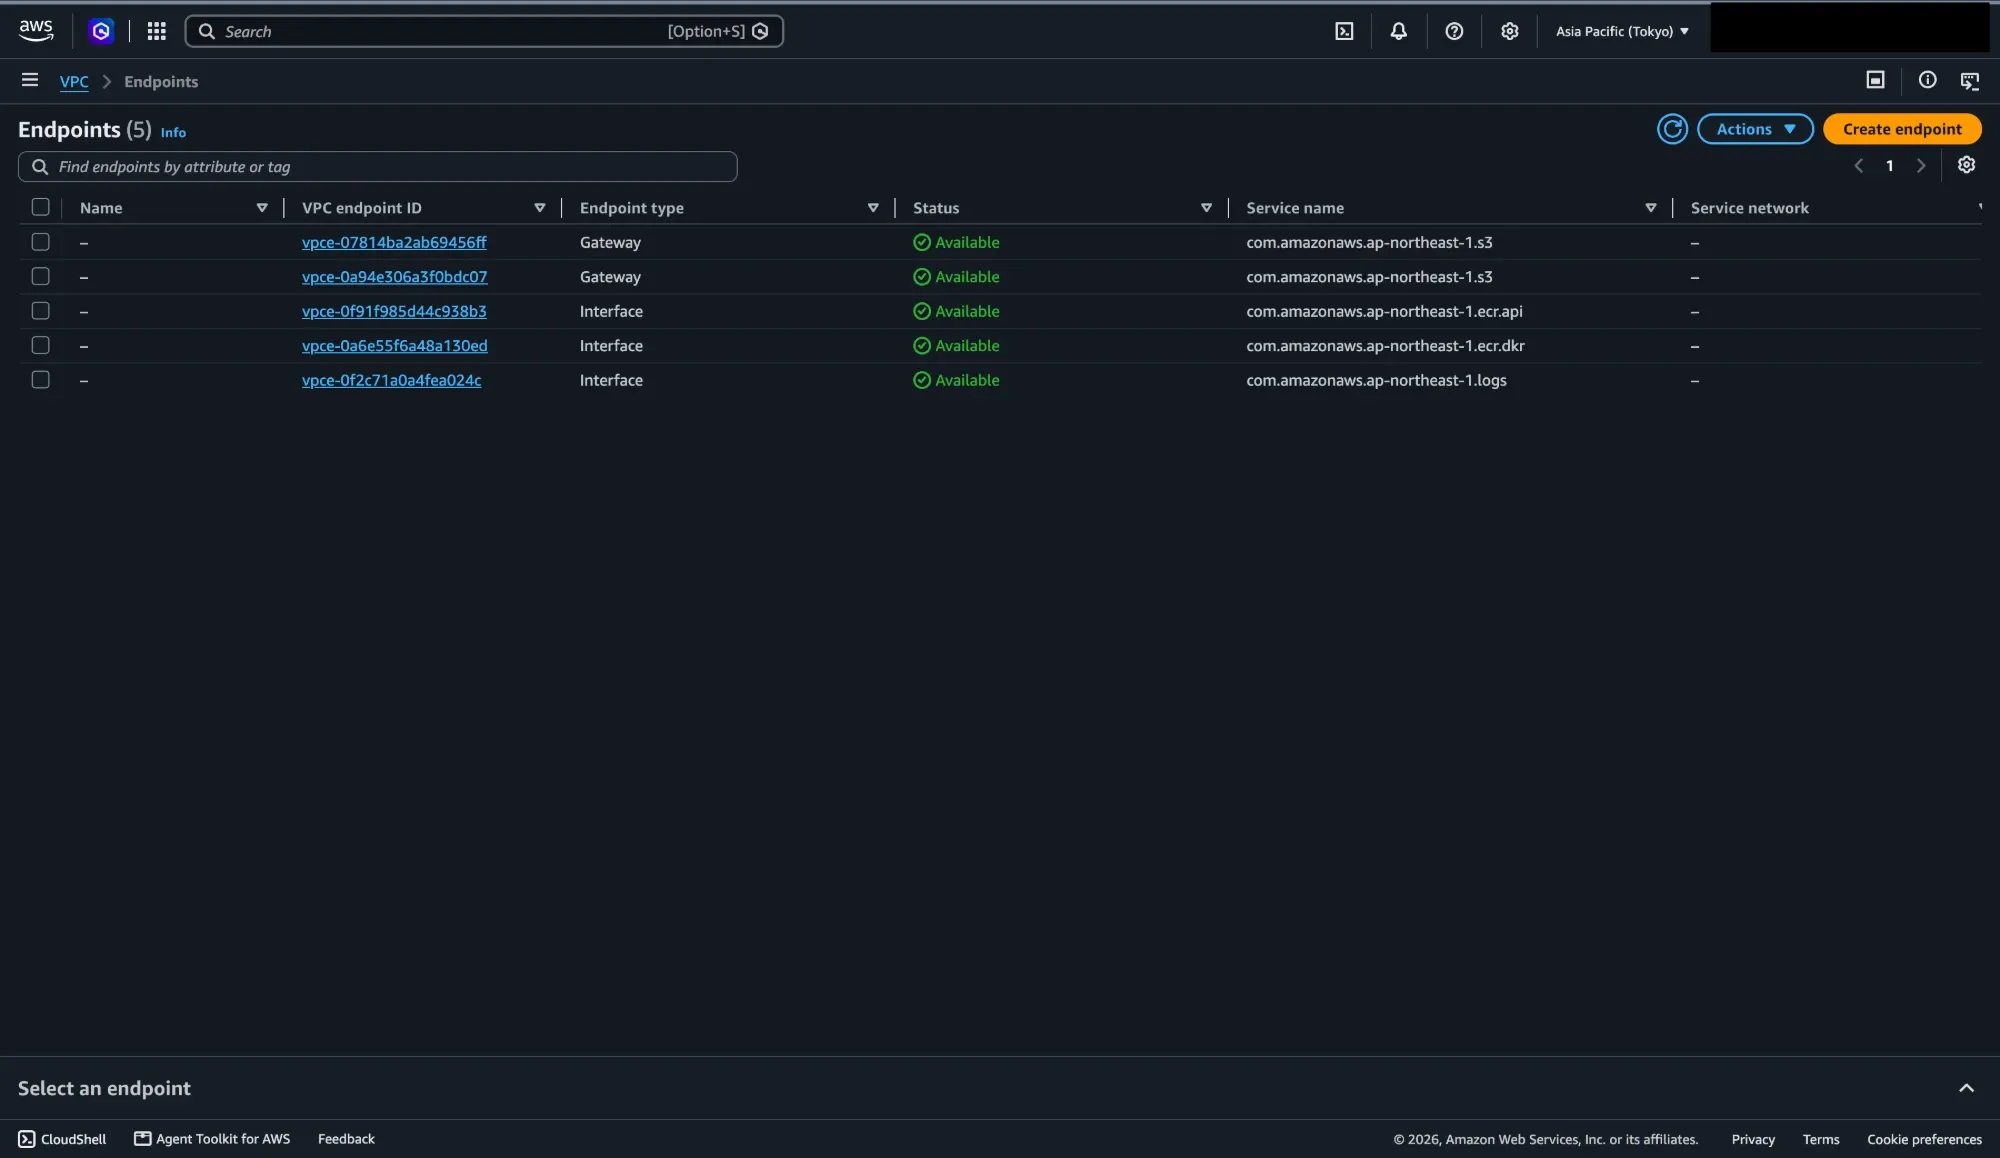
1行目は、今回とは別のVPCのエンドポイントです。今回作ったのは、2行目以降の4つです。
ステップ6:V1とV2のランタイムを作成する
同じイメージ・同じネットワーク設定で、
--platform-versionだけを変えた2つのランタイムを作ります。環境変数MODEL_S3_URIで、モデルのファイルの置き場所を渡します。1
aws bedrock-agentcore-control create-agent-runtime --region ap-northeast-1 --agent-runtime-name decider_vpc_v1 --role-arn arn:aws:iam::[アカウントID]:role/DeciderAgentCoreRuntimeRole --agent-runtime-artifact '{"containerConfiguration": {"containerUri": "[アカウントID].dkr.ecr.ap-northeast-1.amazonaws.com/decider-agentcore:latest"}}' --network-configuration '{"networkMode": "VPC", "networkModeConfig": {"subnets": ["[サブネット1のID]", "[サブネット2のID]"], "securityGroups": ["[エージェント用のSGのID]"]}}' --environment-variables MODEL_S3_URI=s3://[モデル用のバケット]/hf-cache/hub/ --platform-version V1V2は、名前を
decider_vpc_v2に、最後を--platform-version V2に変えて、同じように作ります。状態を確認します。VPCモードのV1は、ネットワークインターフェースの作成のため、
READYになるまで約4〜5分かかりました。V2は、スナップショットを準備するため、さらに時間がかかります(今回は毎回7〜9分ほどで結果が出ました)。1
aws bedrock-agentcore-control get-agent-runtime --region ap-northeast-1 --agent-runtime-id [agentRuntimeId] --query '[status,platformVersion,failureReason]'V1は、以下のような出力結果が表示されます。
1
2
3
4
5
[
    "READY",
    "V1",
    null
]
一方、V2は今回、何度試しても次の結果になりました。
1
2
3
4
5
[
    "CREATE_FAILED",
    "V2",
    "The runtime failed its health check. Ensure your container serves the configured health endpoint."
]
この原因は、5章で詳しく紹介します。
補足:VPCモードのランタイムを作ると、AgentCoreがサブネットにネットワークインターフェース(ENI)を作ります。これは「AWSのサービスが管理するリソース」なので、EC2コンソールでは既定で非表示になっています。aws ec2 modify-managed-resource-visibility --region ap-northeast-1 --default-visibility visibleで表示されるようになり、Interface Typeがagentic_aiのENIとして確認できます(アカウント全体の、リージョンごとの設定です)。

ステップ7:新しいセッションを同時に呼び出して計測する
計測スクリプト(
scripts/measure.py )で、V1のランタイムに、新しいセッションを15個同時に呼び出します。1
python3 scripts/measure.py --arn [V1のagentRuntimeArn] --label vpc-v1-burst --n 15以下のような出力結果が表示されます。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
15 個のセッションを同時に呼び出します...
  #14: 4520 ms(server 2401.8 ms)init_total=27.6s since_init=156.8s cpu=0xd40
  #10: 4544 ms(server 2380.8 ms)init_total=26.5s since_init=158.0s cpu=0xd40
  #6: 4568 ms(server 2390.8 ms)init_total=25.4s since_init=159.3s cpu=0xd40
  #12: 4614 ms(server 2400.1 ms)init_total=26.1s since_init=158.2s cpu=0xd40
  #2: 4651 ms(server 2382.2 ms)init_total=26.5s since_init=158.3s cpu=0xd40
  #8: 4659 ms(server 2417.8 ms)init_total=25.6s since_init=159.3s cpu=0xd40
  #4: 4896 ms(server 2433.4 ms)init_total=25.3s since_init=159.8s cpu=0xd40
  #1: 4969 ms(server 2409.2 ms)init_total=27.7s since_init=157.4s cpu=0xd40
  #11: 7309 ms(server 2809.7 ms)init_total=27.3s since_init=159.7s cpu=0xd40
  #0: 7422 ms(server 2586.1 ms)init_total=26.5s since_init=161.0s cpu=0xd40
  #3: 42306 ms(server 2365.2 ms)init_total=25.6s since_init=2.8s cpu=0xd40
  #13: 42352 ms(server 2425.5 ms)init_total=25.8s since_init=2.5s cpu=0xd40
  #5: 44248 ms(server 2462.9 ms)init_total=25.9s since_init=4.2s cpu=0xd40
  #7: エラー An error occurred (RuntimeClientError) when calling the InvokeAgentRuntime operation: Runtime initialization time exceeded. Please make sure that initialization completes in 120s.
  #9: エラー An error occurred (RuntimeClientError) when calling the InvokeAgentRuntime operation: Runtime initialization time exceeded. Please make sure that initialization completes in 120s.

保存: results/vpc-v1-burst-20261025-145138.csv
起動時のログは、Amazon CloudWatch Logs Insightsで確認できます。ロググループに
/aws/bedrock-agentcore/runtimes/[agentRuntimeId]-DEFAULTを選んで、次のクエリを実行します。1
2
3
fields @timestamp, @logStream, @message
| filter @message like /\[init\] cpu|app.run at|mkldnn_matmul failed/
| sort @timestamp ascクリーンアップ
検証が終わったら、利用する側から順に削除します(コマンドはリポジトリのREADMEを参照)。
- ランタイム(V1・V2)
- VPCエンドポイント(時間課金があるので、最初に消すのがおすすめ)
- セキュリティグループ、サブネット、VPC(AgentCoreが作ったENIは、ランタイムの削除から最大8時間残ります。ENIが消えてから削除します)
- ECRリポジトリ
- S3バケット(バージョニングを有効にしているので、すべての版と削除マーカーを消してから削除します)
- IAMロール、ロググループ
補足:V2のスナップショットは、ランタイムを削除すると自動で削除されます(最大8時間かかることがあります)。ユーザーが直接削除する操作はありません。
5. 【検証結果】V2の作成失敗と、その原因
結論から書くと、今回の構成では、V2のランタイムを作ることができませんでした。そして、その原因を調べていくうちに、microVMのCPUについて、V1にも関わる性質が見えてきました。順に紹介します。
注意:ここで紹介する数値は、2026年10月24〜25日に東京リージョンで計測した、今回の環境での結果です。CPUの割り当てや待機中のmicroVMの数などは、公式ドキュメントに記載がなく、ログから読み取った挙動です。時期や環境によって変わる可能性があります。
5-1. V2は、3回とも作成に失敗した
構成を変えながら、V2のランタイムを3回作りましたが、いずれも
CREATE_FAILED(ヘルスチェックに失敗)になりました。| 回 | 構成 | Python側の起動処理(app.runまで) | 結果 |
|---|---|---|---|
| 1 | PUBLIC、モデルのファイルはHugging Faceから取得 | 74.8秒 | CREATE_FAILED |
| 2 | VPC+S3 | 63.3秒 | CREATE_FAILED |
| 3 | VPC+S3、CPUの情報をログに出す版 | 63.4秒 | CREATE_FAILED |
最初は「起動処理が120秒に間に合っていないのでは」と考えました。ところが、Python側の起動処理は、どの回も120秒より十分短く終わっています。

5-2. 原因:V2は、種類の違うCPUで起動処理を走らせていた
決め手になったのは、ステップ2のポイント④で仕込んだCPUの情報です。3回目のV2の作成時のログを、Logs Insightsで抜き出すと、次のようになりました。
1
2
3
4
2026-10-24T16:15:10.740Z [init] cpu {'cpu_part': '0xd40', 'bf16': True, 'sve': False, 'torch_capability': 'DEFAULT', 'mkldnn': True, 'cpu_safe': False}
2026-10-24T16:15:14.767Z [init] cpu {'cpu_part': '0xd0c', 'bf16': False, 'sve': False, 'torch_capability': 'DEFAULT', 'mkldnn': True, 'cpu_safe': False}
2026-10-24T16:15:15.776Z [init] app.run at 16:15:15 (process +63.4s)
2026-10-24T16:15:26.878Z /usr/local/lib/python3.12/site-packages/torch/nn/modules/linear.py:134: UserWarning: mkldnn_matmul failed, switching to BLAS gemm:mkldnn_matmul: mkldnn_matmul bf16 path needs a cpu with bf16 support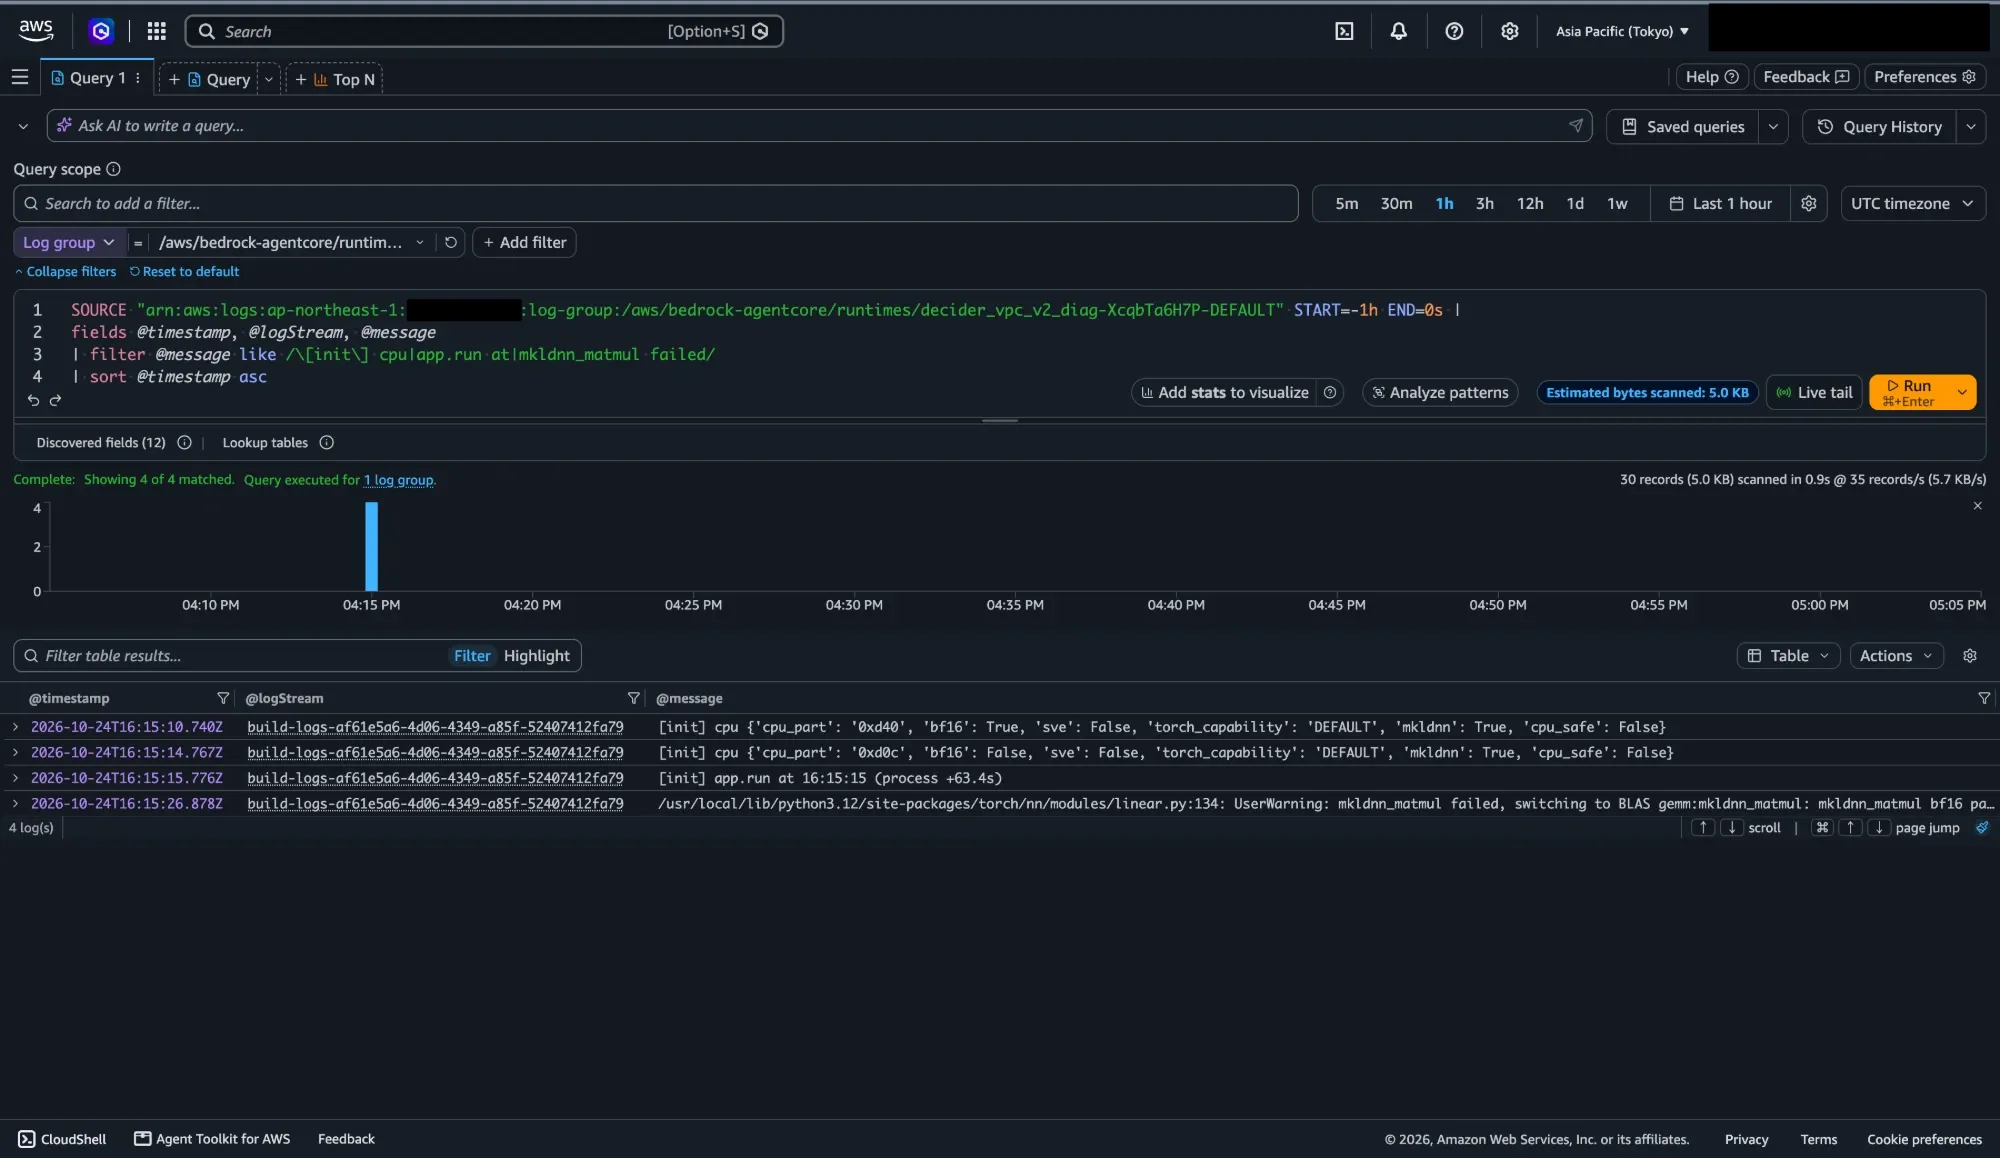
1つのログストリームに、
[init] cpuの行が2つ出ています。V2は作成時に、2台のmicroVMで同時に起動処理を走らせていたのです。しかも、その2台はCPUの種類が違いました。| 1台目 | 2台目 | |
|---|---|---|
CPUコアの種類(CPU part) | 0xd40(Arm Neoverse V1 = AWS Graviton3) | 0xd0c(Arm Neoverse N1 = AWS Graviton2) |
| bf16の命令 | あり | なし |
| ウォームアップの推論 | 2.8秒で完了し、app.runまで進んだ | bf16非対応の警告のあと、終わらないままログが途絶えた |
補足:CPU partは、CPUの製品の型番ではなく、Armが設計したCPUコアの種類ごとに決まっている番号です。0xd40はNeoverse V1、0xd0cはNeoverse N1で(Linuxカーネルの定義による)、AWS Graviton Technical Guideでは、Graviton3がNeoverse V1(bf16やSVEなどに対応)、Graviton2がNeoverse N1(bf16には非対応)とされています。なお、Graviton3は本来SVE(ベクトル演算の命令)にも対応していますが、今回のmicroVMでは、0xd40でもsveがFalseでした。microVMの中では一部の命令が見えないようにしている可能性がありますが、理由は確認できていません。
公式ドキュメント:AWS Graviton Technical Guide
CPUの種類ごとにスナップショットを用意しているのだと考えると、この挙動は自然です。一般に、メモリの状態を丸ごと保存するスナップショットは、取ったときと同じ種類のCPUで復元するのが安全だからです(V2がCPUの種類ごとに起動処理を走らせることは、公式ドキュメントでは確認できませんでした。今回のログから読み取った挙動です)。
問題は、Graviton2にはbf16の命令がないことです(1章で紹介したus-east-1の先行記事でも、microVMのCPUがNeoverse N1で、bf16の命令がないと報告されています)。ステップ2のポイント③で、メモリに収めるためにbf16のまま動かすことにしましたが、bf16の命令がないCPUでは、bf16の行列計算が極端に遅くなります。そのため、Graviton2側のウォームアップが120秒に間に合わず、ランタイムの作成全体が失敗していました。
原因を絞り込むために、次のことも確かめました。
- プロセスが不正な命令で落ちたのではない:
faulthandlerの出力がなかったので、時間切れで止められたと考えられます - PyTorchの命令セットの選び方は関係ない:
torch_capabilityは、どちらのCPUでもDEFAULTでした。PyTorchやOpenBLASのCPU別の最適化を止める設定(ATEN_CPU_CAPABILITY=default、OPENBLAS_CORETYPE=ARMV8)でも作り直しましたが、結果は同じでした。原因は命令セットではなく、bf16という数値の形式そのものです - Graviton2だけfp32にする案は、手元では余裕がなかった:埋め込みの表(約5億パラメータ)だけbf16のまま残し、残り(約14億)をfp32にする方法を、手元のDocker(2vCPU・8GB)で試しました。メモリ(RSS)が7.7〜8.0GiBと上限ぎりぎりになり、2回目は起動処理に135.5秒かかったため、今回は見送りました。なお、1章で紹介したeu-west-1の先行記事では、1層ずつfp32に変換する方法で、AgentCoreのmicroVMの8GBに収めたと報告されています。変換のしかたを工夫すれば、Graviton2の対策になる可能性があります
5-3. V1:待機中のmicroVMと、Graviton2の扱い
では、V1ではどうだったのでしょうか。V1は作成でき、呼び出しにも応答しました。ログを見ると、V1にも興味深い挙動がありました。
作成直後から、microVMを10個起動して待機させていた
V1のランタイムを作った直後、セッションをまだ1つも呼び出していないのに、
[init]のログが10個分出ていました。V1は、新しいセッションに備えて、起動処理まで済ませたmicroVMを待機させているようです。実際、作成から約11分後に新しいセッションで1回呼び出すと、6.55秒(うち推論2.86秒)で応答が返り、seconds_since_initは692秒でした。11分前に起動処理を終えたmicroVMが、そのまま割り当てられたということです。1章で紹介した先行記事でも、eu-west-1では起動済みのmicroVMが使われていると推測されている一方、us-east-1では新しいセッションのたびに約70秒かかっていました。リージョンや時期、構成によって挙動が違う可能性があるので、待機中のmicroVMがいつもあるとは限らないと考えておくのが安全です。
V1でも、Graviton2のmicroVMはDeciderを起動できない
ステップ2のCPUの情報を出すイメージで、V1のmicroVMごとの結果を集計しました(作成から計測後までに起動した30個)。
| CPU | 個数 | S3からの取得 | ウォームアップ | 起動処理の合計 | 結果 |
|---|---|---|---|---|---|
0xd40(Graviton3) | 25 | 14.4〜23.7秒 | 3.9〜4.4秒 | 25.0〜34.6秒 | すべてapp.runまで到達 |
0xd0c(Graviton2) | 5(約17%) | 17.9〜19.1秒 | 終わらない | ― | すべてbf16非対応の警告のあと、止まった |
V1でも、Graviton2に当たったmicroVMは、1つも起動処理を終えられませんでした。今回の環境では、microVMの約6台に1台がGraviton2でした。
同時に呼び出すと、V1でも失敗することがある
ステップ7の15個同時の呼び出しを、2回行った結果がこちらです(作成直後に待機していたmicroVMは10個)。
| グループ | 1回目 | 2回目 |
|---|---|---|
| 待機中のmicroVMに割り当て | 10件、4.5〜7.4秒 | 10件、3.3〜6.3秒 |
| 新しく起動したmicroVMに割り当て | 3件、42.3〜44.2秒 | 4件、40.5〜44.8秒 |
| 失敗(120秒の制限を超えた) | 2件 | 1件 |
| 新しく起動したmicroVMのうちGraviton2 | 3個(起動処理が終わらない) | 2個(起動処理が終わらない) |
成功したリクエストは、すべてGraviton3で処理されていました。一方で、失敗した件数は、どちらの回も、新しく起動したGraviton2の個数とほぼ同じでした。V1は、待機中や起動を終えたGraviton3にリクエストを回しますが、Graviton2に当たったリクエストは、起動処理が終わらないまま120秒の制限を超えて、呼び出し側にエラーとして返ることがあります。

2回目の計測で起動したGraviton2のmicroVMのログです(時刻はUTC)。
0xd0cで起動処理が始まり、bf16の警告のあと、app.runが出ないまま止まっています。なお、前日に同じ構成で計測したときは、15個同時でも失敗は0件でした。Graviton2に当たるかどうかは運しだいで、同時に呼び出す数が多いほど当たりやすくなります。ログを見ないと、失敗の原因がCPUの種類だとは気づけません。
5-4. S3から取得すると、起動が速くなり、失敗が減った
モデルのファイルをHugging Faceから取得していたときと、S3から取得したときを比べると、次のようになりました。
| 項目 | Hugging Faceから取得(PUBLIC) | S3から取得(VPC) |
|---|---|---|
| モデルのファイルの取得(4.45GiB) | 読み込みと合わせて24〜90秒 | 15〜20秒(10個同時でも) |
| 起動処理の合計(Python側) | 32〜98秒 | 約25〜35秒 |
| 15個同時:失敗した件数 | 4件 | 0〜2件(3回計測) |
Hugging Faceから取得していたときは、同時に起動するほどダウンロードが遅くなり、Graviton2で止まった分を補いきれないうちに120秒の制限(
Runtime initialization time exceeded. Please make sure that initialization completes in 120s.)を超えて失敗していました。S3から取得するようにしたことで、Graviton3の起動が速くなり、失敗は減りました。ただし、5-3のとおり、Graviton2に当たった分の失敗は、S3にしても残ります。補足:推論そのものの時間は、AWS上のmicroVM(Graviton3)で2.4〜2.9秒でした。手元のMacのDocker(2vCPU)の8.6秒より速いものの、CPUで動かす以上、1問あたり数秒かかります。
6. 【考察】microVMでDeciderを動かすときの判断軸
V2が向いているもの、向いていないもの
V2の「起動時の状態をスナップショットにする」仕組み自体は、魅力的です。ただ今回の検証から、V2は作成時に、種類の違うCPUで起動処理を走らせ、そのどれもが120秒以内に終わる必要があることが分かりました。
| ワークロード | V2との相性 | 理由 |
|---|---|---|
| LLMをAPIで呼ぶエージェント(重い計算をしない) | 良い | 起動処理がCPUの種類に左右されにくい |
| 小さなモデルをfp32で動かす | 良い見込み | Graviton2でもfp32なら遅くなりにくい(未検証)。8GBに収まれば問題になりにくい |
| bf16の大きめのモデル(今回のDecider) | 悪い | Graviton2ではbf16の計算が極端に遅く、起動処理が120秒に間に合わない |
V1は、起動を終えたmicroVMにリクエストを回すので、多くの呼び出しは成功します。ただし、Graviton2に当たったリクエストは失敗することがあり(5-3)、Graviton2で止まったmicroVMは、無駄に起動されては止まることを繰り返しています。
V2でDeciderを動かしたい場合は、Graviton2でも速く計算できる数値の形式に変えるのが次の一手になりそうです。1章で紹介したus-east-1の先行記事では、線形の層をint8に量子化して、Graviton2のmicroVMで動かしています(1問あたり約7.6秒)。今回はV2で試していないので、効果は未検証です。量子化すると判定の数値が少し変わることもあるので、試す場合は、bf16のときと判定を比べてから使うのがおすすめです。
使い分けの整理
| やりたいこと | 向いている構成 |
|---|---|
| ユーザーを待たせない判定(バックグラウンドの仕分け、バッチ処理)を、使った分だけの料金で | microVM+V1。モデルのファイルはS3から取得して、起動を短くする |
| ユーザーが待つ、1秒以内の判定(エージェントがツールを呼ぶ直前に、呼んでよいかをチェックする、など) | GPUのインスタンス。ハードウェアを選べるAgentCore Runtime instancesなど |
| 「このツールを使ってよいか」という権限の判定 | AgentCore Policy(AgentCore Gateway経由のツール呼び出しを、ルールで決定的に判定する) |
補足:AgentCore PolicyとDeciderは、役割が違います。Policyは「この人がこのツールを使ってよいか」という権限を、ルールで決定的に判定します。Deciderは「今この引数でツールを呼ぶべきか」という判断の質を、会話の内容から確率で判定します。どちらか一方ではなく、組み合わせて使うものです。
今回の一番の学びは、「サーバーレスでも、下で動いているハードウェアは均一とは限らない」ことでした。microVMでは、CPUの種類を選べません。CPUの命令セットに依存する処理(今回はbf16)を使うなら、どのCPUに割り当てられても動くかを、ログで確かめておく必要があります。
7. 【料金】V1とV2の課金の考え方
AgentCore Runtime(microVM)の料金
AgentCore Runtimeは、microVMのCPUとメモリの実際の消費量に応じて、1秒単位で課金されます。
| 項目 | V1 | V2(従量) |
|---|---|---|
| CPU | $0.0895 / vCPU時間 | $0.1276 / vCPU時間 |
| メモリ | $0.00945 / GB時間 | $0.0169 / GB時間 |
課金のルールは、次のとおりです。
- microVMの準備ができてから、起動処理・処理中・アイドル中を経て、セッションが終わるまでが課金の対象です
- LLMの応答やツールの呼び出しを待っている間(I/O待ち)は、CPUは課金されません
- メモリは最低128MBから課金されます
- V2では、使われていないメモリは120秒で回収され、回収されるまで課金されます
- V2には、割引のある「コミット型」の料金(CPU $0.0997 / vCPU時間、メモリ $0.0132 / GB時間)もあります
注意:料金ページには、待機中のmicroVM(V1が作成直後から起動していたもの)や、ヘルスチェックに失敗したmicroVMが課金されるかどうかの記載はありませんでした。V1で多くのmicroVMが無駄に起動されるワークロードでは、請求額を確認しておくことをおすすめします。
8. 【注意点】利用上の注意
microVMのCPUは選べない
今回いちばん大きな注意点です。microVMでは、Graviton3とGraviton2のように、種類の違うCPUに割り当てられることがあります。今回の環境では、約6台に1台がGraviton2でした。bf16のように、CPUの命令に依存する処理を使う場合は、次のことを確かめておくと安心です。
- 起動時に
/proc/cpuinfoのCPU partとFeaturesをログに出し、どのCPUで動いたかを記録する - V2を使うなら、どの種類のCPUでも、起動処理が120秒以内に終わることを確かめる
- bf16の命令がないCPU(Graviton2)でも速く計算できるよう、int8への量子化などを検討する(今回は未検証)
V2で気をつけるコードの書き方
V2では、起動時に作った値がスナップショットに入り、すべてのセッションで共有されます。公式ドキュメントでは、次のような値は起動時ではなく、リクエストの処理の中で作るよう案内されています。
| 値 | 起動時に作ると起きること |
|---|---|
| 乱数・ID・トークン | すべてのセッションで同じ値になる |
| 現在時刻・経過時間の基準 | スナップショットを取った時刻のまま固定される |
| 期限のある認証情報 | セッションが始まる前に期限が切れていることがある |
| ホスト名・PID | すべてのセッションで同じ(localhost、1)になる |
逆に、モデルの重みのように「デプロイしたときだけ変わってほしい値」は、起動時に読み込むのが合っています。
モデルのバージョンは固定して、意図して上げる
本番運用では、モデルのファイルを自分のAmazon S3バケットに置いておくと、起動のたびに外部のサービスへ取りに行かずに済みます。ここで気になるのが、「S3に置いたモデルのファイルが古くなったら、どうやって最新版に保つか」です。
今回調べた範囲では、Hugging FaceのモデルをS3に自動で同期するAWSのマネージド機能は見つかりませんでした(ECRのプルスルーキャッシュも、Hugging Faceは対象外です)。そのため、仕組みは自分で用意することになります。
ただ、その前に考えておきたいのが、本番では「常に最新版」に追従させるより、「バージョンを固定して、上げるときは意図して上げる」ほうが安全だという点です。Deciderのような判定モデルは、版が変わると、同じ入力に対する判定が変わることがあります。知らないうちに最新版に切り替わると、「昨日まで通っていた判定が、今日は止められる」といったことが起きかねません。
そこで、次のような運用をおすすめします。
| 要素 | やり方 |
|---|---|
| 版の固定 | Hugging Faceのコミット(revision)を指定して取得する。今回のhf_to_s3.pyのように、S3にはコミットIDごとに置き場所を分け、取り込み時にハッシュを照合してメタデータに残す |
| 更新の検知 | Amazon EventBridge Schedulerで定期的にジョブを動かし、Hugging Faceの最新のコミットを確認する。変わっていたら、新しい版をS3の別の置き場所にコピーして、Amazon SNSで通知する。モデルのファイルは約4.5GBあるので、ジョブはAWS LambdaよりAWS CodeBuildなどが向いている |
| 切り替え | 新しい版で判定を確認してから、ランタイムの環境変数(使うコミットID)を更新する |
9. まとめ
今回は、判定専用の小さなモデル「Strands Decider 2B」を、AgentCore RuntimeのV1とV2に同じコンテナで載せて、新しいセッションの立ち上がりを比べました。
結果は、当初の期待とは違うものでした。
- V2では、Deciderのランタイムを作れませんでした。V2は作成時に、Graviton3とGraviton2という種類の違うCPUで起動処理を走らせます。bf16の命令がないGraviton2では、bf16のDeciderのウォームアップが120秒に間に合わず、作成全体が失敗しました
- V1は動きました。作成直後から起動処理を済ませたmicroVMを待機させていて、その範囲なら新しいセッションでも約3〜7秒で応答します。ただし、V1でもGraviton2のmicroVMはDeciderを起動できず、同時に呼び出したときに、そこに当たったリクエストは120秒の制限を超えて失敗しました(15個同時で0〜2件)
- モデルのファイルをS3に置くと、起動が速く、安定しました。Hugging Faceから取得していたときに比べて起動処理は約25〜35秒に縮み、15個同時の呼び出しでの失敗も減りました
実務での使い分けとしては、次のように考えています。
- 1秒以内に判定したいなら、ハードウェアを選べるGPUのインスタンス(AgentCore Runtime instancesなど)
- 使った分だけの料金で、ユーザーを待たせない判定をするなら、microVM+V1。モデルのファイルは同じリージョンのS3から取得する
- V2は、CPUの種類に依存する重い処理を起動時に行うワークロードには、今のところ向いていない
そして何より、「サーバーレスでも、下で動いているハードウェアは均一とは限らない」こと、そしてそれを確かめるには、起動時にCPUの情報をログに残しておくのが有効だということを、身をもって学びました。
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article