
Por Qué Falló DynamoDB en Octubre de 2025
El lunes 20 de octubre muchos equipos se despertaron con la región us-east-1 de AWS caída. El fallo fue rastreado a los DNS de DynamoDB. En este artículo exploraremos en profundidad por qué fallaron los DNS de DynamoDB.
El lunes 20 de octubre, muchos equipos se despertaron con sus beepers en lugar de sus alarmas. AWS estaba caído, y una gran parte de internet cayó con él. ¿La causa? DNS, obviamente. Siempre es DNS. Pero profundicemos en esto, porque es bastante interesante cómo DynamoDB (el servicio afectado, que resultó en una falla en cascada) maneja DNS.
Esto se basa en el postmortem detallado que AWS publicó solo tres días después del incidente. Felicitaciones al equipo de AWS, la última vez que esto pasó (2023, con AWS Lambda) les tomó 4 meses publicar un postmortem .
Volviendo a esta interrupción. Sí, fue DNS. Específicamente, fue una falla en el DNS de DynamoDB , una base de datos NoSQL serverless que es un servicio fundamental para AWS (lo que significa que muchos otros servicios de AWS dependen de él). En esta interrupción, la dirección
dynamodb.us-east-1.amazonaws.com comenzó a devolver un registro DNS vacío, haciendo que otros servicios fueran incapaces de conectarse a DynamoDB. Cuando digo "otros servicios", me refiero tanto a tu propia función Lambda tratando de acceder a tu tabla, como a otros servicios de AWS que usan DynamoDB internamente. Echemos un vistazo a cómo DynamoDB maneja su DNS para entender cómo falló y por qué.Cómo DynamoDB Maneja DNS

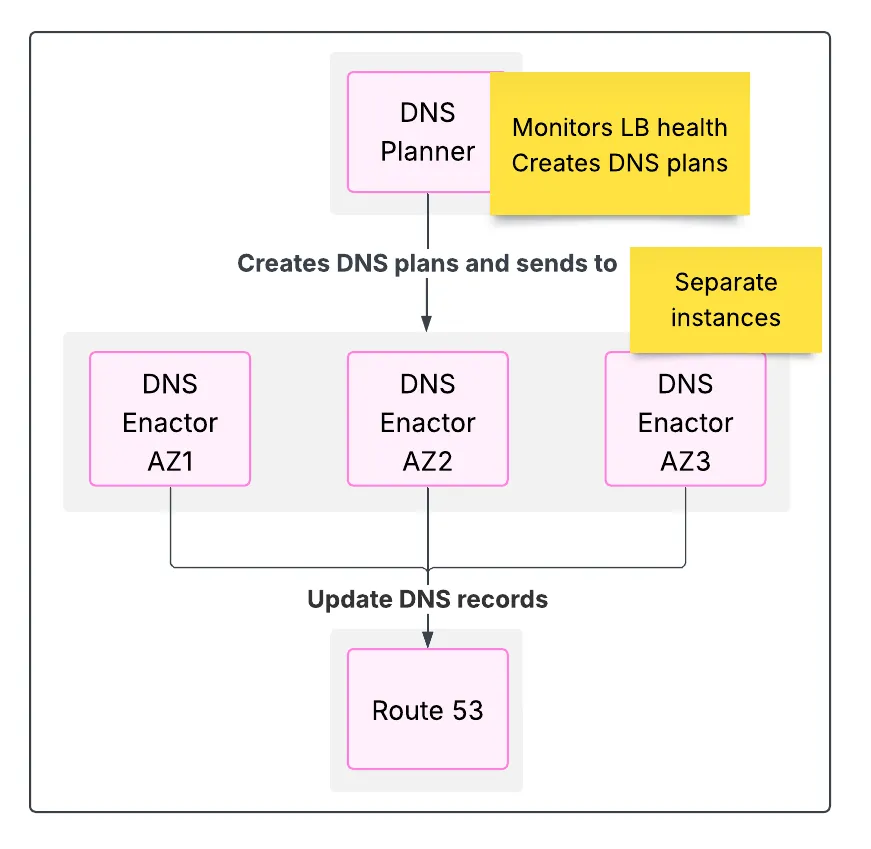
Por razones de disponibilidad, hay dos componentes:
- El DNS Planner monitorea la salud y capacidad de los muchos load balancers que necesitan recibir el tráfico, y periódicamente crea un nuevo plan DNS que consiste en un conjunto de load balancers y pesos. No aplica el plan, solo lo crea.
- El DNS Enactor aplica los cambios requeridos a Amazon Route53 siguiendo el plan DNS. Este componente opera tres copias completamente independientes, una en cada Availability Zone. Cada instancia del Enactor aplica lo siguiente:
- Recibir un nuevo plan del DNS Planner
- Actualizar los registros de Route53 según el plan recibido, usando transacciones de Route53. Esto incluye lógica de reintentos.
- Limpiar registros DNS que son parte de planes DNS antiguos
Con 3 Enactors corriendo en paralelo, deberían esperarse condiciones de carrera (race conditions). Se manejan mediante consistencia eventual: Un DNS Enactor puede aplicar un plan antiguo, pero como se espera que las actualizaciones ocurran rápidamente y hay un paso de limpieza, el siguiente Enactor que corre puede actualizar los registros con el plan más nuevo.
Cómo Falló el DNS de DynamoDB
La falla resultó de varios eventos improbables ocurriendo al mismo tiempo:
- DNS Enactor #1 experimentó retrasos significativos debido a contención de locks
- DNS Planner produjo nuevos planes a una tasa más alta de lo usual
- DNS Enactor #2 procesó estos nuevos planes a una tasa sorprendentemente alta
Aquí está la cronología, y cómo esos tres eventos independientes se combinaron en un escenario de falla:
- Enactor 1 comenzó a aplicar un plan DNS. Mucha contención de locks, esto tomó un tiempo
- DNS Planner generó muchos planes más nuevos, haciendo obsoleto el plan que Enactor 1 todavía estaba aplicando
- Enactor 2 comenzó a aplicar un plan más nuevo y válido
- Enactor 1 continuó aplicando su plan antiguo, sobrescribiendo los registros DNS que Enactor 2 acababa de escribir
- Enactor 2 terminó de aplicar el plan más nuevo y válido
- Enactor 1 terminó de aplicar el plan que tenía (para entonces antiguo e inválido), efectivamente sobrescribiendo el plan más nuevo y válido que Enactor 2 había aplicado
- Enactor 2 ejecutó su rutina de limpieza: Eliminar registros que no son parte de un plan válido. Esto significó que eliminó todos los registros DNS, ya que todos los registros DNS eran del plan antiguo que Enactor 1 había estado aplicando
- Ejecuciones posteriores de instancias de Enactor no pudieron manejar el estado inconsistente de registros DNS vacíos, por lo que fallaron al aplicar planes más nuevos y válidos
Con ningún registro DNS, las consultas DNS para
dynamodb.us-east-1.amazonaws.com estaban devolviendo ningún resultado, y nadie podía conectarse a DynamoDB. Esto no fue un problema para los Enactors (ellos no se conectan a DynamoDB), pero era un estado inconsistente y no sabían cómo manejarlo, por lo que no pudieron aplicar nuevos planes DNS. Y así es como DynamoDB se rompió.
Cómo Arreglar DynamoDB
Entonces, ahora sabemos cómo DynamoDB se rompió. Y como muchos servicios de AWS dependen de él, esto tumbó una porción significativa de AWS, y una porción significativa de internet con él.
Las secciones anteriores se basaron en información confirmada por AWS a través de su postmortem de la interrupción. Lo que sigue son mis propias ideas, no respaldadas ni sancionadas por AWS. Con toda honestidad, estas ideas probablemente son incorrectas (si lo fueran, estaría trabajando en AWS). Hay tantos detalles a tener en cuenta cuando se trabaja en la escala asombrosa de AWS que la gran mayoría de nosotros nunca hemos enfrentado y nunca enfrentaremos, y estoy seguro de hacer un mal trabajo al respecto. Sin embargo, haré mi mejor esfuerzo para explicar por qué la mayoría de las ideas que suenan bien probablemente no funcionarán.
Idea 1: Un Solo Enactor
Puedes eliminar completamente las condiciones de carrera si tienes un solo Enactor. Esto definitivamente prevendría la falla que ocurrió en esta ocasión, pero expondría el DNS de DynamoDB a fallas de Availability Zone.
Imagina un escenario donde la Availability Zone que aloja el Enactor falla. Esto también significa que una porción significativa de los Load Balancers que corren detrás de DynamoDB estarán fallando, y sin un Enactor funcionando tus registros DNS no se actualizarán, enviando tráfico a endpoints que están fallando.
Podrías argumentar que esto puede arreglarse ejecutando múltiples copias del Enactor en una arquitectura primaria y de espera (standby). El problema con esto es que no puedes asumir que el Enactor primario siempre fallará de una manera detectable. Si comienza a fallar silenciosamente, no ejecutarás tu estrategia de failover y necesitarás vivir con registros DNS obsoletos, lo que a esta escala de decenas de miles de servidores significa perder una porción significativa de tu capacidad simplemente porque no puedes comunicarte con nuevas instancias, y solo te darás cuenta cuando se convierta en un problema significativo.
La única manera de detectar una falla silenciosa es con un proceso paralelo que verifique los resultados. Es decir, un segundo Enactor corriendo en paralelo. Y volvemos al problema original de lidiar con múltiples Enactors actuando concurrentemente.
Idea 2: Validar Continuamente el Plan
Un punto clave del problema que DynamoDB experimentó fue que el Enactor que estaba aplicando el plan antiguo solo realizó una vez la verificación de validez (o más bien obsolescencia) del plan. Si hubiera verificado de nuevo, se habría dado cuenta de que el plan estaba obsoleto y ya no era válido, y habría dejado de aplicarlo.
El problema con esto es qué tan rápido y qué tan seguido se espera que ocurran estas actualizaciones. Recuerda, estamos pensando en una escala que desconcierta completamente cada sistema que tú y yo hayamos construido alguna vez. El endpoint de DynamoDB us-east-1 recibe en una sola hora más tráfico que cualquier sistema que yo haya construido a lo largo de toda su vida.
Este cambio podría realmente funcionar. Incluso podríamos tener algún tipo de timeout, o timestamp de validez para el plan. Honestamente, no sé cuál sería el problema con esta idea, pero supongo que hay algo. Intentaré preguntarle a alguien en re:Invent, y los actualizaré sobre la respuesta.
Idea 3: Hacer que un Estado Inconsistente sea un Estado Válido
Eso suena auto-contradictorio, y quizás lo es. Pero en última instancia, esta idea propone no tratar de prevenir este modo de falla, sino más bien aceptar que esto o algo como esto volverá a ocurrir, y automatizar la remediación.
De la manera en que lo veo, el Enactor que corrió justo después de que todos los registros DNS habían sido limpiados sí sabía cuál era el estado deseado: El del plan que había recibido del DNS Planner. No sabía cómo lidiar con el estado actual de registros DNS vacíos, que en su "mente" no tenía sentido. Pero sabía cuál era el estado deseado. Podría simplemente haberlo aplicado.
O podría haber disparado una alarma notificando que no podía o no actualizaría los registros DNS, lo que no habría resuelto esto automáticamente, pero habría ahorrado al equipo de DynamoDB algo de tiempo tratando de encontrar la causa raíz.
Esto es lo que yo haría, si trabajara en AWS. Aceptaré algunos créditos de AWS por la idea 😀.
Reflexiones Finales
Si esperabas algún tipo de consejo multi-región, puedes leer mi artículo sobre Disaster Recovery . Esto no es sobre lo que tú y yo podemos hacer. Y realmente no es sobre lo que AWS debería hacer, como dije no tenemos la experiencia adecuada para trabajar en estos sistemas.
Esto es sobre usar nuestras cabezas y tratar de aprender nuestras propias lecciones de esto. Y honestamente, sobre divertirnos. La interrupción no fue divertida, pero aprender sobre cosas tecnológicas geniales ciertamente lo es.
Enjoyed reading this content? Let the author know!
Your likes, comments, shares, and saves help creators reach more builders.

Loading recommendations
Loading article